 Vorobeoff
Команда DeepSeek Harness показала, как научить агента работать с десятками задач одновременно и не требовать от человека следить за каждой сессией. 31 октября команда опубликовала статью «Super-agent Design Exploration» и выложила прототип dsh-superagent — агента для GitHub, который сам забирает задачи, работает в параллельных сессиях и пишет, только когда нужен человек.
Раньше агенты жили в одной сессии: одно окно — одна задача. Чтобы вести пять задач параллельно, нужно было держать пять окон и помнить, где что происходит. DeepSeek предлагает спрятать эту механику внутрь системы: человек видит одного помощника, а под капотом работают роутер и десятки изолированных воркеров. Идея не в новой модели, а в системной архитектуре вокруг неё.
Важный дисклеймер от авторов: статья — исследование инженерных идей, а код — прототип для проверки подхода, а не официальный продукт DeepSeek. Часть описанной архитектуры в прототипе ещё не реализована, и его нужно адаптировать перед использованием в своей среде.
Откуда взялся Super-agent и какую проблему он решает
Авторы начинают с простого наблюдения: за последний год агенты научились решать сложные задачи в одиночной сессии, но масштабирование на много задач упирается не в модель, а во внимание человека. По их оценке, один человек уверенно сопровождает 3–5 активных сессий одновременно. Дальше — путаница в контекстах и ручное переключение.
Если просто подключить локального агента к чатам через CLI или MCP, сохраняются три ограничения: блокировка внутри одной сессии, смешивание контекстов разных задач и остановка работы при выключении устройства. Новый класс применения — персональные ассистенты, которые постоянно слушают почту, календари и мессенджеры, — требует другого устройства.
DeepSeek формулирует четыре свойства такого агента:
- непрерывность — разговор продолжается через разные каналы, агент помнит смену решения от чата к pull request;
- эффективность — принимает следующую команду, не дожидаясь завершения предыдущей, ведёт несколько сложных задач параллельно;
- проактивность — сам замечает поводы для действия и молчит, когда вмешиваться не нужно;
- устойчивость — остаётся онлайн долго, переживает сбои и работает с реальным окружением разработчика.
Эти четыре свойства, по мнению команды, не укладываются в один ReAct-цикл. Нужна архитектура, знакомая по классическим компьютерным системам: планирование, кэширование, событийная модель и разделение хранения и вычислений.
Двухуровневая архитектура: один роутер, много воркеров
Ключевое решение — разделить «общаться с людьми и помнить общее» и «делать конкретную работу».
Роутер — долгоживущая сессия, которая принимает входящие события, ведёт глобальную память и раздаёт задачи. Команда специально не даёт роутеру выполнять работу напрямую и даже не всегда снабжает его инструментом командной строки. Задача роутера — понять, что происходит, и назначить исполнителя. По опыту авторов, для этой роли часто хватает более лёгкой модели — она быстрее и дешевле.
Воркеры — изолированные сессии с полным набором инструментов. Каждый получает одну задачу и работает в своём контексте, не мешая остальным. Именно воркеры создают субагентов, если задача распадается на шаги. Результаты воркеры возвращают роутеру, а тот уже отвечает человеку единым голосом. Так пользователь всегда говорит с одним ассистентом, хотя за кулисами задач может быть десяток.
Почему не просто «команда агентов»? В обычной команде лид разбивает одну сложную задачу на шаги и плотно координирует исполнителей. В Super-agent роутер не дробит задачу — он распределяет разные задачи между независимыми исполнителями. Это снижает нагрузку на центральный узел и убирает неопределённость, будет ли модель делегировать работу в каждом конкретном случае.
Внутренне оба уровня могут быть сложнее одной сессии. Роутер допускает фильтрацию без вызова модели и шардирование при росте нагрузки, воркер — собственные подкоманды. Но внешне система прячет сессии от пользователя: ими управляет платформа, а не человек. Разработчики прямо пишут, что ручное управление сессиями — наследие API языковых моделей, а не требование продукта.
События вместо промптов: как агент решает, на что реагировать
Входом для Super-agent становятся не промпты, а события — триггеры: сообщения в групповом чате, комментарии к коду, письма, напоминания календаря, результаты CI. Проблема в том, что в реальном чате полезных сигналов единицы на сотни сообщений, и проверять каждое дорогой моделью накладно.
DeepSeek вводит двухуровневую фильтрацию по аналогии с быстрым и медленным путём в системах:
- программные правила быстро отсекают шум по источнику, спискам групп, allow-листам пользователей и ботов;
- семантический слой в виде промпта решает, нужно ли действовать, уже на отфильтрованных кандидатах, и легко расширяется новыми правилами.
После фильтрации события нужно доставить к нужной сессии. Здесь работают механизм подписок и агентный харнесс как инфраструктура управления: первый триггер в треде проходит через роутер, создаёт воркера и подписку, а дальше сообщения того же треда идут напрямую к воркеру без участия роутера. Это экономит токены и снижает задержки.
Подписки работают в обе стороны: воркер может слушать несколько связанных тредов, а на один тред могут быть подписаны несколько воркеров. Когда задачи пересекаются в общем pull request, все подписчики видят новые события и могут сами обнаружить конфликт без отдельной коммуникации.
Отдельно команда описывает работу с контекстом. Вместо загрузки всего подряд в окно — принцип Inline и Spill из компиляторов: полезное сразу подгружать, лишнее оставлять за окном со ссылкой. На этой идее строится Chain of Recall — граф из ID триггеров, тредов и сессий, по которому модель шаг за шагом подтягивает нужный контекст. Так роутер не держит всю историю в памяти, но может вспомнить старую задачу, когда её упомянут в другом канале.
Четвёртый приём — спекулятивное исполнение. Агент может в фоне попробовать воспроизвести баг и найти исправление ещё до того, как люди договорятся о решении. Внутри DeepSeek такой режим уже работает в пользовательской группе: при обсуждении проблемы агент тихо проверяет её и открывает черновик pull request, только если нашёл простое исправление, иначе остаётся молчаливым. Похожий подход к проактивности мы видели у OpenAI Dots — агентов, которые постоянно работают в фоне и сами приходят с результатом.
Чтобы разговор не замирал: асинхронность и разделение окружений
Классический ReAct-цикл блокируется на время выполнения команды — пока инструмент не вернёт результат, агент не отвечает на новые сообщения. Для долгоживущего ассистента это неприемлемо.
DeepSeek решает это асинхронным циклом: вызовы разделены на start и stop, после старта агент сразу получает уведомление о запуске и продолжает диалог, а результат фоновой задачи приходит отдельным событием. Механизм уже есть в DeepSeek Harness, но по умолчанию выключен. Для групповых чатов команда добавляет простое правило — одно сообщение не длиннее 100 слов, чтобы не шуметь.
Вторая системная идея — разнести вычисления, состояние и окружение. Сессии и их история живут в облаке в эластичных контейнерах и базе, а реальное окружение — репозитории, локальные файлы, цепочки инструментов — остаётся на машине пользователя. На устройстве работает только лёгкий демон, который выполняет команды и возвращает результат.
Такой подход авторы сравнивают с идеей Anthropic «отделить мозг от рук»: харнесс остаётся без состояния, а доступ к окружениям подключается по требованию через единый интерфейс. Отличие DeepSeek — фокус на личных машинах, которые бывают офлайн, содержат незакоммиченные изменения и приватные учётки. Система должна уметь подхватить задачу, когда устройство снова в сети, и переключаться между окружениями по типу задачи.
Долгую стабильность поддерживает внешний Watchdog — отдельная сессия по расписанию, которая проверяет не только то, жив ли процесс, но и то, движется ли задача к цели. Если воркер застрял в петле, Watchdog пытается его поправить, а поддержка может спросить у него причину сбоя обычным языком. Это внешний контур управления, без которого любая долго работающая система рано или поздно деградирует.
Что показали первые замеры
Команда прогнала четыре конфигурации на синтетическом потоке из групповых чатов и CI: около 300 сообщений на прогон, из них около 20 реальных заявок на работу. Кодинг заменили задачами с искусственным временем ожидания; для каждого варианта провели пять прогонов.
| Конфигурация | p50 | p95 | Примечание |
|---|---|---|---|
Super-agent (роутер + воркеры) | 12,4 мин | 15,7 мин | полный прототип |
Одна сессия + субагент, нейтральный промпт | — | 29,5 мин | ни разу не делегировал |
Одна сессия + субагент, промпт «делегируй» | быстрее | медленнее Super-agent | делегировал в 4 из 5 |
Super-agent без прямой доставки | как у полного | как у полного | +30% решений роутера, +37% токенов |
Главный вывод из таблицы — не скорость сама по себе, а стабильность делегирования. С нейтральным промптом модель ни разу не отдала задачу субагенту и делала всё в главной сессии, постоянно прерываясь на новые сообщения. С настойчивым промптом стало лучше, но в одном из пяти прогонов модель всё равно решила, что задача «слишком маленькая», и сделала её сама — отсюда длинный хвост. Двухуровневая архитектура убирает этот выбор из промпта: роутер в принципе не делает работу, поэтому делегирование происходит системно.
Плата за параллельность — токены. Несколько независимых сессий читают кэш чаще одной. Без механизма прямой доставки роутер принимал на 30% больше решений, а чтение кэша выросло с 23,23 млн до 31,77 млн токенов за прогон. Авторы честно помечают результаты как предварительные: синтетические сообщения и замена реального кодинга не позволяют судить о качестве кода, только о планировании и маршрутизации.
Отдельный стресс-тест проверял батчинг роутера. При росте потока с 1 до 40 триггеров в минуту средний размер батча вырос с 1,0 до 2,8, время на запрос — с 2,5 до 3,9 секунды, а удельное время на одно решение упало с 6,4 до 1,6 секунды. То есть при всплеске очереди роутер естественно собирает события в пачку и отрабатывает их дешевле за счёт параллельного префилла. Для текущего размера команды одного роутера хватает без шардирования.
Что умеет прототип сегодня и как он устроен
Опубликованный код уже, чем статья: это проактивный кодинг-агент для одного GitHub-репозитория, опционально с Feishu как источником из чата, упакованный как бандл для DeepSeek Harness.
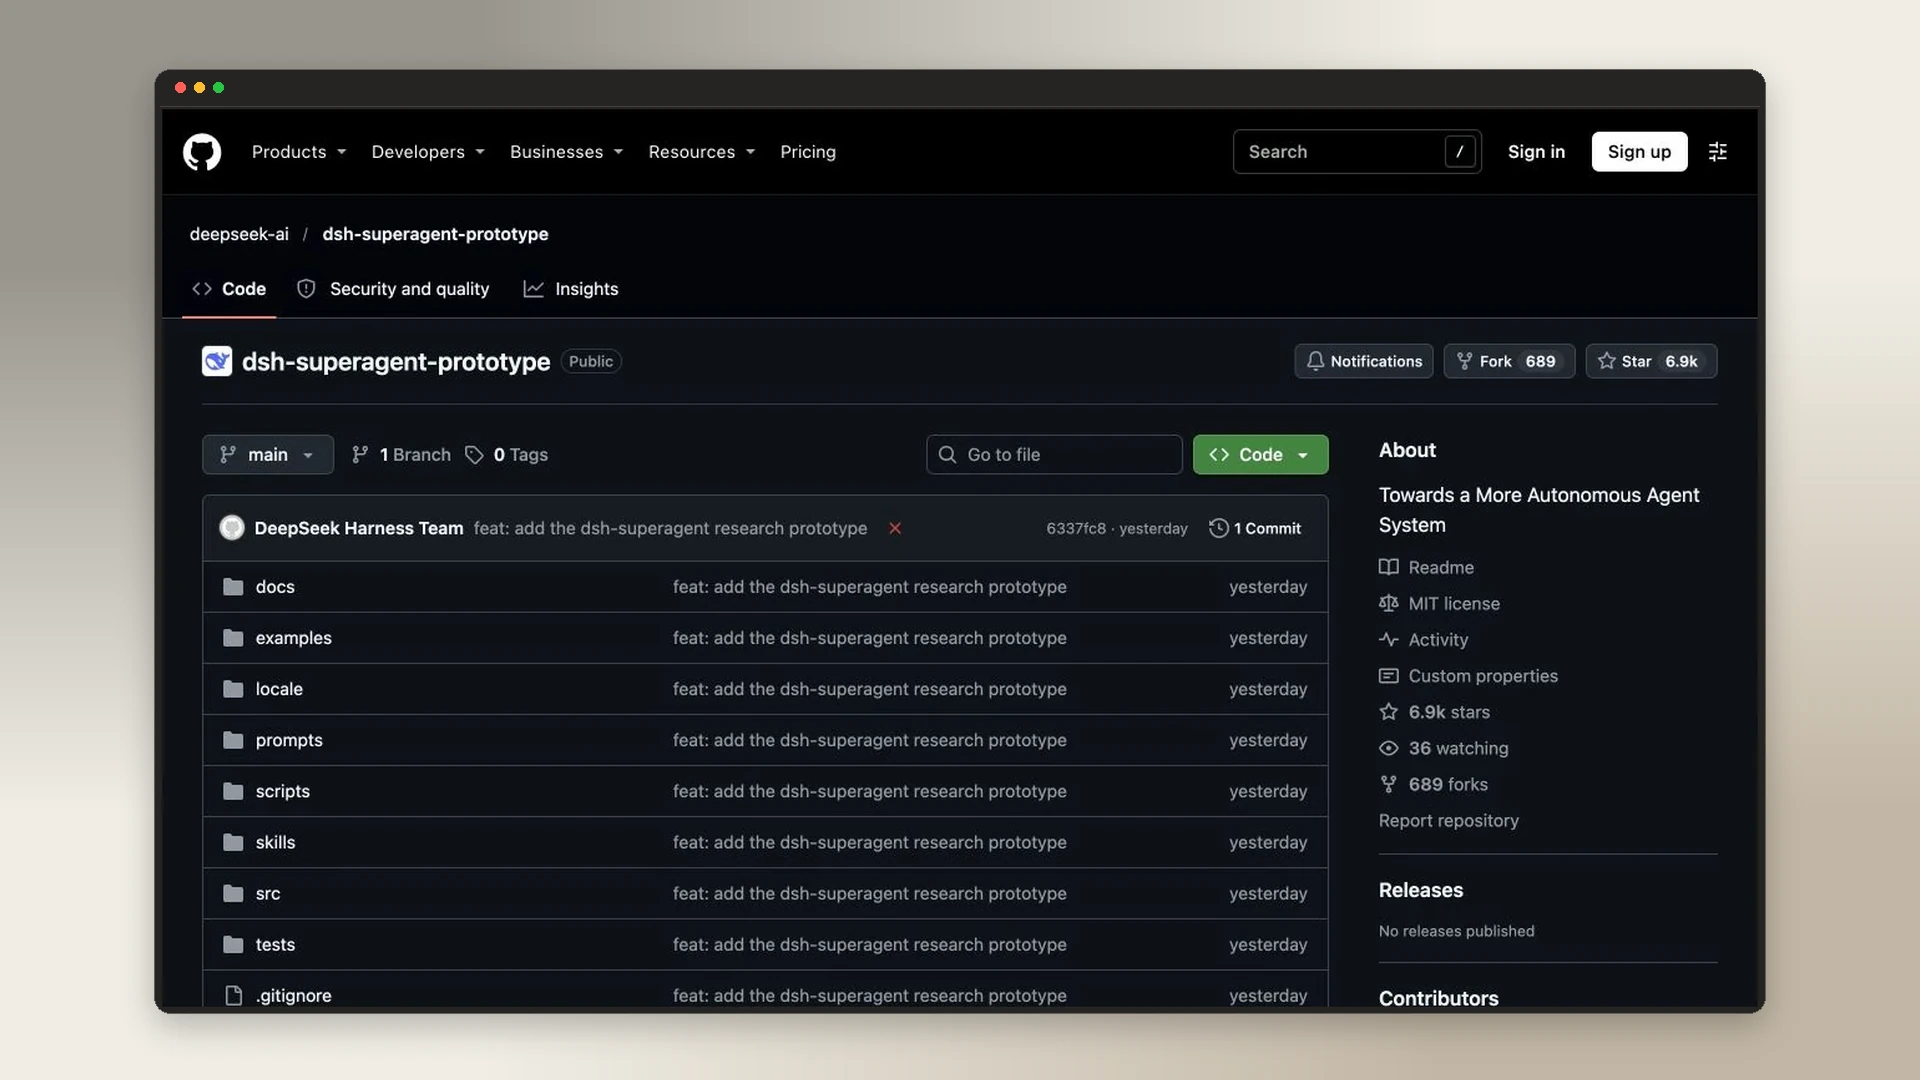
- Слушает GitHub и Feishu, реагирует только на разрешённых пользователей.
- На каждую заявку создаёт тикет с неизменяемым мандатом, работает в отдельной сессии и директории, отвечает в исходном обсуждении — чаще всего в pull request.
- Команды в фоне уходят через 5 секунд, поэтому воркер не теряет входящие сообщения.
- Веб-панель показывает только то, где нужен человек.
Установка необычная: её ведёт ваш собственный кодинг-агент по файлу SETUP.md — задаёт по одному короткому вопросу, показывает общий план и затем ставит зависимости. Требования: Node.js 22.19+ или 24+, git 2.32+, Python 3.8+, tmux и GitHub CLI 2.48+.
Вся документация разбита на пронумерованные заметки — от философии до развёртывания:
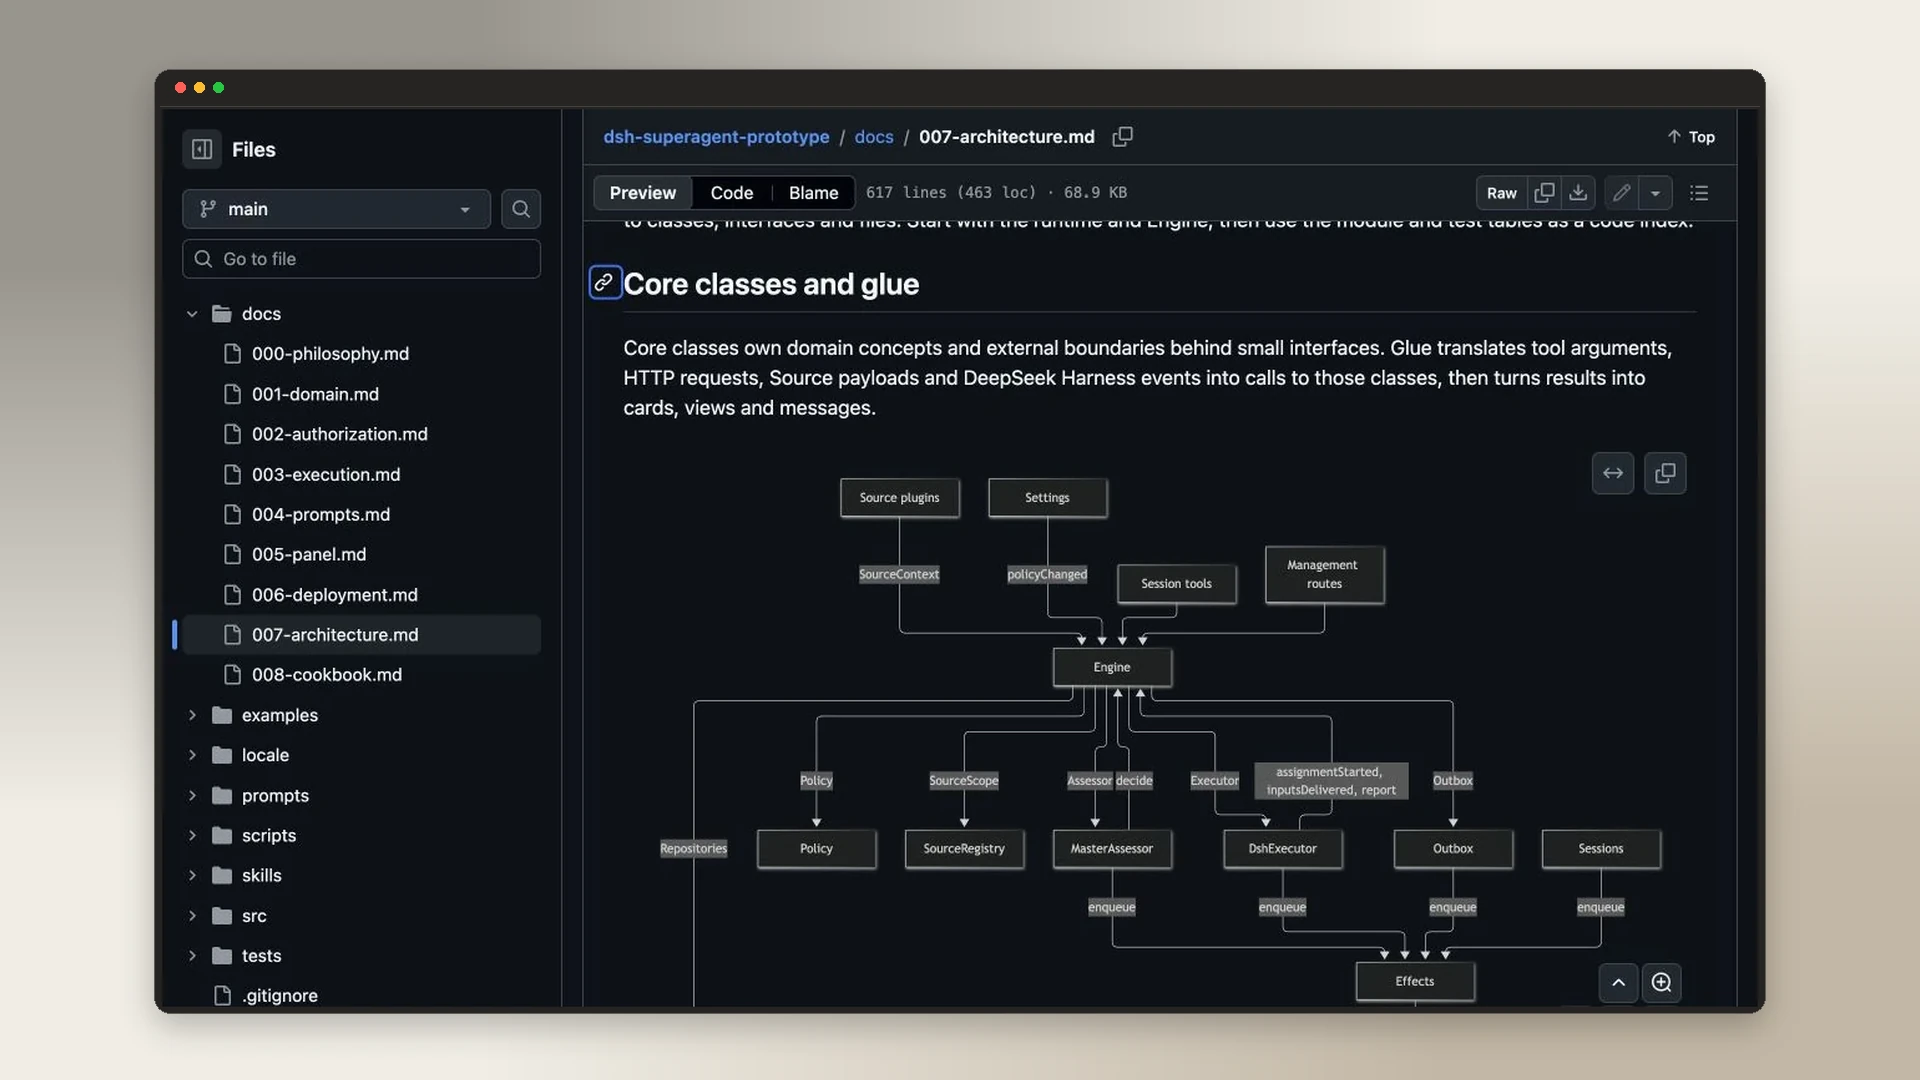
- 000 Philosophy — принцип «брать как можно меньше внимания человека и давать как можно больше пользы», правило «действовать только по просьбе или по записанному правилу» и предупреждение оператору «не использовать для накрутки объёма»;
- 001 Domain model — триггеры, тикеты и подписки как базовые сущности;
- 002 Authorization — режимы проактивности off / observe (по умолчанию, только запись намерений) / auto;
- 003 Execution — как уходят в фон команды и как воркеры подписываются на треды;
- 004–008 — промпты, панель, ручная установка, архитектура и добавление новых источников.
Лицензия — MIT, один коммит на момент публикации, 6,5 тыс. звёзд за первые сутки. Команда подчёркивает, что это исследовательский код, написанный во многом самими агентами, с возможными багами и неровным стилем.
Где тонкие места и что стоит проверить перед внедрением
DeepSeek честно перечисляет открытые вопросы, и их стоит учитывать при любой попытке повторить архитектуру.
- Масштабирование роутера. Один долгоживущий роутер пока справляется, но при росте числа задач и связей между ними понадобится шардирование и, возможно, общение между воркерами напрямую — как делить контекст между шардами, ещё предстоит проверить.
- Долгая память. Chain of Recall помогает вспомнить недавнее, но через недели и месяцы объём накопленной истории становится главным узким местом.
- Безопасность и приватность. Агент постоянно получает внешние события и через облако управляет локальными машинами. Компрометация облака означает риск для всех подключённых устройств. Отдельная задача — использовать учётки так, чтобы они никогда не попадали в контекст модели.
- Интерфейс вне сессий. Когда сессии перестают быть видимыми пользователю, нужно заново придумать, как показывать прогресс, давать возможность вмешаться и какие действия требуют обязательного подтверждения.
- Цена параллельности. Больше сессий означает больше токенов на чтение кэша — выигрыш во времени оплачивается инференсом. Для больших команд экономику нужно считать отдельно.
Дополнительный практический риск — сам прототип. Он работает с полными правами вашего пользователя и выполняет команды без подтверждения. Авторы советуют начинать с узкого allow-листа и режима observe для проактивных правил, и это разумный минимум. Любое расширение на production-репозиторий требует изоляции окружения и отдельного ревью правил.
Наконец, качество кода в тестах не измерялось. Замеры показывают, что система быстрее раздаёт задачи, но не доказывают, что сгенерированные исправления лучше, чем у одиночной сессии. Для внедрения это означает отдельный контур оценки качества — ревью, тесты и метрики по каждому типу задач.
Кому это полезно и с чего начать проверку
Super-agent имеет смысл там, где работа состоит из множества независимых заявок, которые приходят через разные каналы: внешние баг-репорты из чата, код-ревью в GitHub, заявки на доработку. Если команда ежедневно перекидывает информацию между мессенджером, трекером и репозиторием, архитектура с роутером снимает ручное переключение и снижает риск потерять контекст.
Для персонального ассистента тот же паттерн применим к почте, календарю и документам: один видимый собеседник, под капотом — отдельные воркеры на каждую тему. Но применять его стоит, только если у вас уже есть сформулированные правила, когда агенту можно действовать самому, а когда нужно спросить.
Проверять идею лучше на одном репозитории и без включения auto-режима:
- разверните прототип на тестовом репозитории с минимальным allow-листом и режимом observe для проактивных правил;
- прогоните 10–15 типовых задач — баг-репорт из чата, правка по комментарию к PR, мелкая фича — и сверьте, сколько тикетов создалось, сколько дошло до PR и сколько потребовало вмешательства;
- сравните время до первого осмысленного ответа, число решений роутера и расход токенов с аналогичными показателями вашей текущей схемы с одной сессией;
- отдельно проверьте безопасность: какие команды выполнялись, куда уходили данные и где хранятся токены GitHub и Feishu.
Если доля ложных срабатываний мала, а время до готовности PR заметно ниже при приемлемой цене инференса — расширяйте список правил и репозиториев. Если агент часто ошибается в выборе задачи — это сигнал уточнить программные фильтры и промпты роутера, а не увеличивать число воркеров.
Что меняет Super-agent за пределами одного релиза
DeepSeek не заявляет новую теорию. Команда применяет к агентам классические идеи из системного дизайна — планирование задач, управление кэшем, события, асинхронность, разделение вычислений и хранения, внешний контур надзора. Ценность в том, что эти идеи впервые собраны в цельную прикладную архитектуру для агентов и проверены на практике внутри компании — вплоть до того, что внутренний экземпляр сам участвует в доработке DeepSeek Harness.
Более широкий сдвиг — в вопросе продуктивности. Когда одна задача всё меньше требует пошагового контроля, узким местом становится не способность модели, а способность человека вести много задач сразу. Super-agent переносит администрирование сессий и синхронизацию контекста внутрь системы и оставляет человеку постановку целей и приёмку результата. Это тот же подход к долгосрочной памяти и автономной работе, который используют другие постоянно работающие агенты, но реализованный через открытую инженерную конструкцию, которую можно разобрать и повторить.
Будет ли такая схема нормой для командной разработки — зависит от двух вещей: научатся ли агенты долго помнить нужное без потери точности и удастся ли закрыть риски безопасности при связи облака с личными машинами. Пока DeepSeek предлагает проверить гипотезу малым контуром: один репозиторий, узкие правила, наблюдение за метриками. Если у вас есть процесс, где заявки регулярно приходят из чата и GitHub, опишите его в нескольких предложениях — помогу определить, где роутер действительно снимет ручную работу, а где достаточно простого фильтра и одной сессии.
Ссылки
- Сайт: DeepSeek-V4.1-Flash и обновления моделей — changelog
- GitHub: deepseek-ai/dsh-superagent-prototype
- Сайт: Перевод статьи DeepSeek Harness — Super-agent Design Exploration