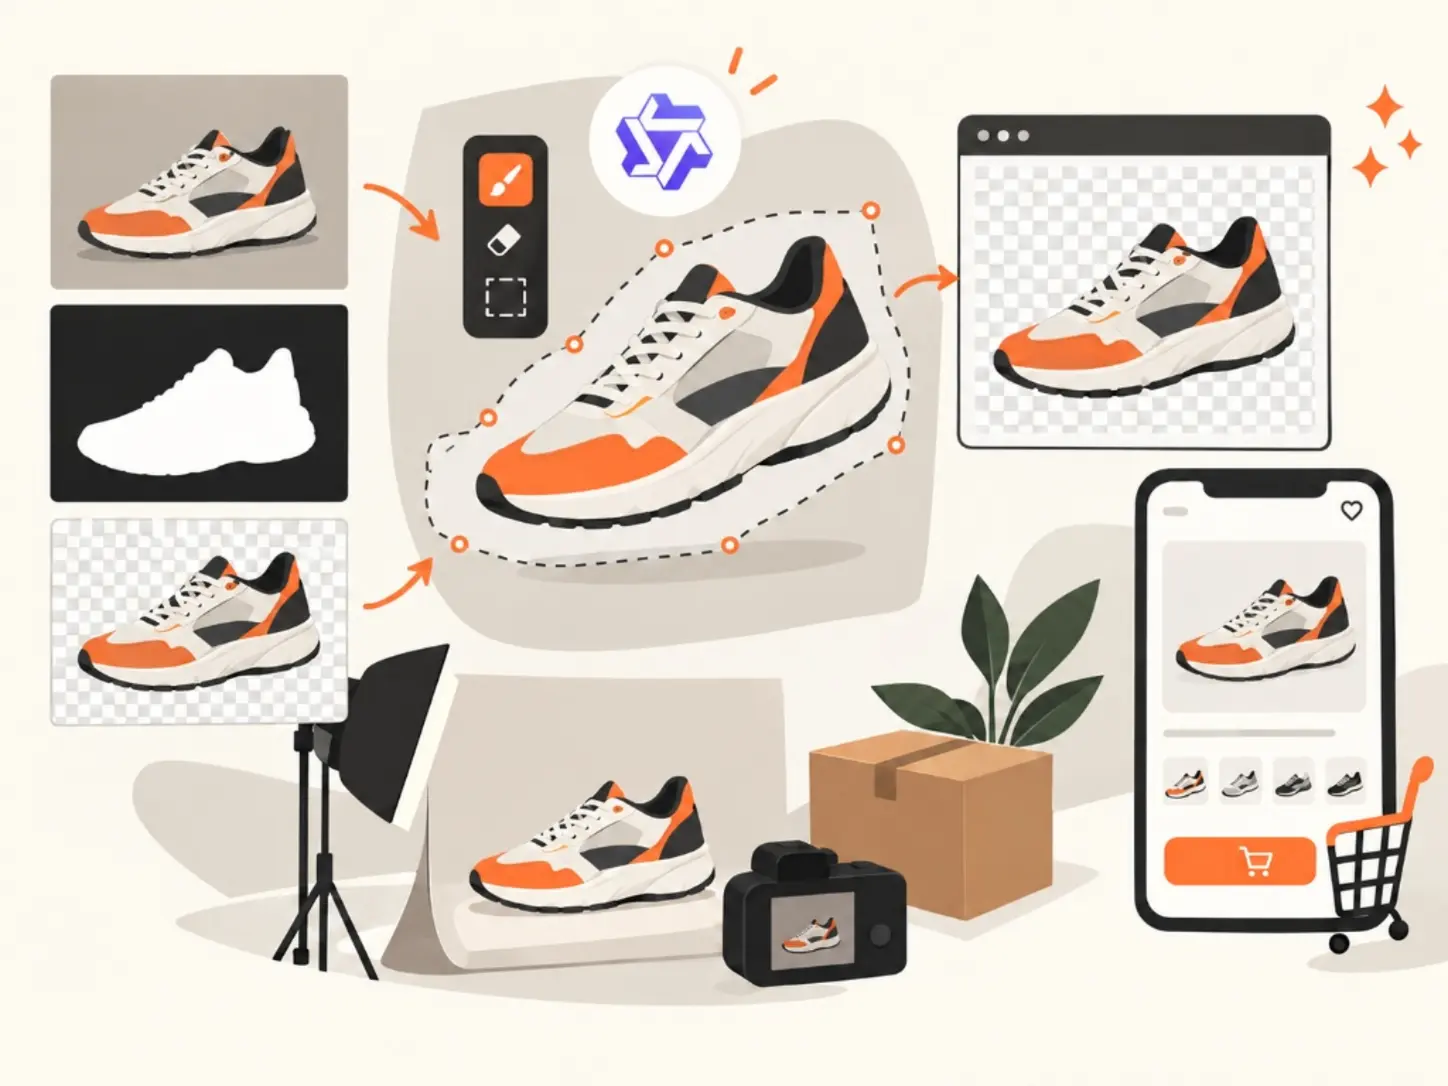
В подготовке графики для интернет-магазинов и маркетинга до сих пор держится одна и та же проблема: рабочий процесс разбит на зоопарк не связанных между собой сервисов. Чтобы собрать один товарный баннер, дизайнер сначала генерирует объект в одной нейросети, потом отправляет его в стороннюю утилиту вырезать фон, в третьей программе пытается заменить цвет или деталь, а в четвертой маскирует появившиеся артефакты. Любая мелкая правка от заказчика ломает композицию и заставляет начинать всю цепочку сначала.
В декабре 2025 года команда Qwen сделала первый шаг к решению этой проблемы, показав экспериментальную модель Qwen-Image-Layered для послойного разделения и генерации картинок на RGBA-слои. Теперь они пошли дальше и выложили Qwen-Image-2.1 — открытую модель, которая объединила генерацию с нуля, глубокое редактирование и нативную прозрачность внутри единого пайплайна.
Для продуктовых команд и e-commerce это практический сдвиг: один инструмент умеет создавать макет сразу на чистом прозрачном слое, заменять отдельные детали на фотографии и вырезать нужный объект без сторонних плагинов и вторичной сегментации.
Что внутри: компактный генератор вместо тяжеловесного стека
Главная инженерная особенность модели — ее размер. Визуальный генератор построен на 32 слоях Single-Stream DiT (Diffusion Transformer) и насчитывает 7 млрд параметров. По современным меркам это очень компактная диффузионная сеть: модели сравнимого класса генерации обычно весят в полтора-два раза больше. Фокус разработчиков понятен — сделать генератор быстрым, экономичным и пригодным для локального запуска на видеокартах с 16–24 ГБ видеопамяти уровня RTX 4090.
Чтобы ускорить работу и снизить расход VRAM при пакетной обработке, инженеры применили гибридное внимание (mixed-granularity attention) и повторное использование префиксного кэша ключей и значений (prefix KV cache reuse). Текстовые инструкции и входные картинки обрабатываются один раз и фиксируются в памяти, поэтому при многошаговой диффузии тяжелый пересчет контекста не повторяется.
На входе модель принимает до 10 исходных изображений одновременно, а на выходе формирует кадры с детализацией до 2K (базовое разрешение 2048 × 2048 пикселей с гибкой поддержкой соотношений сторон от 1:1 до 16:9).
Нативная прозрачность: почему это важно для продакшена
В стандартных графических пайплайнах прозрачный фон всегда был компромиссом. Модель выдает обычный RGB-кадр, а затем отдельная утилита сегментации (вроде rembg или BiRefNet) пытается отделить фон от объекта. На сложных границах — развевающихся волосах, шерсти, полупрозрачном стекле, бликах или размытых тенях — этот алгоритм неизбежно ошибается и оставляет рваные края.
В Qwen-Image-2.1 прозрачность встроена в саму диффузию через 16-канальный автоэнкодер, генерирующий полноценный четырехканальный RGBA-массив. Модель сама понимает из промпта, нужен ли прозрачный фон, и рассчитывает альфа-канал на уровне генерации каждого пикселя.
В документации зафиксирован рекомендуемый шаблон запроса для прозрачных изображений:
This is an RGBA image with transparency. A running sneaker on a clean surface. The image has alpha channel and the background is transparent.Это открывает три понятных рабочих сценария:
- Генерация готовых элементов дизайна: иконки, персонажи, интерфейсные плашки и иллюстрации сразу ложатся в верстку без ручной обтравки.
- Правка с сохранением прозрачного слоя: можно изменить эмоцию персонажа или заменить надпись на табличке, не потеряв при этом прозрачный альфа-канал вокруг него.
- Чистая вырезка объекта: модель способна принять готовую фотографию из каталога и изолировать нужный предмет в самостоятельный прозрачный слой.
Редактирование: сборка из десяти исходников и точечные маски
Возможности редактирования в Qwen-Image-2.1 сфокусированы на контроле за результатом:
- Мульти-референсная сборка. Модель умеет объединять в одной композиции до 10 исходных файлов. Например, из пяти отдельных фотографий (человек, рубашка, брюки, обувь и сумка) она собирает цельный лукбук, сохраняя фасон и фактуру вещей. Десять предметов мебели собираются в единый согласованный интерьер с общим освещением.
- Точечные области правок. Зону редактирования можно задать тремя путями: грубой обводкой контура, закрашиванием кистью прямо по кадру или передачей отдельного черно-белого файла маски. Последний вариант наиболее ценен для студийной работы, так как оставляет пиксели оригинального изображения абсолютно нетронутыми вокруг рабочей зоны.
- Сохранение идентичности. Модель удерживает черты лица между итерациями правок, а на предметных снимках корректно воспроизводит логотипы, геометрию упаковок и шрифтовые надписи.
- Композиционные трансформации: разворот селфи в панораму окружения, дорисовка ракурсов одного и того же объекта с разных сторон и быстрая генерация раскадровок.
Инсайт: главное отличие от предыдущих поколений inpainting — модель понимает семантику объекта в объеме. Если вы меняете ракурс или просите надеть куртку на персонажа с референса, складки ткани и тени ложатся с учетом анатомии, а не приклеиваются плоской текстурой поверх исходника.
Быстрый старт в коде через Diffusers
Интеграция в экосистему Hugging Face доступна сразу в день релиза через класс QwenImage21Pipeline. Базовый запуск инференса требует минимального объема кода:
import torch
from diffusers import QwenImage21Pipeline
from PIL import Image

# Инициализация пайплайна
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16
).to("cuda")

# 1. Генерация с прозрачным фоном (RGBA)
prompt_rgba = (
    "This is an RGBA image with transparency. "
    "A modern sport sneaker, dynamic angle, studio lighting. "
    "The image has alpha channel and the background is transparent."
)
rgba_image = pipe(
    prompt=prompt_rgba,
    width=2048,
    height=2048,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42)
).images[0]
rgba_image.save("sneaker_transparent.png")

# 2. Редактирование по изображению
input_img = Image.open("sneaker_transparent.png")
edited_image = pipe(
    prompt="Change the orange accents to bright cyan and add metallic finish",
    image=input_img,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42)
).images[0]
edited_image.save("sneaker_cyan.png")
Что это меняет в рабочих процессах
Для интернет-магазинов и маркетплейсов отпадает необходимость в многоступенчатом конвейере: генерация изолированного товара, оформление карточки с инфографикой и замена цвета или этикетки теперь выполняются внутри одной архитектуры.
Для создателей визуального контента упрощается путь от концепта до черновой анимации: удерживая фон и персонажа неизменными, можно серией пошаговых правок получить последовательность кадров с разными позами и выражениями лиц для быстрого сториборда.
Инфраструктура среагировала моментально: поддержка Qwen-Image-2.1 с первого дня доступна в экосистеме Hugging Face Diffusers, в ComfyUI (Comfy-Org/Qwen-Image-2.1), серверах инференса vLLM-Omni и SGLang, а также аппаратно оптимизирована под видеокарты AMD Radeon через ROCm и китайские чипы через стек FlagOS. Ждать неделями, пока сообщество напишет кастомные загрузчики, на этот раз не придется.
Кроме того, Alibaba продолжает укреплять репутацию главного поставщика открытых нейросетей: после сильных языковых релизов Qwen линейка генерации графики получает ту же архитектурную зрелость.
Где стоит остановиться и проверить риски
Перед тем как закладывать модель в боевые сервисы, обратите внимание на ключевые ограничения:
- Лицензия не является свободной Apache 2.0. Модель выпущена под Qwen Research License Agreement. Это разрешает некоммерческие тесты, научные эксперименты и прототипирование, но прямое использование в коммерческих продуктах и закрытых SaaS-сервисах требует отдельного лицензионного соглашения с Alibaba.
- Реальная чистота обтравки на сложных сценах. Заявленная нативная прозрачность отлично выглядит на контрастных объектах, однако поведение модели на сложном студийном свете, хромированных поверхностях и многослойных отражениях требует обязательной проверки на вашем реальном каталоге.
- Требования к инфраструктуре. Хотя генеративный блок занимает 7B параметров, полный пайплайн вместе с текстовым энкодером Qwen3-VL (8B) и опциональными адаптерами промптов требует от 16 до 24 ГБ быстрой видеопамяти. Для высоконагруженного потокового продакшена потребуется кластер серверов с vLLM-Omni или SGLang.
Qwen-Image-2.1 интересна именно как попытка ликвидировать разрыв между созданием картинки и ее доработкой. Когда обе задачи решает одна нейросеть, порог автоматизации графических задач заметно снижается. Тестирование модели стоит начинать не с полной перестройки продакшена, а с одного конкретного сценария — например, с пакетной вырезки предметов на прозрачный фон или генерации вариаций товара по маске — и прямого сравнения затрат по времени и качеству с вашим текущим процессом.
Ссылки
Ссылки
- Репозиторий: Qwen/Qwen-Image-2.1 — GitHub
- Модель и веса: Qwen/Qwen-Image-2.1 — Hugging Face
- Демо-стенд: Qwen-Image-2.1 Demo — Hugging Face Spaces