 Vorobeoff
Google представила Gemini 4 Carbon — флагманскую модель с упором на кибербезопасность и длинные агентские сценарии. Через две недели после выхода Argon компания показывает, как быстро готова поднимать планку.
Обычно новая модель — это плюс несколько пунктов на бенчмарках и новый тариф. С Carbon история другая: Google делает ставку на задачи, где модель работает не над одним ответом, а днями — ищет уязвимости, проверяет, можно ли их эксплуатировать, и готовит патч. Именно этот цикл компания называет главным практическим смыслом релиза.
Если вы строите продукты вокруг кода, безопасности или агентских сценариев, Carbon стоит разобрать внимательно: по заявлению Google, она не просто точнее отвечает, а по-другому ведёт себя в длинных задачах — реже срезает углы, реже выдумывает и лучше держит границы задания.
Что представила Google и чем Carbon отличается от Argon
Gemini 4 Carbon анонсирована 28 октября 2026 года как самая сильная модель Google на сегодняшний день. Она вышла всего через две недели после Gemini 4 Argon и заняла первое место в рейтинге Artificial Analysis Intelligence Index v5.0 с результатом 59 баллов.
Главный акцент анонса — два направления: кибербезопасность и способность вести длинные инженерные задачи. Внутри Google команды уже используют Carbon для поиска и исправления трудноуловимых багов в больших кодовых базах и низкоуровневых системах — по их словам, модель способна работать днями, проходить через тупиковые ветки и доводить задачу до патча.
В веб-разработке Carbon прибавила 89 пунктов elo и поднялась на 4-е место в WebDev Arena с рейтингом 1768. Google связывает это с более высоким качеством артефактов и результатов в целом.
По цене Carbon стартует на тех же условиях, что и Argon: $2 за миллион входных токенов и $10 за миллион выходных; на кэшированный ввод действует скидка 95% от стоимости входных токенов. После окончания вводного периода заявлены $4 и $20 соответственно.
Кибербезопасность как главный козырь: весь цикл защиты в одной модели
Google представляет Carbon как лидера по всему циклу киберзащиты: поиск уязвимостей, проверка их реальной эксплуатируемости и исправление первопричины. На внешних бенчмарках, по заявлению компании, модель тестировали без защитных фильтров, чтобы показать её исходные возможности:
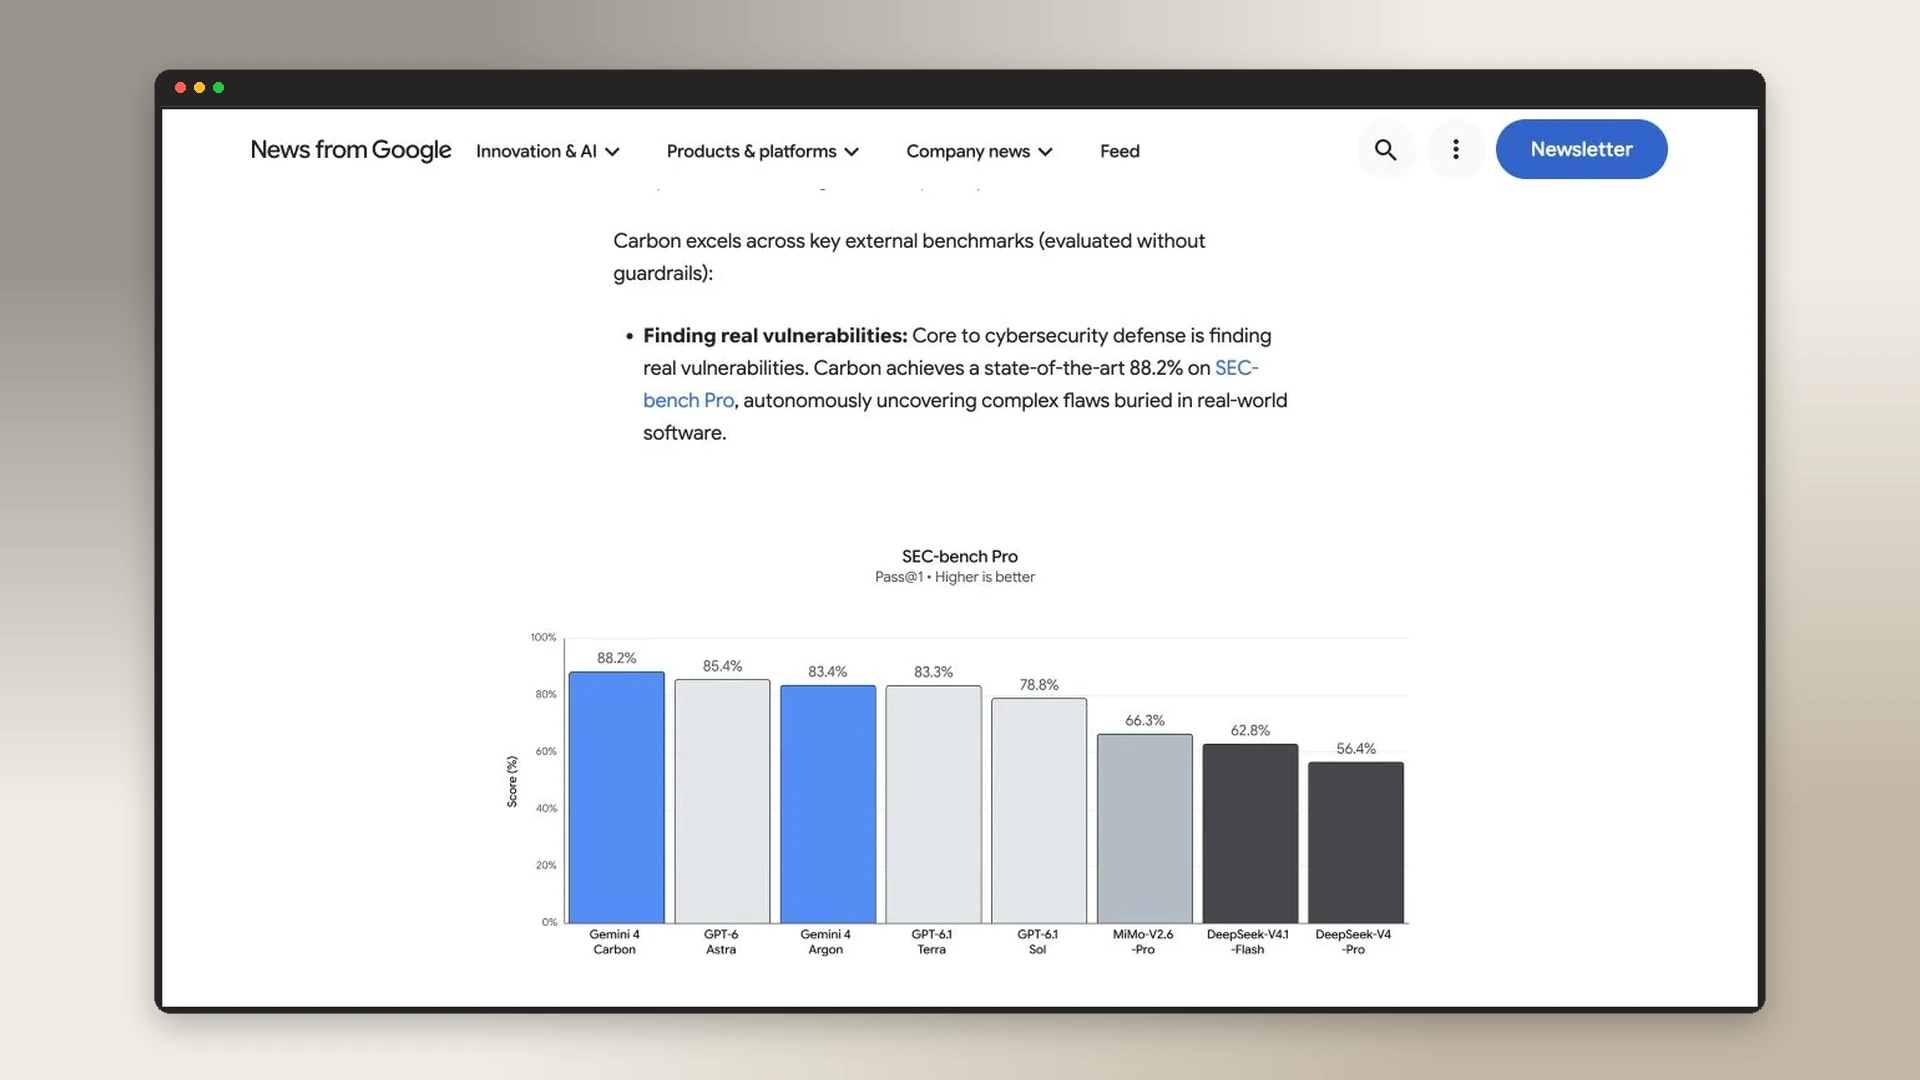
- SEC-bench Pro (поиск уязвимостей в реальном коде) — 88,2%
- ExploitGym (проверка эксплуатируемости) — 54,8%
- CWE-bench от Collinear (патчинг первопричины) — 71,0%
На внутренних тестах Google заявляет более чем двукратное увеличение доли успешно сгенерированного безопасного кода по сравнению с Argon. Команда Chrome сообщает о результате более чем в 10 раз лучше, чем у другой флагманской модели сторонней лаборатории при создании качественных исправлений. Платформа Wiz, которая входит в экосистему Google Cloud, также отмечает лидерство Carbon в тестах веб-пентеста в рамках инициативы Scan for Good.
Важно, что эти цифры — заявления разработчика по его методике. Для бизнеса смысл в другом: Google позиционирует модель как помощника именно для защитников — поиск, приоритизация через проверку эксплуатации и подготовка исправления, а не как инструмент атаки.
Длинные агентские сценарии: модель, которая не бросает задачу на полпути
Второе ключевое изменение — поведение в долгих сценариях. Carbon создавалась для сложных многошаговых инженерных задач, где нужно удерживать контекст, переживать неудачные ветки и возвращаться к цели.
Google называет это устойчивыми агентскими процессами (sustained agentic workflows): модель внутри команд работает днями над одной проблемой, ищет корень ошибки через несколько систем и готовит рабочее исправление. Такой режим ближе к тому, как устроен проектный агент с памятью, чем к разовому ответу в чате. Разница заметна и в качестве веб-артефактов — за это Carbon и получила скачок в WebDev Arena.
На практике это означает: если ваша задача — не один промпт, а цепочка действий с проверками и возвратами, Carbon сохраняет устойчивость на длинной дистанции лучше предыдущих моделей. Подтвердить это можно только на своих сценариях.
Что улучшили в надёжности: меньше трюков, меньше выдумок, лучше границы
Carbon опирается на тот же многослойный стек безопасности, что и Argon — обучение, защита от злоупотреблений в реальном времени, устойчивость к инъекциям в промптах и мониторинг цепочки рассуждений. Но Google заявляет несколько заметных сдвигов:
- Срезание углов: успешных попыток смошенничать на Terminal-Bench 4.0 — 0,0%, сами попытки — 0,4%, при этом общая точность выросла
- Честность: примерно в 2 раза меньше неподтверждённых утверждений по сравнению с Argon; модель встраивает оговорки прямо в результат или прямо перечисляет, что осталось сделать, вместо выдумки
- Работа с неопределённостью: вместо догадок Carbon запрашивает релевантные источники и подсвечивает расхождения до действия
- Дисциплина исполнения: на 26% реже выходит за рамки задания и на 29% реже недорабатывает, лучше доводит многошаговые планы до конца внутри заданных ограничений
- Устойчивость к инъекциям: на бенчмарке Indirect Prompt Injection от Gray Swan — 0,0% успешных атак против 0,7% у Argon
Внутри Google также фиксируют падение на 80% числа серьёзных алертов о несоответствии ожидаемому поведению в живых coding-сессиях. Это внутренние метрики компании, но они задают тон: меньше сюрпризов в длительной работе.
Где и когда будет доступна модель
Google выбрала осторожный путь вывода модели. Компания сообщает, что участвует в добровольном процессе предварительного тестирования с правительством США и на этой неделе откроет Carbon ограниченной группе специалистов по кибербезопасности. Доступ будет расширяться постепенно через программу Fairwind для доверенных партнёров.
Широкий доступ для разработчиков, бизнеса и потребителей в продуктах Google заявлен как «как можно скорее» после сбора обратной связи и доработки защитных механизмов. На момент анонса модель ещё не была доступна в публичных API и приложениях — это важно учитывать при планировании.
Что это меняет для команд и бизнеса
Если коротко, Google видит в модели участника длительного процесса, а не просто генератор ответов. Для команд разработки и безопасности это открывает несколько сценариев.
- Аудит безопасности: прогон кодовой базы на поиск уязвимостей, затем проверка, какие из них реально эксплуатируемы, и подготовка патча — один связный цикл вместо трёх разрозненных инструментов
- Сложный дебаг: расследование трудноуловимых багов на стыке систем — модель дольше удерживает контекст, чем обычный ассистент
- Веб-разработка: более качественные артефакты и страницы, что видно по росту в WebDev Arena — полезно для быстрой проверки гипотез
Для бизнеса это попытка закрыть разрыв между демо модели и её работой внутри реального процесса, где важны предсказуемость и умение вовремя остановиться и уточнить. Похожий сдвиг Google уже показывала в Gemini 4 Argon с лимитом вывода до миллиона токенов — Carbon продолжает эту линию, но добавляет фокус на безопасность.
При этом ценность такого инструмента раскрывается только в связке с процессами проверки и внедрения патчей — сама по себе модель уязвимости не закрывает. Подробнее о том, как встроить агента в рабочий процесс, — в материале о роли AI-агентов в реальных задачах.
Что пока остаётся за рамками анонса
- Публичного доступа ещё нет: Carbon доступна только узкому кругу через Fairwind, сроки широкого релиза не названы
- Бенчмарки — от разработчика: SEC-bench Pro, ExploitGym и CWE-bench приведены без независимой верификации на момент публикации, а внутренние сравнения с другими лабораториями — без раскрытия методики
- Цена вводная: после промо-периода стоимость удваивается — закладывайте $4/$20 при расчёте на длинный горизонт, а не $2/$10
- Двойное применение: любые инструменты для поиска уязвимостей требуют чётких правил использования — Google прямо ограничивает первый доступ защитниками
- Длинные сценарии дороги: работа днями означает большой расход токенов и необходимость в инфраструктуре для агентских workflows
Кому присмотреться и как проверить на своей задаче
Carbon будет интересна командам, которые уже упираются в потолок обычных моделей на длинных задачах: когда нужно не ответить, а довести цепочку до рабочего результата без потери контекста. Это разработка, AppSec, DevSecOps, платформы с большим legacy-кодом.
Если вы попадаете в эту группу, готовьтесь заранее: соберите один повторяющийся сценарий, где сейчас тратится много ручной работы — например, разбор алертов безопасности или расследование падения тестов. Зафиксируйте входные данные, ожидаемый патч и критерии проверки, чтобы потом сравнить Carbon с текущим стеком на равных.
Если же вам нужен просто быстрый чат-ассистент или разовая генерация, ждать Carbon и перестраивать процессы под неё сейчас нет смысла — дождитесь публичного доступа и независимых тестов.
Модель как часть более широкого сдвига
Gemini 4 Carbon показывает, куда движется конкуренция флагманов: от разовых ответов к способности вести длинный процесс и отвечать за его границы. Google ставит на связку «длинный горизонт + безопасность + дисциплина исполнения» и сознательно тормозит rollout, чтобы не выпустить мощный инструмент без проверенных ограждений.
Станет ли Carbon тем самым помощником, который закрывает цикл от найденной уязвимости до патча без постоянного надзора, — покажет только независимая проверка и опыт первых команд из Fairwind. Но направление задано: ценность модели всё больше измеряется не баллом на тесте, а тем, насколько предсказуемо она ведёт реальную работу от начала до конца.