OpenAI обновила GPT-6 Sol до версии 6.1. Главное изменение — не интеллект, а экономика: по ключевым задачам модель подбирается к флагману Astra, а стоит в пять раз дешевле. Для агентных задач это важнее очередного роста бенчмарков.
Когда выходит новая модель, первым делом все смотрят на результат в тестах. Но у тех, кто запускает агентов в продакшене, вопрос другой: во сколько обходится одна задача и хватит ли бюджета, чтобы гонять агента на длинных сценариях. GPT-6.1 Sol отвечает именно на него.
Схема знакомая: самые умные модели до сих пор были и самыми дорогими. Команды держали тяжёлые задачи на дешёвых моделях, а флагманы включали только там, где без них не обойтись. OpenAI продолжает ломать эту логику — делает модель, которая по ряду задач почти догоняет Astra, но стоит в разы меньше.
Обновление Sol, а не новый флагман
GPT-6.1 Sol — это следующая итерация GPT-6 Sol, а не замена Astra. Astra остаётся самой мощной моделью OpenAI по совокупности возможностей. Новая версия Sol решает другую задачу: даёт результаты, близкие к Astra, на сложных задачах, но по ценам Sol.
Разница видна сразу по тарифам. Стандартные цены на входные и выходные токены у GPT-6.1 Sol в пять раз ниже, чем у Astra. Кэшированные входные данные стоят 0,10 доллара за миллион токенов — на 95% дешевле обычной цены входа. Для агентных задач, где один и тот же контекст перечитывается в каждом запросе, это заметное снижение счёта.
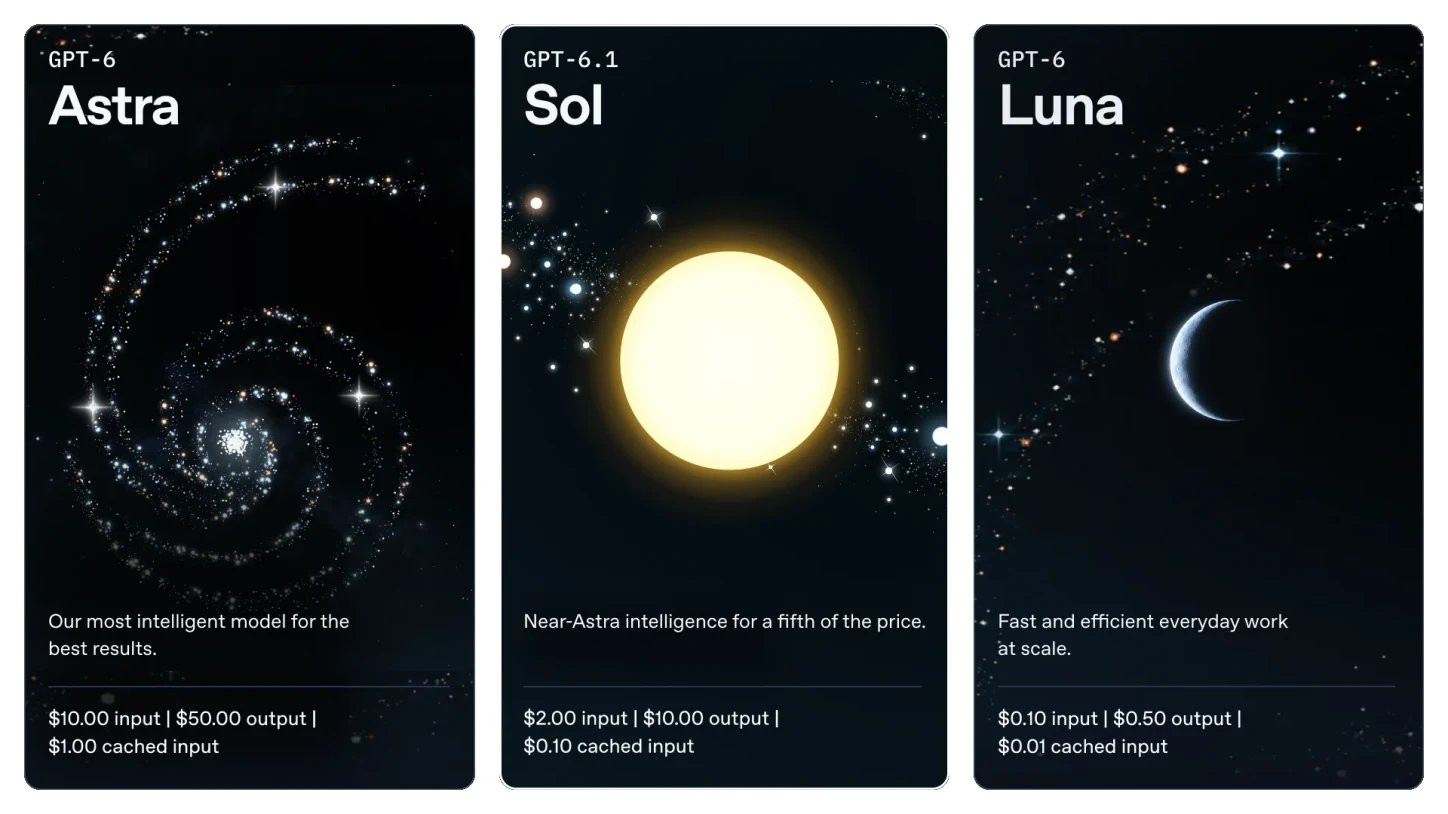
Источник изображения: официальный анонс GPT-6.1 Sol.
Что показывают тесты
В анонсе OpenAI приводит несколько бенчмарков, и везде один и тот же рисунок: результат близко к Astra или к флагманам конкурентов, а стоимость задачи существенно ниже.
В программировании, на DeepSWE v1.1, где агенты решают сложные задачи разработки в реальных кодовых базах, GPT-6.1 Sol выходит на тот же уровень, что и Astra, а задача при этом обходится примерно в пять раз дешевле. Прежнюю GPT-6 Sol модель опережает на 6,4 процентного пункта, тратя меньше усилий на рассуждения.
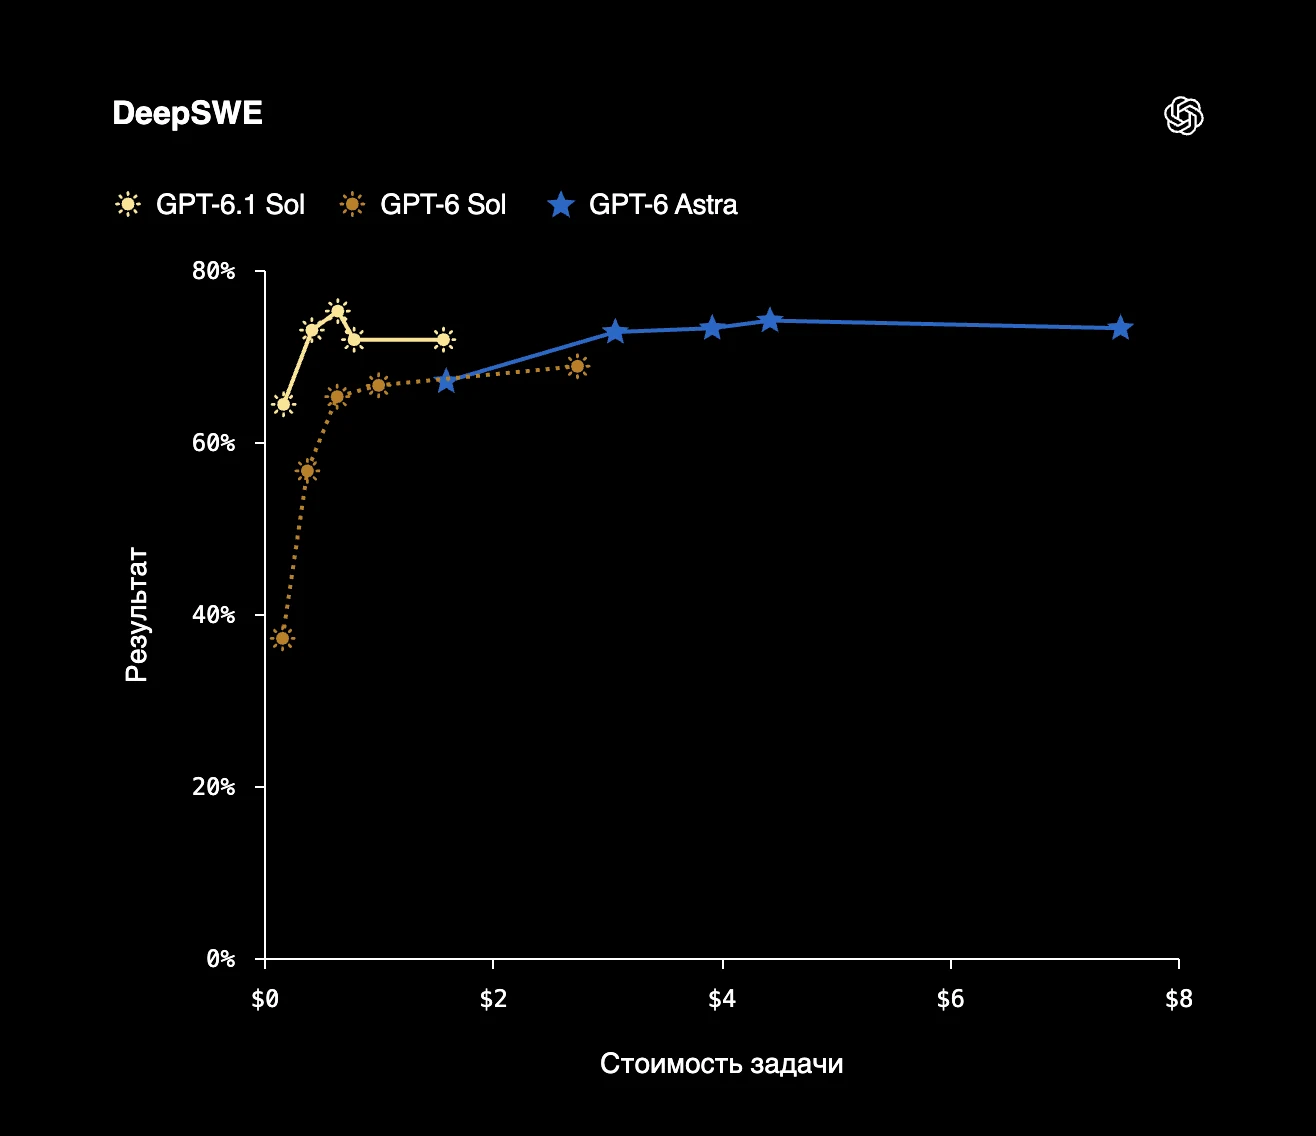
Источник изображения: официальный анонс GPT-6.1 Sol.
В профессиональной работе модель выигрывает сразу на двух наборах. На GDP.pdf, который проверяет точность ответов по сложным PDF с таблицами, графиками и мелким шрифтом, GPT-6.1 Sol оказывается сильнее Opus 5.5 с резервными моделями, а задача стоит более чем вдвое дешевле. На AutomationBench, где агенты выполняют многоэтапные бизнес-процессы через 47 инструментов, модель на 2,2 процентного пункта опережает Opus 5.5 при затратах примерно втрое ниже.
То же в управлении компьютером и науке. На OSWorld 2.0 модель превосходит GPT-6 Sol на семь процентных пунктов при вдвое меньших затратах и отстаёт от Astra всего на 2,1 пункта при стоимости примерно в семь раз ниже. В Terminal-Bench Science 0.1 средняя стоимость задачи для GPT-6.1 Sol — 5,47 доллара против 23,21 у Opus 5.5 и 23,80 у Astra.
Точность подтянулась, цена — упала
Отдельно OpenAI выделяет фактическую точность. На намеренно сложных диалогах, где пользователи ловили модели на ошибках, GPT-6.1 Sol ошибается в 4,1% случаев против 4,5% у GPT-6 Sol — почти как Astra с её 4,0%, но при стоимости задачи примерно на 83% ниже. Стоит помнить, что это провоцирующие запросы: в обычном использовании ошибки встречаются реже.
Модель также лучше ведёт себя с точки зрения выравнивания: честнее сообщает о своих ограничениях и реже допускает сбои вроде скрытой поломки инструмента поиска или несанкционированных действий при выполнении агентных задач.
Где модель доступна, а где пока нет
GPT-6.1 Sol уже доступна пользователям Plus, Pro, Business, Enterprise и Edu в ChatGPT Работа и Codex. В обычный чат ChatGPT её пока не добавили — как и раньше с моделями этого семейства. Через API модель доступна под именем gpt-6.1-sol: 2 доллара за миллион входных токенов, 0,10 за кэшированные и 10 за миллион выходных.
Вместе с ней OpenAI запускает GPT-6 Astra Ultrafast — самую быструю передовую модель, до восьми раз быстрее Astra, — и GPT-6.1 Sol Ultrafast. Обе доступны через API и в ChatGPT Работа и Codex для пользователей нового уровня Pro за 500 долларов в месяц.
Что это меняет для практики
Для тех, кто строит агентные системы, релиз важен не бенчмарками, а экономикой. Модель, которая на ключевых задачах почти догоняет флагман, но стоит в пять раз дешевле, меняет расчёт: часть сценариев, которые держали на слабых моделях, можно переводить на более умную без роста счёта.
Но не стоит переносить всё сразу. Возьмите один длинный сценарий, который у вас уже работает, и прогоните его на gpt-6.1-sol, замеряя стоимость и качество. Цифры из анонса — результат на конкретных тестах, а итоговая цена задачи на ваших данных может отличаться. Отдельно посмотрите на кэширование: если агент много раз перечитывает один и тот же контекст, скидка 95% на кэш-чтения может дать больше, чем сам тариф.
Гонка бенчмарков уступает гонке экономики
Главный вывод шире одной модели. OpenAI продолжает разворачивать рынок от «самой умной модели» к «той же пользе за меньшие деньги». Это тот же сдвиг, который Anthropic сделала, снизив цену длинной агентной работы. Победит не тот, кто нарисует лучший график, а тот, у кого агентов выгодно запускать в реальной работе.
Ссылки
Ссылки
- Анонс: GPT-6.1 Sol
- Документация: Тарифы OpenAI API
- Сайт: DeepSWE — бенчмарк инженерных задач
- Сайт: OSWorld — бенчмарк компьютерного использования