Научная статья всегда была цифровой копией бумаги: статичный PDF-файл, в котором зафиксированы текст, графики и ссылки на репозиторий. Если вы хотите проверить выводы или применить метод к своим данным, начинается знакомая рутина — клонирование кода, борьба со сломанными зависимостями двухлетней давности, ручной разбор параметров и попытки понять, что автор имел в виду в третьем абзаце.
Команда исследователей из Стэнфорда под руководством Цзячэна Мяо (Jiacheng Miao) и Джеймса Цзоу (James Zou) предложила пересмотреть этот формат. Их система Paper2Agent берет научную публикацию вместе с кодом, данными и туториалами и упаковывает её в интерактивного автономного ИИ-агента.
Сам Paper2Agent — не новинка вчерашнего дня: проект развивался как препринт с 2025 года. Но 16 сентября 2026 года работа официально вышла в Nature, а Stanford Medicine выпустил подробный разбор технологии. Внимание к публикации показательное: более 140 тысяч просмотров на странице Nature и свыше 3,4 тыс. звёзд на GitHub. Для узкой научной темы это весомый маркер интереса.
И дело здесь не просто в удобном интерфейсе для чтения статей.
Не RAG над PDF, а исполняемый агент
Главное заблуждение — посчитать Paper2Agent очередной надстройкой, которая делает семантический поиск по тексту документа. Чат-боты, отвечающие на вопросы по PDF через RAG, существуют годами, и их польза ограничена пересказом того, что и так написано в тексте.
Paper2Agent делает другую вещь: он превращает статью в «виртуального автора-корреспондента» (virtual corresponding author), который умеет выполнять методы из публикации.
Такой агент:
- понимает математический и исследовательский контекст работы;
- запускает оригинальный код с нужными параметрами;
- проверяет воспроизводимость вычислений на исходных данных;
- применяет описанные в статье алгоритмы к новым данным пользователя;
- умеет общаться и обмениваться контекстом с агентами других научных работ.
Вместо того чтобы читать описание алгоритма и писать для него обвязку, вы отдаете агенту свои данные и просите прогнать их через пайплайн статьи.
Как устроен конвейер под капотом
Превращение исследовательского репозитория в надежного агента — сложная инженерная задача. Научный код часто пишется для однократного эксперимента: манифесты окружения отсутствуют, пути захардкожены, а примеры разбросаны по Jupyter-ноутбукам.
Чтобы автоматизировать упаковку, авторы развернули многоагентный пайплайн из четырех специализированных ролей:
- Environment Manager — разворачивает изолированную песочницу, определяет совместимые версии Python, системные библиотеки и CUDA-зависимости, добиваясь стабильной сборки среды.
- Tutorial Scanner — анализирует репозиторий, находит скрипты демонстраций, примеры и обучающие материалы, восстанавливая реальный сценарий использования кода.
- Tool Extractor — извлекает логику методов и преобразует её в параметризованные функции с типизированными входными и выходными аргументами.
- Test Verifier — проводит верификацию: запускает извлеченные функции на эталонных данных статьи и сопоставляет сгенерированные таблицы и графики с оригинальными иллюстрациями из PDF. Агент считается готовым только тогда, когда расхождения укладываются в допустимую погрешность.
Кроме того, авторы предусмотрели протокол human-in-the-loop: оригинальный автор статьи может добавить неявный контекст, которого нет в тексте публикации — почему были выбраны именно эти гиперпараметры, какие гипотезы не сработали и где находятся скрытые граничные условия.
MCP-сервер как универсальный интерфейс
Ключевое архитектурное решение команды — оформление результата в виде MCP-сервера (Model Context Protocol).
Вместо того чтобы писать собственный закрытый веб-интерфейс, Paper2Agent стандартизирует артефакты статьи по трем примитивам MCP:
- Tools: вызываемые функции (алгоритмы и расчетные методы статьи с четкой схемой аргументов);
- Resources: доступ к самому тексту рукописи, метаданным, репозиторию, контрольным точкам моделей и датасетам;
- Prompts: готовые структурированные шаблоны воркфлоу, которые направляют LLM по шагам правильного применения инструментов.
Благодаря этому созданного агента статьи можно напрямую подключить к любому совместимому клиенту: Claude Code, Cursor, Codex, Gemini CLI или кастомному агентному контуру. Вы работаете в своей привычной среде разработки, а статья выступает как внешний инструментальный сервер.
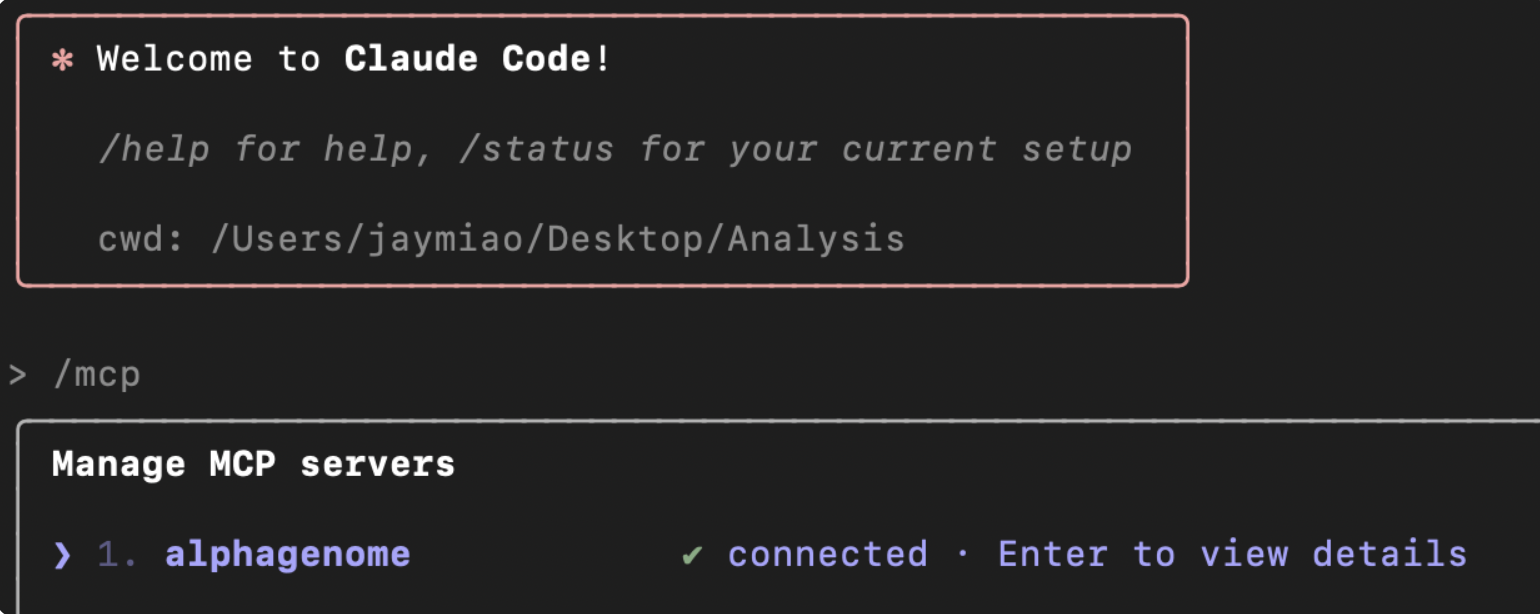
Источник скриншота: репозиторий Paper2Agent.

Эксперимент: гипотеза на стыке генетики и СДВГ
Самая показательная часть исследования — демонстрация того, что происходит, когда агенты разных статей начинают работать вместе.
Исследователи упаковали в агентов две независимые работы:
- Первая статья описывала модель прогнозирования эффекта генетических мутаций (variant effect prediction).
- Вторая публикация представляла собой полногеномное исследование ассоциаций (GWAS), посвященное синдрому дефицита внимания и гиперактивности (СДВГ / ADHD).
Агенты получили задачу сопоставить регуляторные варианты генома с локусами риска, выявленными в исследовании СДВГ. В процессе совместного анализа они обнаружили потенциальную связь некодирующего интронного варианта (rs1626703) вблизи гена MPHOSPH9 с повышенным риском развития СДВГ. Анализ показал, что этот вариант может влиять на сплайсинг и экспрессию гена в глутаматергических нейронах. Ранее в литературе по СДВГ этот конкретный механизм не описывался.
Здесь принципиально важна оговорка, которую подчёркивают и сами авторы: это вычислительная гипотеза, сгенерированная моделями, а не подтвержденное медицинское открытие. Чтобы гипотеза стала медицинским фактом, требуются стандартные лабораторные эксперименты (wet-lab validation).
Но этот прецедент важен с точки зрения методологии: два агента из разных предметных областей смогли передать друг другу данные, применить специализированные методы и сформулировать правдоподобную гипотезу без многонедельного согласования протоколов живыми исследователями.
Почему это меняет представление о документах
Если посмотреть шире научной среды, Paper2Agent показывает фундаментальный сдвиг в работе со знаниями.
Формат PDF создавался в начале девяностых для одной цели — гарантировать, что документ распечатается на принтере точно так же, как выглядит на экране. Вся корпоративная инфраструктура до сих пор живет в парадигме статических документов: технические регламенты, регламенты безопасности, проектные спецификации, архитектурные гайды, юридические договоры.
Но документ в виде мертвого текста порождает постоянный налог на поддержку:
- документация расходится с реальным кодом уже через месяц после релиза;
- для проверки требований нужно вручную сопоставлять пункты регламента с системой;
- знания сотрудников уходят вместе с ними, оставляя папки с устаревшими файлами.
Paper2Agent доказывает альтернативный подход: любой сложный документ можно проектировать не как текстовый файл, а как исполняемый агентный узел.
Техническая документация API может быть MCP-сервером, который сам умеет тестировать запросы и генерировать клиенты. Корпоративный регламент закупок — агентом, который валидирует смету и сверяет её с лимитами. Архитектурная спецификация — агентом, который проверяет код на соответствие правилам проекта.
Когда документ становится исполняемым и получает протокол общения с другими документами, исчезает граница между «прочитать инструкцию» и «выполнить работу». И работа Стэнфорда — это первый наглядный пример того, как такой переход выглядит на практике.
Ссылки
Ссылки
- Пресс-релиз: Manuscripts-turned AI agents can now ‘talk’ to each other — Stanford Medicine
- Научная работа: Reimagining research papers as interactive and reliable AI agents — Nature
- Репозиторий: Paper2Agent — GitHub