Keenable — поисковая инфраструктура, которая даёт ИИ-агенту два готовых действия: искать страницы в интернете и извлекать из них текст. Подключить сервис можно тремя способами — через MCP, командную строку или обычный REST API.
По данным компании, индекс насчитывает свыше 100 млрд документов, а на 95-м перцентиле задержка поиска в регионе US East укладывается в 250 мс. Обе цифры — заявление самого сервиса, независимых замеров для этого материала не было.
Ключевое правило: поиск находит страницы, но не решает за агента, каким источникам доверять. Выбор первичных источников и проверка противоречий остаются на стороне агента.
Что это
Keenable — сервис поиска, построенный специально под приложения, работающие с языковыми моделями. Он находит страницы, выстраивает их по релевантности, а потом может забрать текст нужного адреса сразу в Markdown — без ручного разбора HTML.
Полный рабочий цикл агента выглядит как четыре шага. Сначала агент формулирует поисковый запрос. Затем инструмент search_web_pages возвращает адреса, заголовки, описания и фрагменты страниц. Агент выбирает подходящие источники, после чего fetch_page_content получает их полный текст. В конце модель собирает ответ со ссылками на источники.
MCP (Model Context Protocol — протокол, через который ассистенты подключают внешние инструменты) здесь основной способ подключения. REST API пригодится, если вы строите собственный backend или RAG-пайплайн, а командная строка — для быстрой установки и проверки из терминала.
Зачем нужно
Агенту нужен веб-поиск, когда его собственных знаний не хватает: модель обучена до определённого момента, а мир продолжает меняться.
- Свежие сведения — документация, релизы и события, появившиеся уже после обучения модели.
- Поиск без привязки к одному движку — независимый индекс вместо выдачи конкретного поисковика.
- Чистый текст страниц — извлечение содержимого в Markdown сразу готово для передачи модели.
- Поиск в прошлом — параметр query_time воспроизводит состояние индекса на выбранный момент.
- Воспроизводимые исследования — одинаковый запрос в один день возвращает одинаковую картину выдачи.
Как устроено
Сервис состоит из двух операций — поиска и извлечения — и набора фильтров, которые управляют выдачей.
| Возможность | Что даёт |
|---|---|
| Веб-поиск | Ранжированные результаты с URL, заголовком, описанием и фрагментом текста. |
| Извлечение страницы | Содержимое адреса в Markdown без самостоятельного разбора HTML. |
| Фильтр по сайту | Ограничение выдачи конкретным доменом. |
| Фильтры по датам | Отбор по времени публикации или попадания страницы в индекс. |
| Поиск в прошлом | Параметр query_time воспроизводит состояние индекса на выбранный момент. |
| Живое извлечение | live=true запрашивает страницу у источника, даже если её нет в индексе. |
| Целевая экстракция | Параметр prompt возвращает только нужные данные со страницы. |
| MCP | Готовые поисковые инструменты для Codex, Claude, Cursor и других клиентов. |
| REST API | Прямые HTTP-запросы из Python, TypeScript или любого backend. |
Поиск возвращает до 50 результатов, а длину фрагмента можно задать через snippet_max_length в диапазоне от 180 до 10 000 символов.
Дальше идут тарифы и лимиты. Каждая организация получает 100 000 бесплатных запросов в месяц, лимит обновляется ежемесячно. После исчерпания квоты в консоли покупаются кредиты.
| Режим | Цена или квота | Скорость |
|---|---|---|
| Публичный без ключа | Бесплатно, до 1 000 запросов в час на IP | До 10 запросов/с |
| Авторизованный | 100 000 бесплатных запросов в месяц | 10 запросов/с на организацию |
| Agent Builder | $4 за 1 000 запросов после бесплатного объёма | Облачный доступ |
| Frontier | От $1 за 1 000 запросов | От 100 запросов/с, выделенная ёмкость |
Повышенные лимиты, on-premises и выделенная инфраструктура входят в индивидуальный контракт Frontier. Через MCP каждый авторизованный вызов может вернуть фактическое списание в поле _meta[“keenable/usage”] — для учёта расходов стоит читать именно его, ведь цена зависит от операции и условий организации.
Когда использовать
| Ситуация | Решение | Пояснение |
|---|---|---|
| Агенту нужны данные после обучения модели | Подключить MCP и попросить найти текущую документацию | В ответе появляются актуальные ссылки, которые можно проверить по открытым источникам. |
| Найти ответ в официальной документации без случайных обзоров | Передать домен через параметр site | Выдача ограничивается выбранным доменом, но не поможет, если страница ещё не в индексе. |
| Воспроизвести, что мог найти агент на прошлую дату | Задать параметр query_time | Исключаются документы, попавшие в индекс позже выбранного момента. |
| Познакомиться с сервисом без регистрации | Использовать публичный endpoint | Бесплатно, но квота делится с другими пользователями того же IP. |
Пример
Через MCP
Самый короткий путь начинается с официального CLI. На macOS он ставится через Homebrew:
brew install keenableai/tap/keenable-cliПосле установки нужно авторизоваться: команда откроет браузерный вход по device-code flow.
keenable login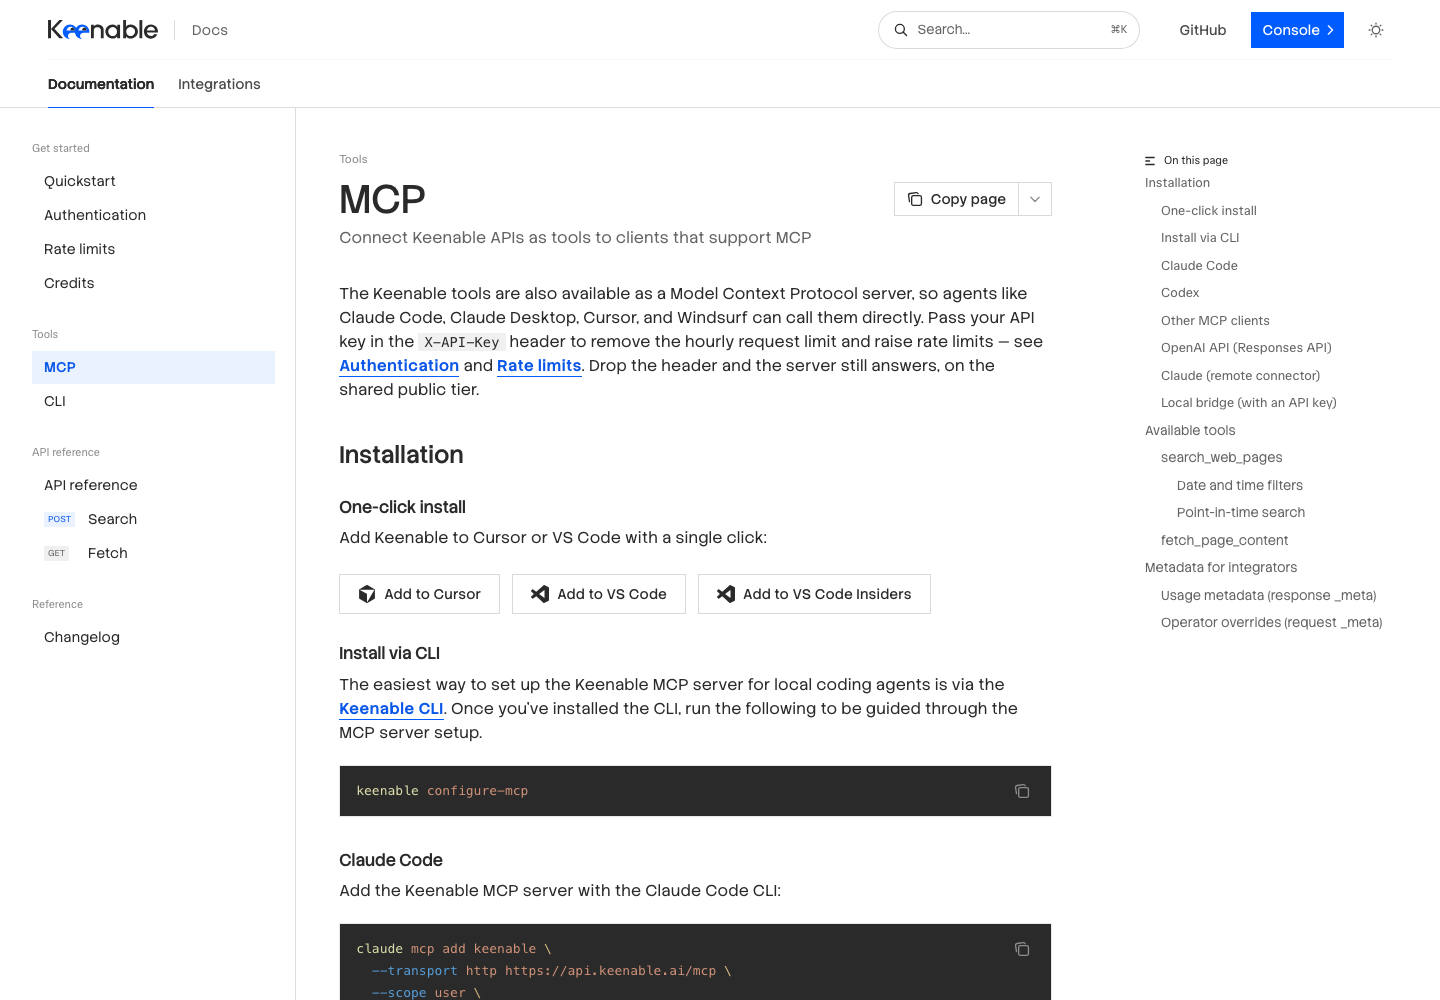
После входа CLI сам настроит MCP для обнаруженных клиентов:
keenable configure-mcp --allСреди поддерживаемых клиентов указаны Codex, Claude Code, Claude Desktop, Cursor, Windsurf и OpenCode.
Для Codex подключение можно прописать вручную — в конфигурацию добавляется удалённый MCP-сервер:
[mcp_servers.keenable]
url = "https://api.keenable.ai/mcp"
http_headers = { "X-API-Key" = "keen_<your_key>" }
Ключ выдаётся в консоли Keenable. После подключения агент получает два инструмента: search_web_pages для поиска и ранжирования и fetch_page_content для получения текста страницы.
Внимание: не вставляйте реальный ключ в репозиторий, скриншот или публичную инструкцию. Для локальной настройки лучше пройти keenable login — CLI сам настроит подключение.
Через REST API
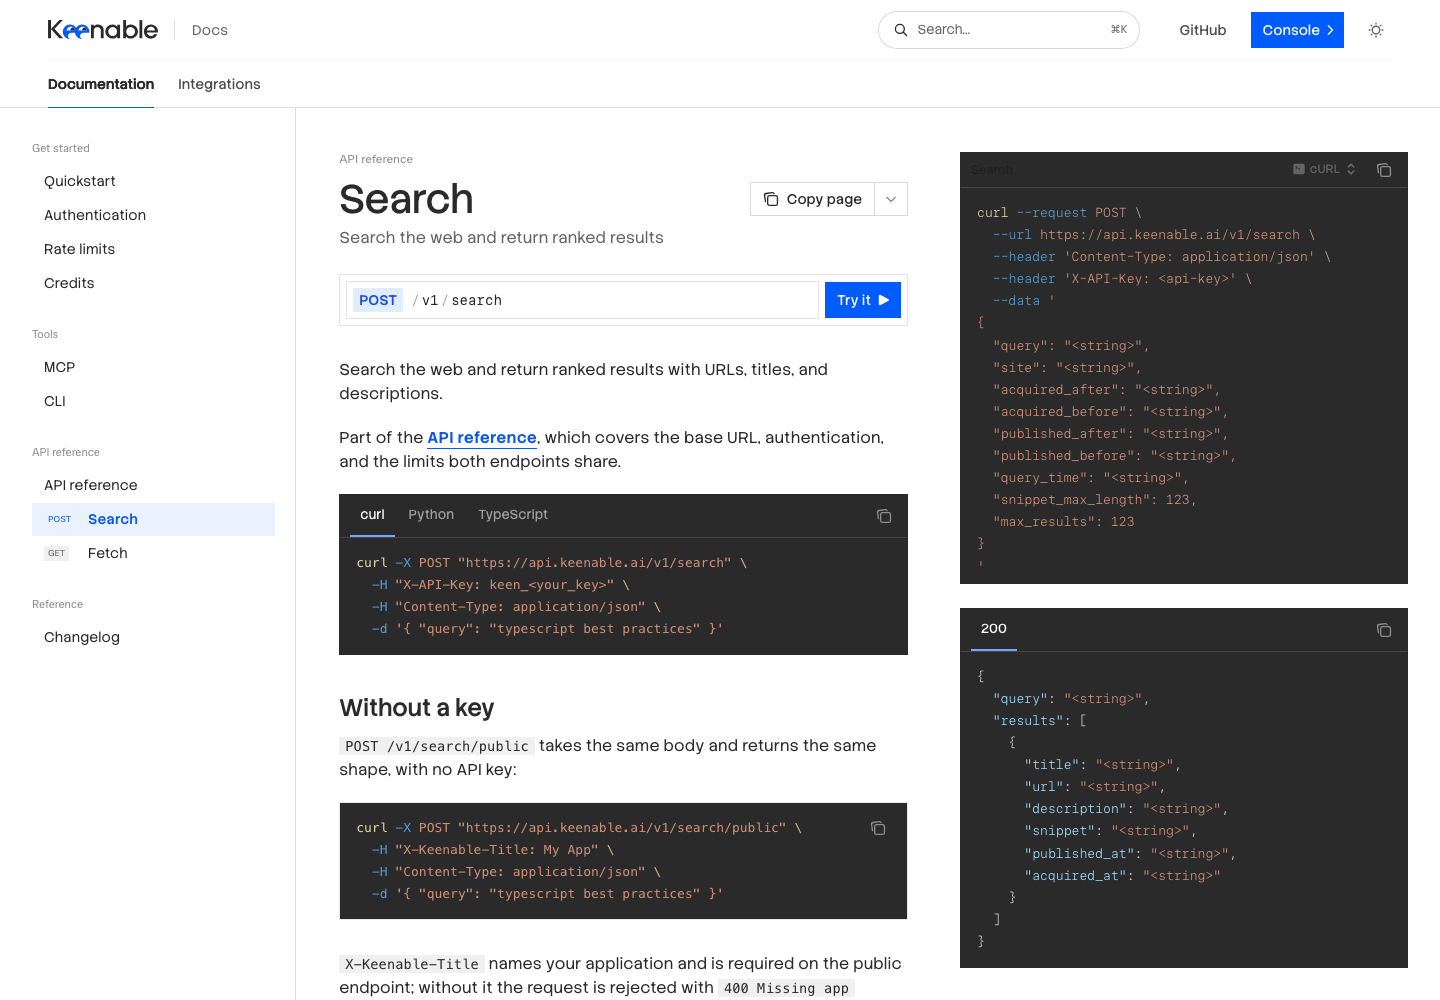
Поиск с API-ключом — обычный POST-запрос:
curl -X POST "https://api.keenable.ai/v1/search" \
  -H "X-API-Key: ***" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "актуальные способы подключения MCP к Codex",
    "max_results": 5
  }'
Ответ содержит исходный запрос и массив results с адресом, заголовком, описанием, фрагментом и датами публикации и попадания в индекс.
Извлечение содержимого страницы выполняется отдельным GET-запросом:
curl --get "https://api.keenable.ai/v1/fetch" \
  -H "X-API-Key: ***" \
  --data-urlencode "url=https://example.com/page"
По умолчанию возвращается копия, сохранённая в индексе. Для страницы, которой в индексе нет, добавляется флаг live=true. Параметр max_chars ограничивает размер результата (по умолчанию 50 000 символов), а prompt принимает инструкцию длиной до 2 000 символов и помогает достать только конкретные сведения — например тарифы или список поддерживаемых интеграций.
Коды ошибок, которые стоит различать при интеграции:
| Код | Что означает | Что проверить |
|---|---|---|
| 400 | Неверный формат ключа или нет обязательного идентификатора приложения | Формат заголовков и JSON |
| 401 | Ключ отсутствует или недействителен | X-API-Key или Bearer token |
| 402 | Бесплатная квота и купленные кредиты закончились | Баланс в консоли |
| 403 | Ключ отключён или отозван | Состояние ключа и workspace |
| 429 | Превышена скорость запросов | Очередь, задержка и повтор с backoff |
Проверка без регистрации
У Keenable есть публичные endpoints, работающие без ключа. Для них требуется заголовок X-Keenable-Title с названием вашего приложения:
curl -X POST "https://api.keenable.ai/v1/search/public" \
  -H "X-Keenable-Title: My Test Agent" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Keenable web search API",
    "max_results": 3
  }'
Такой запрос возвращает HTTP 200, исходное поле query, режим поиска pro и три объекта в массиве results вместе с заголовками X-RateLimit-Limit, X-RateLimit-Remaining и X-RateLimit-Reset. Публичный режим рассчитан на знакомство и smoke-тесты, а не на рабочую нагрузку: лимит — 1 000 запросов в час и 10 запросов в секунду на один IP, и квота делится с другими пользователями того же адреса.
Keenable закрывает конкретную нишу: управляемый веб-поиск с фильтрами по времени и воспроизводимым состоянием выдачи. Если агенту нужен именно такой источник данных — сервис подключается за считанные минуты, а остальное остаётся задачей агента.
Ограничения
Ограничения
Что учитывать перед подключением.
fetch читает индексированную копию, а не живой сайт — По умолчанию извлечение возвращает сохранённую в индексе версию страницы.
Для живого запроса нужен флаг live=true, и это отдельная тарифицируемая операция.
10 запросов в секунду мало для крупного продукта — Стандартный лимит рассчитан на небольшую нагрузку.
Для публичного сервиса с тысячами одновременных пользователей понадобится индивидуальный контракт Frontier.
Сервис не проверяет достоверность источников — Keenable возвращает источники, но не решает, заслуживают ли они доверия.
Закрытые страницы и внутренние корпоративные системы требуют отдельного способа доступа.
Индекс не совпадает с выдачей конкретного поисковика
— Если нужна именно выдача Google или другого движка, независимый индекс Keenable её не воспроизводит.
Публичная квота делится между пользователями
— Бесплатный endpoint без ключа ограничен по IP, и доступный объём зависит от чужого трафика с того же адреса.
Антипаттерны
Антипаттерны
Чего не делать при интеграции.
Вставлять реальный ключ в репозиторий или инструкцию — API-ключ в открытом коде равнозначен его публикации.
Для локальной настройки используйте keenable login.
Держать несколько поисковых провайдеров одновременно — Если в агенте подключены несколько инструментов с одинаковой функцией, он может непредсказуемо выбирать между ними.
Официальная документация рекомендует отключить дубли.
Считать, что страница в выдаче достоверна — Наличие результата не гарантирует его качество.
Агенту нужны правила выбора первичных источников и проверки противоречий.
Передавать в запрос чувствительные данные
— Пароли, API-ключи, персональные данные и закрытые документы не должны попадать в поисковый запрос.
Игнорировать таймауты и обработку 429
— Без ограничения числа повторов и экспоненциальной задержки интеграция ломается при всплеске нагрузки.
Чеклист
Чеклист
Проверка перед запуском.
Определён способ подключения
— MCP для штатного инструмента агента, REST API для собственного backend, CLI для проверки из терминала.
Ключ получен и не засвечен
— API-ключ создан в консоли и не попал в репозиторий или публичную документацию.
Дублирующие поисковые инструменты отключены
— Агент не выбирает между несколькими провайдерами случайным образом.
Настроена обработка ошибок
— Добавлены таймаут, ограничение повторов и экспоненциальная задержка после 429.
Выбран режим поиска и учтена квота
— Известно, сколько стоят операции и читается ли поле _meta[“keenable/usage”] для учёта расходов.
Проверен публичный endpoint
— Для знакомства выполнен smoke-тест без ключа, и структура ответа соответствует ожиданиям.
Ссылки
Ссылки
- Сайт: Keenable
- Документация: Документация Keenable
- Документация: MCP-сервер Keenable
- Документация: Search API
- Тарифы: Keenable Pricing