Во многих агентных системах каждый следующий запрос включает накопленную историю: предыдущие действия, ответы инструментов и промежуточные результаты. Чем дольше выполняется задача, тем больше становится контекст и тем дороже обходятся следующие шаги. SKILL.state — подход исследователей из Google и Университета Пердью, который предлагает вместо полной истории передавать агенту текущее состояние задачи.
Что это
SKILL.state — это архитектура среды выполнения для агентов, которая заменяет накопление истории диалога явным, изменяемым состоянием задачи. Вместо того чтобы на каждом шаге перечитывать всё, что было сделано раньше, агент получает только три вещи: неизменяемое описание навыка, текущее структурированное состояние и последнее наблюдение из среды.
Промежуточные рассуждения — та самая цепочка мыслей, которую модель строит, чтобы выбрать следующий шаг, — после каждого шага отбрасываются. В памяти остаётся только обновлённое состояние. Так агент опирается на актуальную картину мира, а не на пересказ собственного прошлого.
Ключевое правило: состояние — это достаточная сводка задачи. В нём хранится только то, что понадобится на следующих шагах. Всё, что перестало быть полезным, удаляется сразу.
Зачем нужно
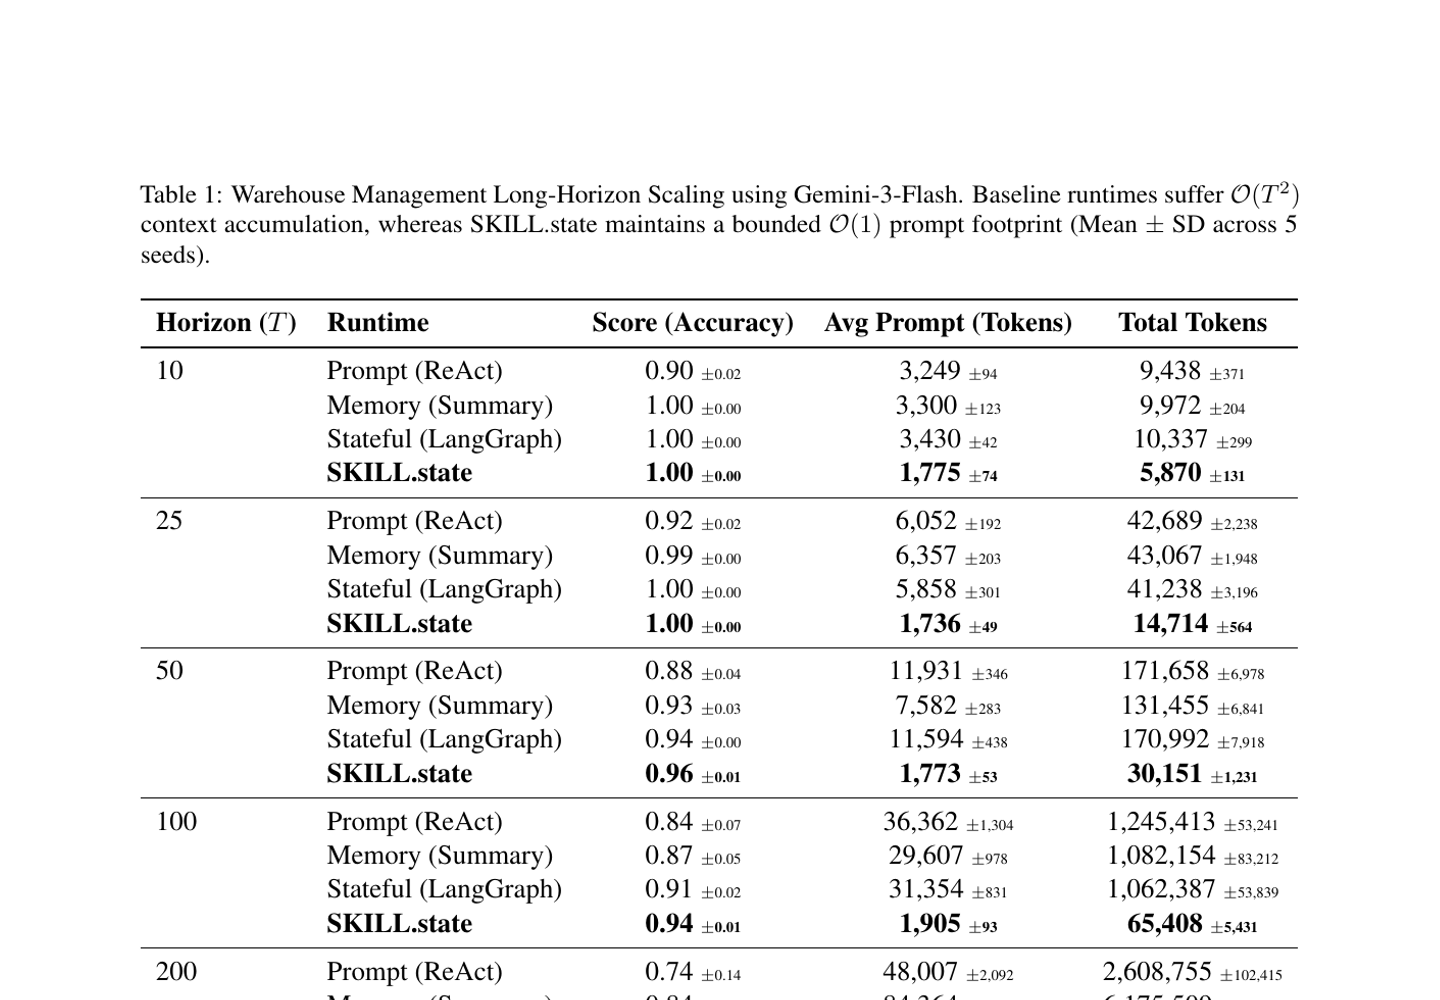
Проблема, которую решает подход, — рост расхода токенов по мере удлинения истории. Если каждый следующий запрос включает всё больше предыдущего контекста, суммарный расход может расти квадратично с числом шагов. В архитектуре SKILL.state размер запроса не растёт вместе с полной историей, поэтому при ограниченном размере состояния суммарный расход токенов растёт линейно с числом шагов.
- Длинные задачи без сильной потери качества — в эксперименте длиной 200 шагов SKILL.state сохранил точность 94%, тогда как вариант с суммированием истории показал 84%.
- Экономия токенов — на той же задаче расходуется около 122 000 токенов против 6,17 млн у базового варианта, то есть примерно в 50 раз меньше.
- Устойчивость к нерелевантным событиям — в эксперименте с искусственно добавленными отвлекающими событиями большая часть ненужной информации не переносилась в следующие запросы через состояние.
- Быстрое восстановление после изменений среды — в нескольких тестовых сценариях SKILL.state обновлял состояние сразу после корректирующего наблюдения, тогда как системы с историей ещё несколько шагов опирались на устаревшие данные. Один из сценариев восстановления не смог решить ни один из протестированных подходов.
Как устроено
| Элемент | Роль |
|---|---|
| Спецификация навыка (P) | Неизменяемое описание процедуры: что агент должен делать и какие шаги допустимы. |
| Состояние выполнения (Σ) | Структурированное состояние задачи: факты, прогресс и данные для следующего шага. |
| Наблюдение (O) | Последнее наблюдение из среды, полученное на текущем шаге. |
| Обновление состояния (ΔΣ) | JSON-словарь изменений: какие ключи добавить, изменить или удалить. |
| Проверка состояния | Детерминированная проверка обновления перед применением; неверное обновление откатывается. |
На каждом шаге среда выполнения собирает запрос из трёх частей — спецификации, состояния и наблюдения, — вызывает модель и получает от неё тройку: промежуточное рассуждение, обновление состояния и действие. Обновление проходит детерминированную проверку, затем применяется к состоянию, действие выполняется, а промежуточное рассуждение удаляется.
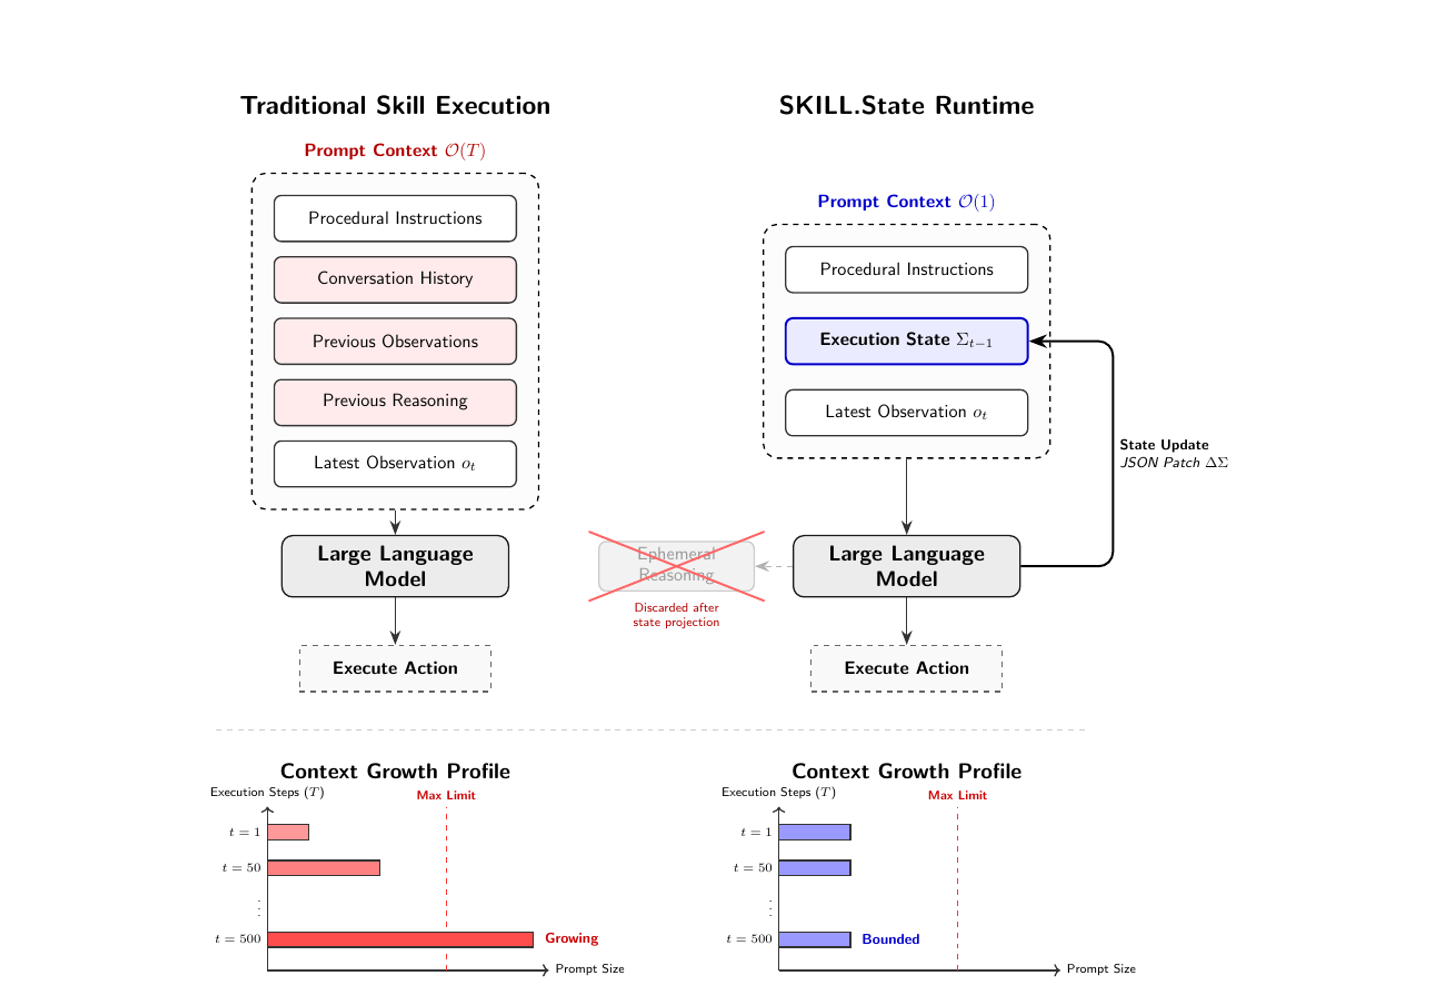
Схема состояния задаётся один раз для типа задач, а не отдельно для каждой задачи. Например, для всех 100 тестовых задач InterCode CTF используется одна и та же схема из пяти полей: найденные флаги, проверенные гипотезы, активные файлы, рабочая директория и сводка команд.
Когда использовать
| Ситуация | Подходит / не подходит | Почему |
|---|---|---|
| Длинные процедурные задачи на десятки и сотни шагов | Подходит | Полная история не добавляется к каждому новому запросу; при ограниченном размере состояния суммарный расход токенов растёт линейно с числом шагов. |
| Задача с заранее известной схемой состояния | Подходит | Схема задаётся один раз для одного типа задач и затем переиспользуется. |
| Нужен аудит или объяснение прошлых действий | Не подходит | Здесь история и есть результат, её нельзя отбрасывать. |
| Схема состояния неизвестна заранее | Не подходит | Подход требует фиксированной структуры состояния. |
| Мультиагентная система с общим состоянием | Частично | Нужна семантика разрешения конфликтов при одновременных записях. |
Пример: схема состояния и цикл выполнения
Вот как выглядит схема состояния для задач InterCode CTF — пять полей, общих для всех 100 испытаний:
discovered_flags: [...]      # найденные флаги
tested_hypotheses: [...]     # проверенные гипотезы
active_files: [...]          # активные файлы
working_dir: "..."           # рабочая директория
cmd_summary: "..."           # сводка выполненных команд
А сам цикл выполнения сводится к короткой последовательности шагов:
для каждого шага t:
    получить наблюдение O_t
    собрать запрос (P, Σ_t, O_t)
    сгенерировать (R_t, ΔΣ_t, a_t)
    проверить ΔΣ_t
    Σ_{t+1} = Σ_t ⊕ ΔΣ_t
    выполнить a_t
    отбросить R_t
Ключевой момент — последняя строка: цепочка рассуждений R_t удаляется сразу после того, как из неё извлечено обновление состояния. В следующий запрос попадает только обновлённое Σ.
Ограничения
Ограничения
Что учитывать перед внедрением.
Нужна фиксированная схема состояния — Подход предполагает, что структура состояния известна заранее.
Если её приходится открывать на лету, метод не работает — это первое из трёх ограничений, которые авторы называют явно.
Зависимость от вовремя распознанной важности
— Если наблюдение было важным, но его значимость не поняли сразу, оно не попадёт в состояние и будет потеряно навсегда.
Не подходит, когда история
— это результат — Для аудита, отладки происхождения или объяснения прошлых действий история взаимодействия и есть целевой результат, а не накладные расходы.
Мультиагентный режим в работе не исследовался — Для нескольких агентов с общим состоянием потребуется способ детерминированно разрешать конфликты при одновременных записях.
В работе такой режим не оценивался.
Модели с открытыми весами сильнее зависят от качества структурированного вывода — В эксперименте с Gemma-4-31B авторы отнесли 68% ошибок к преждевременной перезаписи состояния, 20% — к непониманию схемы и 12% — к синтаксису JSON.
Это результат конкретного эксперимента, а не характеристика всех моделей с открытыми весами.
Антипаттерны
Антипаттерны
Ошибки, которые могут свести пользу подхода к нулю.
Применять к задачам без фиксированной схемы
— Если структура состояния неизвестна заранее, подход не сработает — это прямое ограничение метода, а не деталь реализации.
Использовать для аудита или объяснения прошлых шагов
— Когда цель задачи — сама траектория действий, отбрасывание истории уничтожает то, что нужно сохранить.
Подменять структуру статистическим сжатием
— Скользящее окно и LLMLingua при том же бюджете токенов обрушивают точность до 0,18–0,22 против 0,94 у SKILL.state.
Пропускать проверку обновления состояния
— Без детерминированной проверки неверное обновление может испортить состояние; проверка с откатом — обязательная часть цикла.
Чеклист
Чеклист
Что стоит проверить до внедрения.
Эксперименты SKILL.state показывают, что для длинных процедурных задач с понятной структурой состояния агенту не обязательно передавать всю историю на каждом шаге. В таких сценариях явное состояние может одновременно уменьшить расход токенов и повысить устойчивость выполнения.
Схема состояния определена для типа задач
— Фиксированный набор полей задаётся один раз для одного типа задач, а не отдельно для каждой задачи.
В состоянии только нужное для будущих шагов
— Всё, что перестало быть полезным, удаляется при обновлении.
Проверка обновления состояния детерминирована
— Неверное обновление откатывается и не портит текущее состояние.
Рассуждения отбрасываются после шага
— Цепочка мыслей не попадает в следующий запрос.
Модель надёжно выдаёт структурированный результат
— Если модель часто нарушает JSON-схему, нужен дополнительный контроль формата или ограничение генерации допустимой структурой.
Ссылки