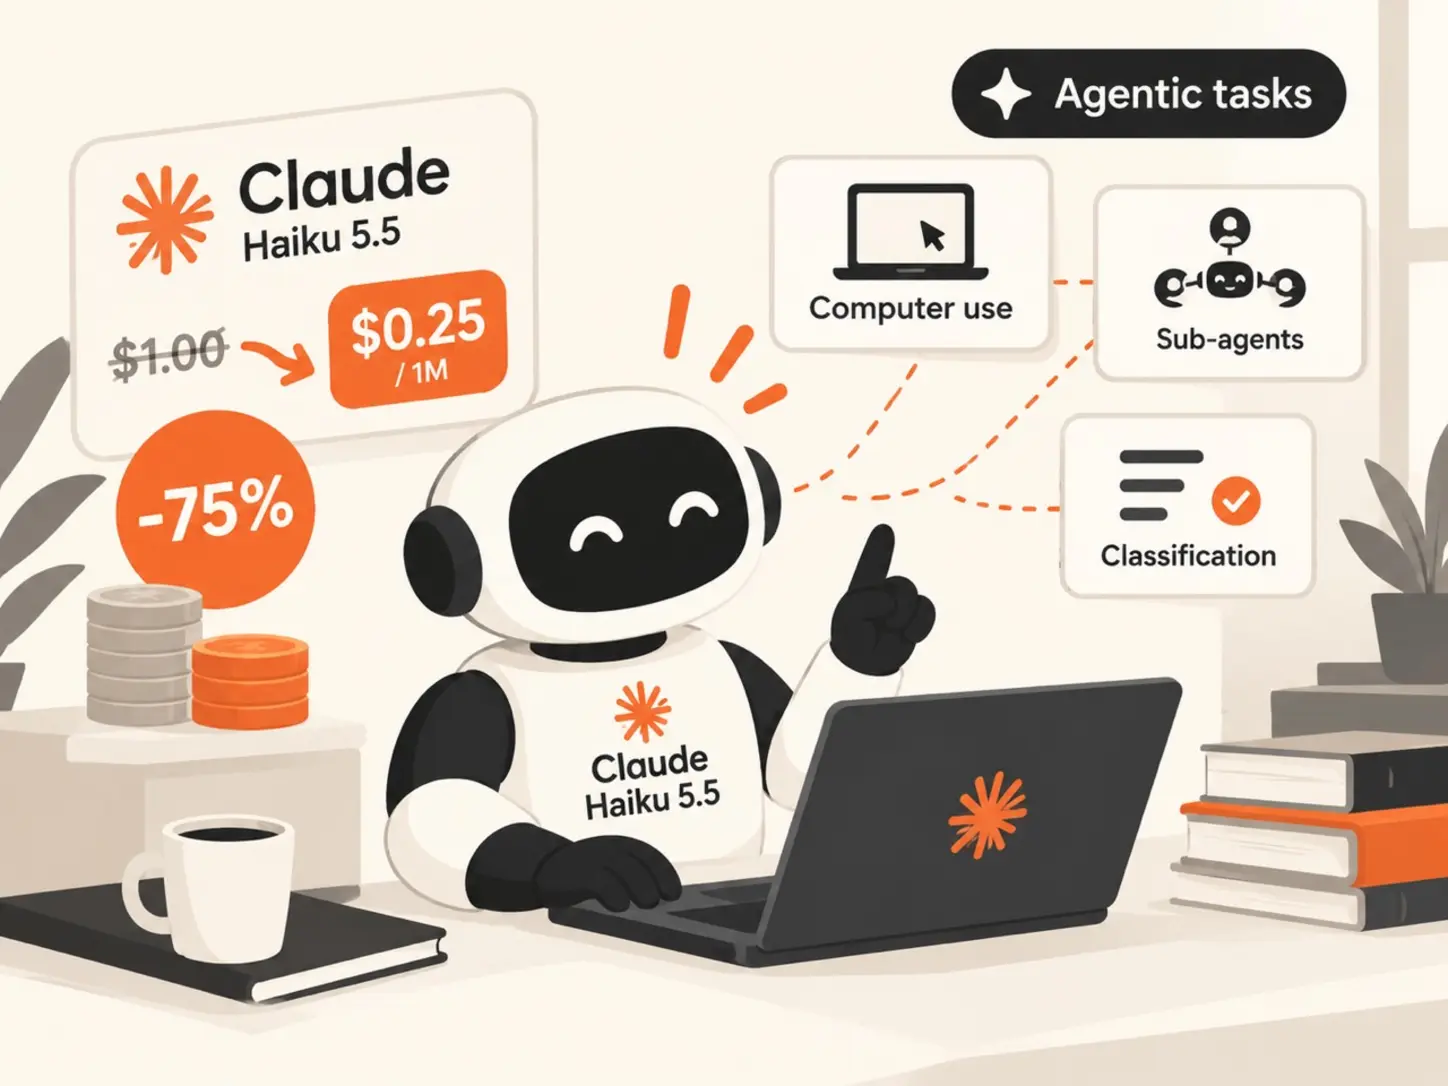
Anthropic выпустила Claude Haiku 5.5 — компактную модель, которая в среднем подешевела на 75% и впервые тянет задачи, раньше отдававшиеся большим моделям: управление компьютером, субагентов и быструю классификацию. Разбираю, что именно изменилось и где это уже можно считать выгодой.
Долгое время в семействе Claude компактная линейка Haiku оставалась нишей для дёшевой рутины: сводки, сортировка, короткие ответы. Там, где нужны были действия — управлять компьютером, решать многошаговые задачи в терминале, — Haiku 4.5 почти не годилась. В тесте Terminal-Bench 4.0 она набирала ноль.
Haiku 5.5 меняет эту границу. Это первая маленькая модель Anthropic, которая справляется с агентной работой в масштабе, где раньше приходилось платить за большую модель. Разберём, чем это обеспечено и что из этого следует для тех, кто запускает агентов в продакшене.
Маленькая модель впервые доросла до агентных задач
Скачок по сравнению с Haiku 4.5 почти везде кратный, а не постепенный. В профессиональной работе GDPval-AA v2.1 — тесте на реальные задачи по 44 профессиям — модель набрала 1620 баллов против 735 у предшественницы. В управлении компьютером OSWorld 2.1 разница ещё нагляднее: 72,4% против 15,7% на офлайн-подмножестве. То есть задача, которую Haiku 4.5 практически не умела, теперь решается на уровне, пригодном для работы.
В мультидисциплинарном рассуждении Humanity’s Last Exam модель поднялась с 10,2% до 45,9% без инструментов и до 57,4% с ними. В агентном кодинге Terminal-Bench 4.0 — с нуля до 39,2%. Это уже не просто «быстрее и дешевле»: у модели появились способности, которых у предыдущей версии не было.
Ещё одно новшество — регулируемый уровень усилий. Haiku 5.5 стала первой моделью своего класса, где можно выбирать между скоростью и качеством, как у старших моделей. Для задач, где ответ нужен мгновенно, это отдельный рычаг экономии.
Цена упала сильнее, чем у любой предыдущей смены поколения
В среднем Haiku 5.5 обходится примерно на 75% дешевле Haiku 4.5. Точнее, снижение зависит от длины запроса: для промптов до 100 000 токенов — минус 90%, свыше — минус 50%. Первый случай покрывает около 90% запросов к предыдущей модели, поэтому именно он и задаёт среднюю картину.
| Цена за 1 млн токенов | Haiku 5.5 (до / свыше 100k) | Haiku 4.5 |
|---|---|---|
| Чтение кэша | $0.01 / $0.05 | $0.10 |
| Запись кэша | $0.125 / $0.625 | $1.25 |
| Входные токены | $0.10 / $0.50 | $1.00 |
| Выходные токены | $0.50 / $2.50 | $5.00 |
Отдельно Anthropic вдвое снизила цену чтения кэша у Claude Sonnet 5.5 — с $0,20 до $0,10 за миллион токенов. Поскольку чтение кэша занимает большую долю потребления в агентной работе, Sonnet 5.5 теперь обходится примерно на 20% дешевле на большинстве таких задач. Дополнительно компания запускает ежемесячный API-кредит для подписчиков Max и Team — до $500 на команду.
Где модель выигрывает: субагенты и короткая высокая нагрузка
Главный сценарий — субагент в паре со старшей моделью. Когда Claude Opus 5.5 ведёт сложную задачу, Haiku 5.5 берёт на себя короткие подзадачи: вытащить нужную цифру из документа, прогнать сводку, отфильтровать заявки. Компания Rogo описывает это так: большая модель собирает презентацию, а субагент Haiku заходит в отчётность и достаёт конкретную строку выручки.
Это меняет экономику тех, кто гоняет много коротких запросов. Ранние тестировщики называют числа в одном направлении: Asana увидела снижение задержки на 30% и ускорение инференса до 2,5 раза на ход агента, Box — рост качества на 11 пунктов при вдвое меньшей задержке. Такие сценарии — поддержка в реальном времени, браузерные задачи, массовая классификация — и есть родная территория модели.
Где Haiku 5.5 всё ещё уступает старшим моделям
Несмотря на рост, сложное агентное кодирование остаётся за Sonnet 5.5 и Opus 5.5. В Terminal-Bench 4.0 Haiku 5.5 набирает 39,2%, тогда как Sonnet 5.5 — 70,6%. Для многошаговых задач в терминале и длинных автономных сессий переплата за старшую модель пока оправдана. Haiku 5.5 лучше всего подходит для узких, повторяющихся задач — сжатия, сводок, работы субагента, — а не для полного цикла разработки.
Защита модели тоже стала строже. Кибербезопасностные ограничители Haiku 5.5 жёстче, чем у Haiku 4.5: защитные задачи остаются доступными, но пентестинг и смежные техники блокируются. Для организаций с расширенными задачами в биологии и кибербезопасности есть отдельные программы верификации.
С чего начать проверку
Начать стоит не с переноса всего процесса, а с одного повторяющегося сценария, где сегодня гоняется много коротких запросов: сводки, классификация, быстрые ответы на вопросы по документам. Прогнать его на Haiku 5.5 и сравнить стоимость и качество с тем, что используется сейчас. Если по качеству модель догоняет, а по цене уходит на порядок ниже — это и есть выгода, которую нельзя получить от старших моделей.
Полезный ориентир — разбор того, как выбрать LLM под задачу: там, где задача узкая и повторяющаяся, дешёвая быстрая модель почти всегда выигрывает у тяжёлой. А если главная боль — расход токенов, стоит посмотреть и на приёмы оптимизации расхода.
Дешёвая и быстрая модель теперь закрывает агентные задачи
Haiku 5.5 снимает прежнее ограничение компактной линейки: она впервые тянет агентные задачи, а не только короткие ответы. Для тех, кто строит агентов, это меняет расчёт — часть нагрузки, которую раньше отдавали старшим моделям, теперь можно снять на модель в разы дешевле без потери результата. Модель уже доступна на всех платформах под идентификатором claude-haiku-5-5.
Ссылки
Ссылки
- Документация: Claude Haiku 5.5 System Card
- Документация: Claude Haiku 5.5 в Claude Platform