 Vorobeoff
Выбрать LLM в 2026 — это как выбрать инструмент: молотком не режут, скальпелем не забивают гвозди.
За последние полгода рынок рванул: флагманы научились работать как автономные агенты, открытые модели подтянулись по качеству, а цены рухнули. Вопрос уже не «кто умнее», а «что выгоднее под вашу задачу». Этот гид помогает сопоставить модели по цене, контексту и силам — и не переплачивать за лишнее.
Что это
LLM (Large Language Model) — нейросеть, которая понимает запрос и генерирует текст, код, а теперь и изображения, видео, аудио. В 2026 году почти все ключевые модели поддерживают вызов инструментов, работу с файлами и длинные сессии без потери контекста.
Главное изменение года — переход от чат-бота к агенту. GPT-6 Astra, Claude Opus 5.5 и Gemini 4 Argon умеют сами планировать шаги, вызывать поиск и код, проверять результат и возвращаться к задаче. Открытые модели — DeepSeek V4, Kimi K3.1, Llama 4 — догоняют их по качеству при цене в разы ниже. Контекст в 1 млн токенов стал стандартом, а Llama 4 Scout даёт 10 млн.
Поэтому выбор модели сегодня
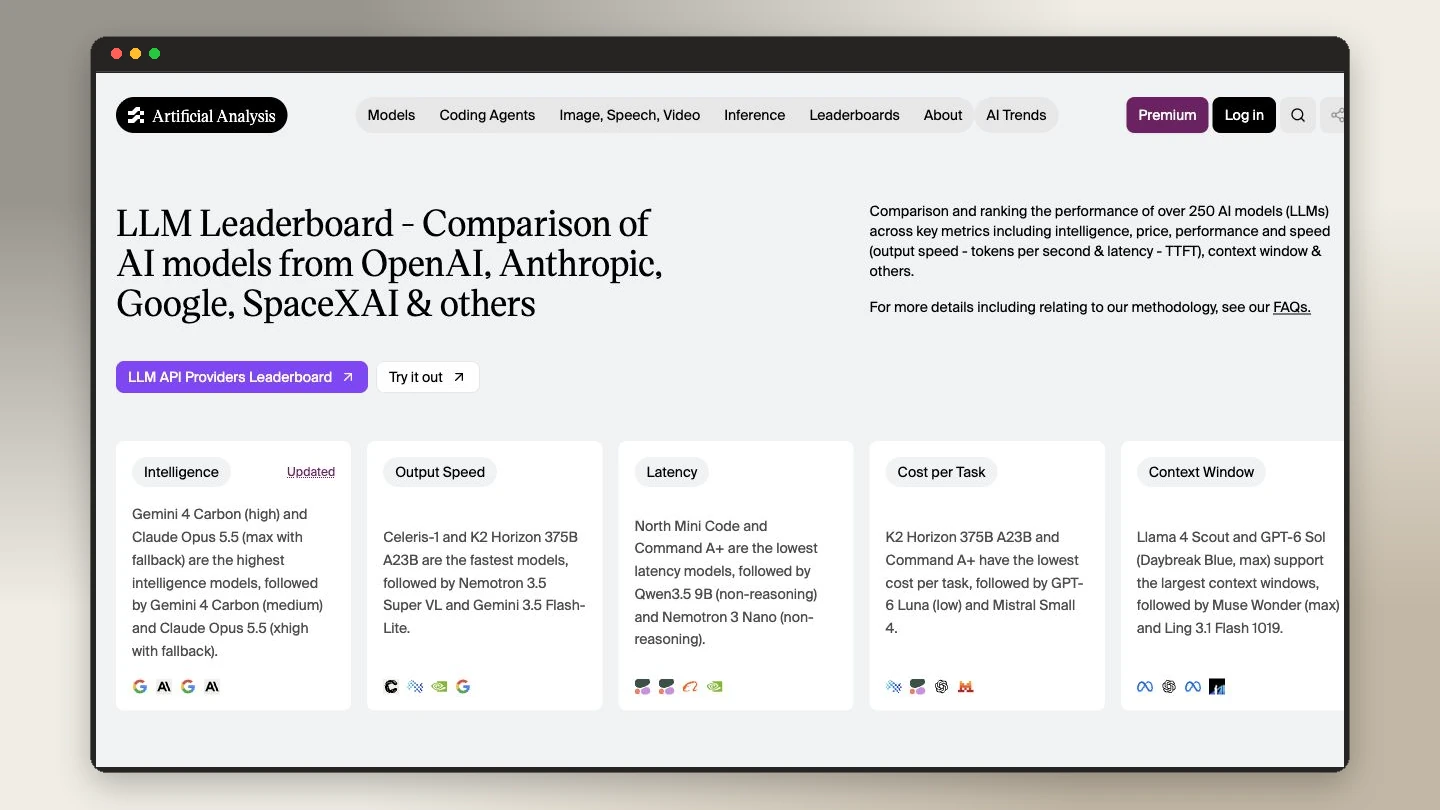
— это выбор баланса между интеллектом, скоростью, ценой и контролем над данными. Одна модель на всё почти всегда означает переплату или потерю качества. Для приватных сценариев помогает локальный RAG на EmbeddingGemma, который не требует сервера.
Зачем нужно
- Понять, какая модель подходит под кодинг, анализ документов или мультимодальность — и не брать флагман там, где хватит экономной.
- Сравнить цену и контекст: от $0.10 за 1 млн токенов у Haiku до $10/$50 у Astra, от 500K у Grok до 10M у Scout.
- Выбрать между облаком и своим сервером: открытые веса дают приватность и дообучение, облако — простоту.
- Спланировать бюджет с учётом кэширования и Batch API, которые режут цену до 50–90%.
- Избежать ловушек: забывания середины длинных документов, временных промо-цен и пиковых тарифов.
Как устроено
Рынок условно делится на четыре группы. Внутри группы модели решают схожие задачи, между группами разница — в цене и требованиях к инфраструктуре. Актуальные цены проверены на конец октября 2026.
| Группа | Модель | Контекст | Цена за 1M (вход / выход) | Сила |
|---|---|---|---|---|
Флагманы | Claude Opus 5.5 | 1M | $4 / $20 | № 1 по интеллекту, агенты и кодинг |
Флагманы | GPT-6 Astra | 1M | $10 / $50 | Автономная работа от задачи до результата |
Флагманы | Gemini 4 Argon | 1M | $2/$10 → $4/$20 с 01.12.2026 | Математика, наука, длинные генерации |
Флагманы | GPT-6.1 Sol | 1M | $2 / $10 | Кодинг в проде |
Открытые | DeepSeek V4 Pro | 1M | $1.32/$3.96 пик, $0.66/$1.98 офф-пик | MIT, лучшее цена/качество |
Открытые | Kimi K3.1 Pro | 1M | ~$3.68 | Длинные исследования |
Открытые | Llama 4 Maverick / Scout | 1M / 10M | Self-hosted | MoE, Scout — 10M контекст |
Открытые | Mistral Large 4 | 524K | ~$5.54 | Apache 2.0, европейская альтернатива |
Рабочие | Claude Sonnet 5.5 | 1M | $2 / $10 | Баланс для бизнеса |
Рабочие | GPT-6.1 Terra | 1M | $1 / $5 | Зрение и управление компьютером |
Экономные | DeepSeek V4.1 Flash | 1M | $0.30/$1.20 пик | Потоковые задачи |
Экономные | Claude Haiku 5.5 | 1M | $0.10 / $0.50 | Скорость 241 токен/с |
Экономные | Gemini 3.8 Flash | 1M | $0.75 / $3.75 | Быстрые агенты |
Флагманы задают потолок качества
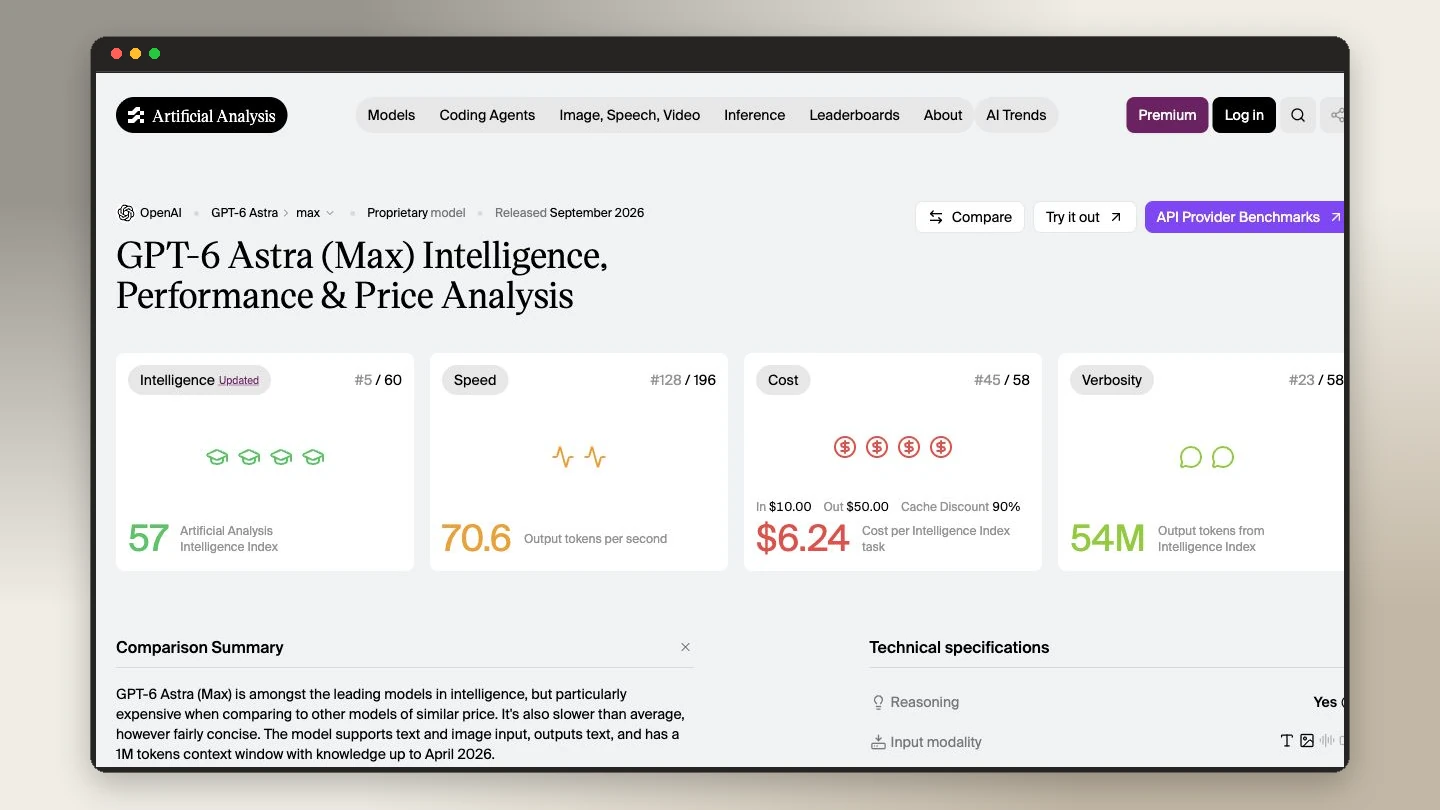
и умеют вести долгие агентные сессии. Claude Opus 5.5 сейчас лидирует в рейтинге Artificial Analysis по интеллекту (58 баллов), поддерживает команды агентов и адаптивное мышление, при этом заметно дешевле GPT-6 Astra при том же уровне. Gemini 4 Argon силён в мультимодальности и генерации до 1M токенов на выходе.
Открытые модели ставят на контроль: DeepSeek V4 Pro идёт по MIT-лицензии и в офф-пик стоит вдвое дешевле пика, Kimi K3.1 Pro хороша для длинных исследований, а Llama 4 Scout держит в голове до 10 млн токенов — целую библиотеку в одном запросе. Цена здесь — инфраструктура: для комфортной скорости нужен H100 или кластер.
Рабочие и экономные закрывают 90% бизнес-задач. Sonnet 5.5 даёт 54 балла интеллекта за $2/$10 и поддерживает Batch API, Terra за $1/$5 уверенно управляет интерфейсами, а DeepSeek Flash и Haiku 5.5 обрабатывают поток по $0.10–$0.30 за 1M. Токены рассуждения у флагманов считаются как выходные — длинная цепочка размышлений может стоить дороже самого ответа, а промо-цены Gemini закончатся 1 декабря и 1 января. Пик у DeepSeek дороже офф-пика вдвое, поэтому тяжёлые батчи выгоднее ставить на ночь и выходные по UTC.
Когда использовать
| Ситуация | Рекомендация | Почему |
|---|---|---|
Сложный кодинг, агенты | Claude Opus 5.5 или GPT-6 Astra | Лидеры SWE-bench и Terminal-Bench, ведут долгие сессии |
Научный анализ, рассуждения | Claude Opus 5.5 / Gemini 4 Argon | Лучшие на HLE и математике |
Видео, аудио, изображения | Gemini 4 Argon | Нативная мультимодальность |
Свой сервер, приватность | DeepSeek V4 Pro / Llama 4 / Mistral Large 4 | Открытые веса, MIT/Apache 2.0, дообучение |
Книги, логи, архивы на 1M+ | Llama 4 Scout (10M) | Самый большой контекст на рынке |
Продакшен API без переплат | Claude Sonnet 5.5 / GPT-6.1 Sol | Высокий интеллект за $2/$10, кэш до 90% |
Поток и экономия | DeepSeek V4.1 Flash / Claude Haiku 5.5 | От $0.10/$0.50 за 1M, Batch -50% |
Быстрый ответ без инструментов | Grok 4.7 (500K) | Сильные рассуждения из коробки |
Правило простое: не берите флагман для классификации — Haiku 5.5 даст тот же результат в 100 раз дешевле. Не игнорируйте кэш: prompt caching у Claude ($0.10–$0.20) и OpenAI ($0.01–$1.00) срезает цену в 5–10 раз. И всегда тестируйте на своих 10+ примерах — бенчмарки не гарантируют результат на ваших данных, а 1M окно без RAG теряет середину длинных документов.
Пример
Команда переводит поддержку на ИИ: чат-бот отвечает на типовые вопросы, а сложные обращения уходят человеку с кратким резюме.
- Для чата берут Claude Haiku 5.5 или DeepSeek Flash — дёшево, быстро, контекст 1M хватает на историю диалога.
- Для резюме и классификации — GPT-6.1 Terra: она видит скриншоты и заполняет карточку обращения.
- Для еженедельного отчёта по всем обращениям — Gemini 4 Argon или Llama Scout: один проход по массиву логов без нарезки.
- Для рефакторинга самого бота — Claude Opus 5.5 в паре с командой агентов, с кэшем системного промпта и Batch для ночных прогонов.
Итог: четыре модели вместо одной «самой умной» — дешевле, быстрее и надёжнее. Один бенчмарк здесь не решает, решает стоимость задачи и контроль над данными.
В 2026 году выбирать LLM — значит выбирать экономику задачи. Флагманы нужны там, где агент должен долго думать и действовать сам, рабочие — для продакшена, экономные — для потока, открытые — для приватности. Сопоставьте контекст, цену с учётом кэша и пиков, и проверьте на своих данных — это и есть весь выбор.
Ссылки
- Документация: Artificial Analysis — LLM Leaderboard
- Документация: OpenAI — API Pricing
- Документация: Anthropic — Claude Pricing