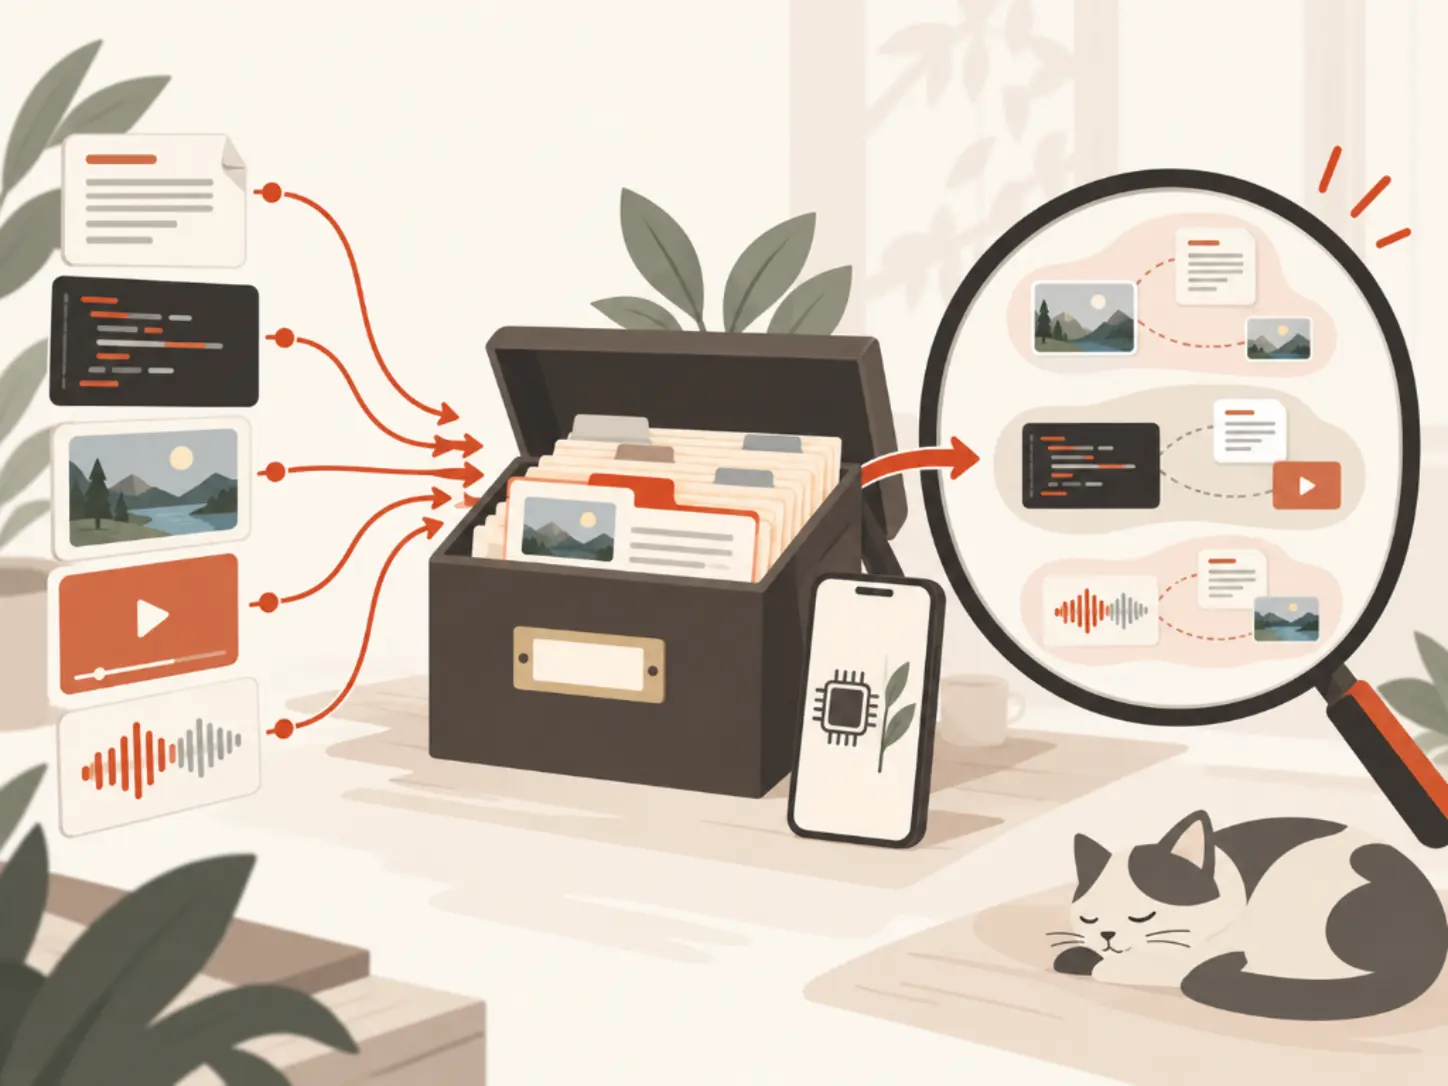
Google DeepMind выпустила EmbeddingGemma 2 — открытую модель для построения эмбеддингов. Она приводит текст, код, изображения, видео и звук к общему векторному пространству и может работать прямо на устройстве. Разбираю, что это меняет для поиска и RAG и какие у модели есть ограничения.
Семантический поиск по разным форматам обычно требует нескольких моделей. Например, для поиска по видео сначала распознают речь или описывают кадры, а затем отдельная модель превращает полученный текст в эмбеддинги. Каждый дополнительный этап увеличивает задержку, расход памяти и число возможных ошибок. Если обработка идёт в облаке, туда же приходится отправлять данные.
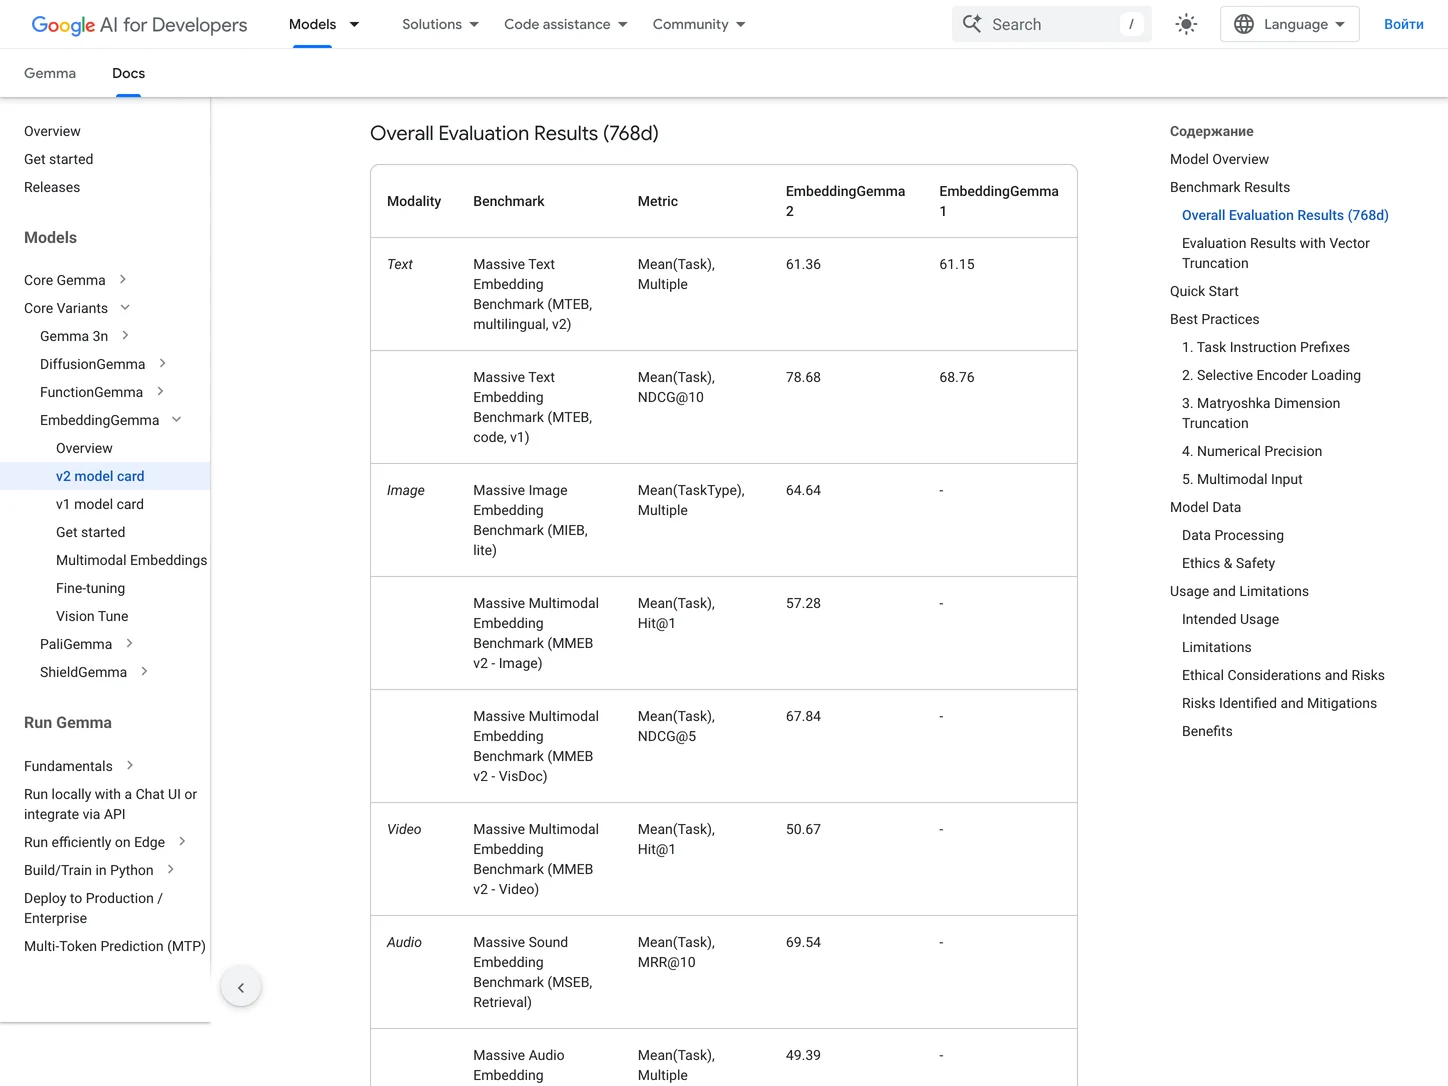
EmbeddingGemma 2 сокращает эту цепочку. Одна компактная модель приводит текст, код, изображения, видео и звук к общему 768-мерному пространству. Модель выпущена 6 октября 2026 года, распространяется по лицензии Apache 2.0 и построена на архитектуре Gemma 4.
Одна модель вместо нескольких
Полная конфигурация содержит 740 млн параметров и состоит из нескольких модулей. Текстовая часть отвечает за текст и код и содержит 270 млн параметров. К ней можно подключить модуль для изображений на 170 млн параметров и модуль для звука на 300 млн. Их можно загружать отдельно: если нужен только поиск по тексту, вся мультимодальная конфигурация не требуется.
Все данные попадают в одно 768-мерное пространство. Поэтому текстовый запрос можно напрямую сравнивать с вектором изображения или звука. Одна модель может искать фотографию по текстовому описанию или нужный момент в видео по голосовому запросу. Контекст составляет 8192 токена, у первой EmbeddingGemma было 2048. Модель обрабатывает до 327 секунд аудио, то есть примерно пять с половиной минут.
Главная ставка — работа без облака
Google показывает работу модели на Pixel 11 Pro. Текстовая часть занимает около 191 МБ активной памяти, а полная мультимодальная конфигурация после квантизации, то есть хранения весов с меньшей точностью, — около 567 МБ. Это позволяет запускать поиск прямо на устройстве, не отправляя пользовательские данные на сторонние серверы и не полагаясь на постоянное подключение к интернету.
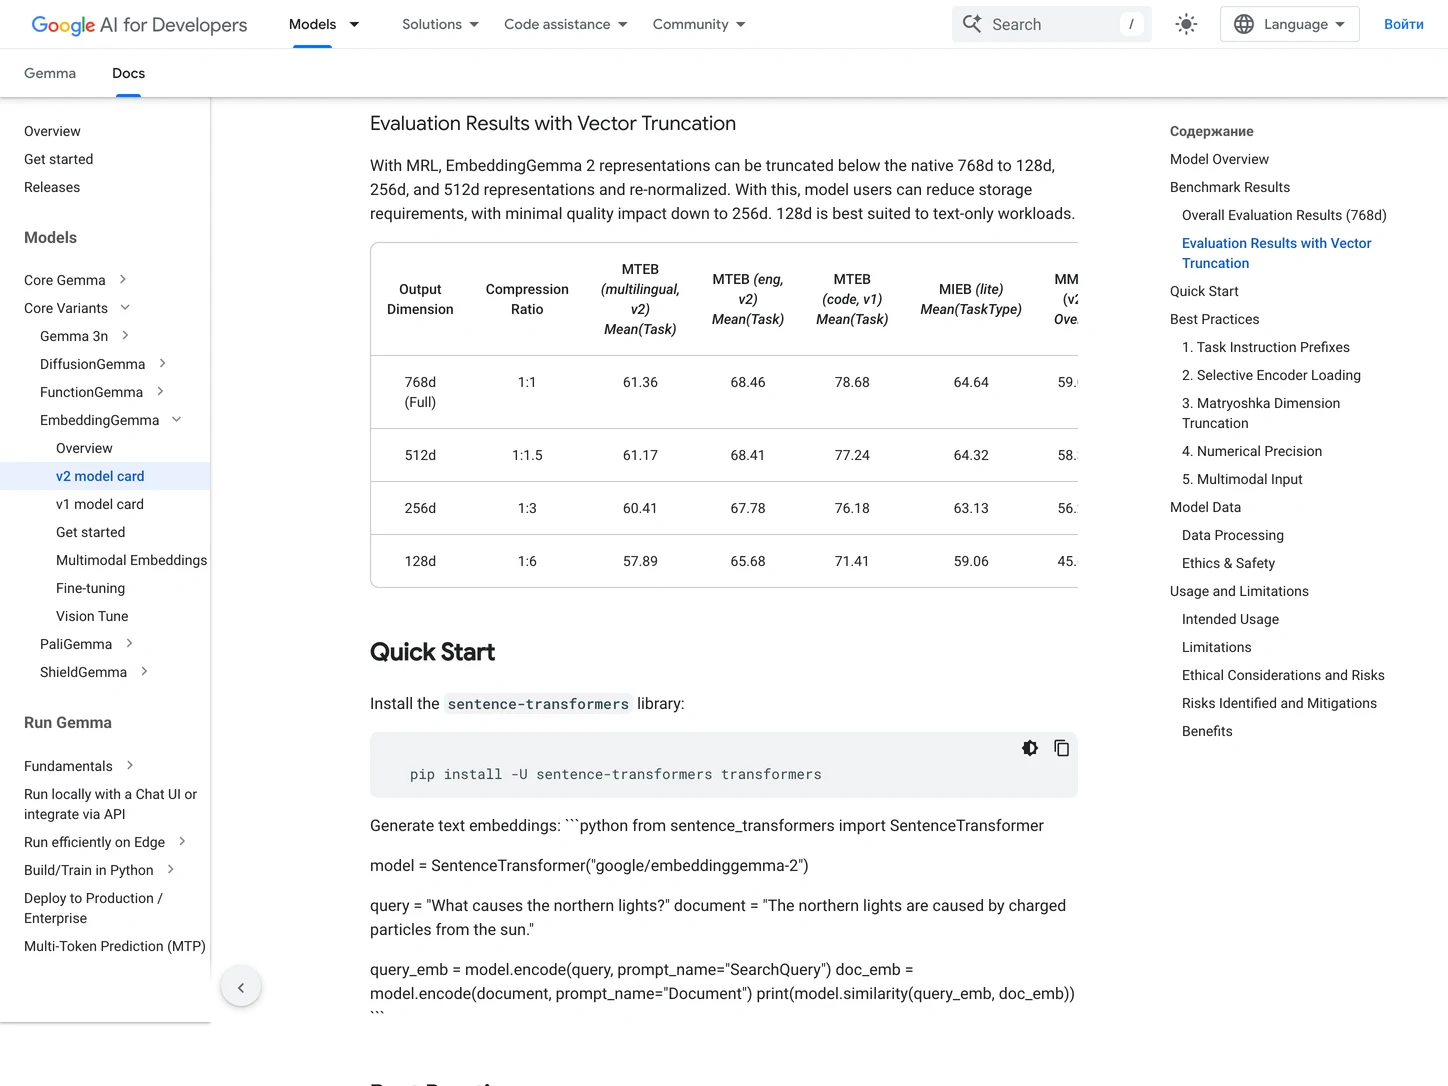
Ещё одна полезная возможность — Matryoshka Representation Learning. Вектор из 768 измерений можно сокращать до 512, 256 или 128, сохраняя рабочее представление данных. Миллион векторов размерностью 768 в bfloat16 занимает около 1,5 ГБ, а размерностью 128 — около 250 МБ. Для крупных векторных баз это примерно шестикратная экономия места и меньшая нагрузка при поиске.
Google также показывает zero-shot intent routing — маршрутизацию запросов без дополнительного обучения. Модель сопоставляет запрос пользователя с описаниями доступных действий и выбирает подходящее. Здесь EmbeddingGemma 2 используется уже не для поиска, а для маршрутизации внутри приложения.
Что это даёт на практике
Самый понятный сценарий — локальный мультимодальный поиск. Пользователь вводит текстовый запрос, а приложение ищет по фотографиям, видео и аудио прямо на устройстве, без загрузки личных файлов в облако. Другой вариант — единая база из документов, изображений и видео, поверх которой работает RAG. То же векторное пространство можно использовать и для маршрутизации запросов внутри агента или приложения.
Главное здесь в том, что мультимодальный поиск можно собрать на одной компактной модели. Она распространяется по лицензии Apache 2.0 и поддерживается через sentence-transformers, MediaPipe Tasks и LiteRT. Google также готовит интеграцию с ML Kit на Android.
О чём стоит помнить до первого запуска
Сокращение вектора до 128 измерений заметно снижает качество мультимодального поиска. По оценкам Google, для изображений, видео и речи результат падает примерно до 75% от исходного уровня, тогда как текст и код сохраняют около 90%. Поэтому для изображений и звука Google рекомендует не опускаться ниже 256 измерений.
Есть и технические ограничения. Модель рассчитана на bfloat16 или float32; использование float16 может привести к некорректным векторам без явной ошибки. Аудио принимается в моно с частотой 16 кГц. Для видео по умолчанию берётся один кадр в секунду. Общий контекст в 8192 токенов делят все модальности, поэтому при смешанном вводе доступный объём для каждой из них уменьшается.
Кому пригодится
Важно не путать её с Gemini Embedding 2. Это более крупная мультимодальная модель эмбеддингов, доступная через Gemini API. EmbeddingGemma 2 рассчитана на открытые веса, локальный запуск и устройства с ограниченными ресурсами. Это разные сценарии использования.
Модель особенно интересна разработчикам мобильных приложений с локальным поиском по фото, видео и аудио, командам, которые собирают собственный RAG на устройствах с ограниченными ресурсами, и тем, кому нужна быстрая маршрутизация запросов без отдельного классификатора. Если вы уже запускали BGE-M3 на своём сервере, EmbeddingGemma 2 решает немного другую задачу: её сильная сторона — локальная работа на устройствах и офлайн-сценарии.
Проверять модель лучше на небольшом наборе собственных файлов. Постройте для них эмбеддинги, прогоните реальные запросы и сравните результаты. Отдельно стоит измерить расход памяти в текстовой конфигурации и проверить, насколько меняется качество при сокращении векторов до 256 измерений.
Векторный поиск переезжает на устройство
Здесь важен не сам факт выхода ещё одной модели эмбеддингов, а то, где теперь можно запускать векторный поиск. Если мультимодальная модель помещается примерно в полгигабайта памяти на телефоне, локальный поиск по личным фотографиям, видео и заметкам становится гораздо доступнее. Облачный поиск никуда не исчезнет, но часть данных, которые пользователь не хочет отправлять на сервер, можно будет индексировать прямо на устройстве.
Ссылки
Ссылки
- Документация: EmbeddingGemma 2 model card
- Сайт: EmbeddingGemma — Google DeepMind