6 октября 2026 года Mistral представила Mistral Large 4 в статусе Public Preview. Это мультимодальная модель с открытыми весами на 1,05 трлн параметров. При обработке каждого токена активны только 49 млрд.
Именно это соотношение здесь важнее самого числа «триллион».
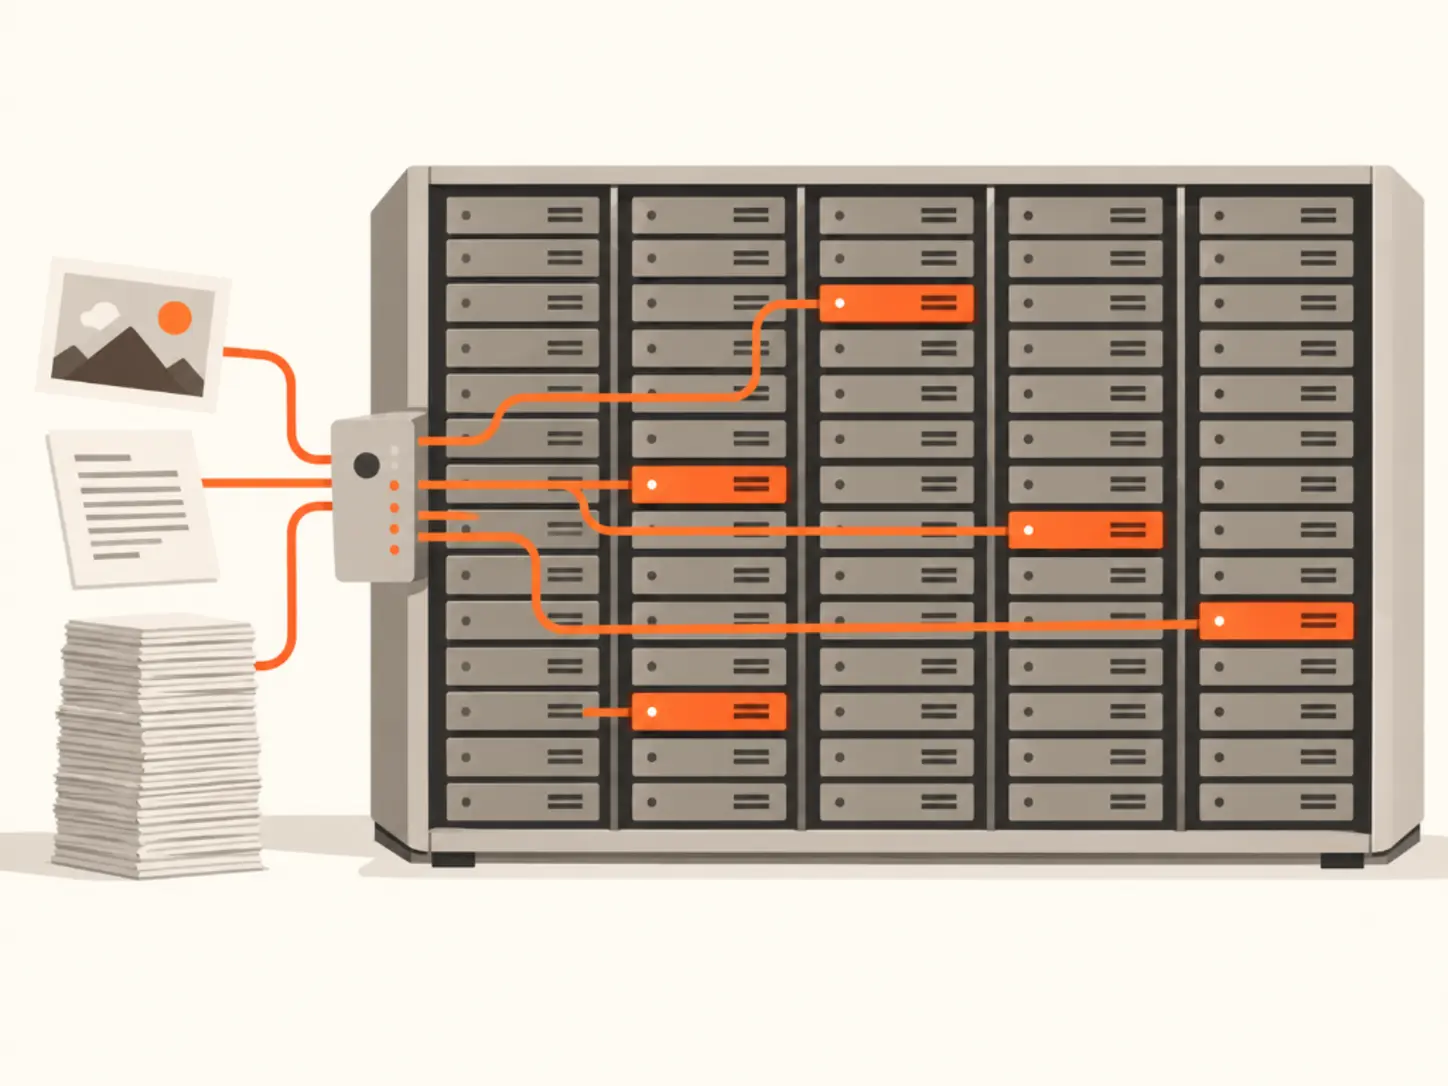
В плотной модели при обработке токена задействуется весь набор параметров. Mistral Large 4 использует архитектуру Mixture-of-Experts (MoE): модель разделена на «экспертов», а для конкретного токена подключается только часть из них. Токен — это небольшой фрагмент текста, с которым модель работает на каждом шаге генерации.
Триллион параметров, но не на каждом токене
У Mistral Large 4 1,05 трлн параметров всего и 49 млрд активных. Получается, что на одном токене задействуется примерно одна двадцать первая часть всей модели.
Это не означает, что Large 4 автоматически умнее моделей с меньшим числом параметров. Размер сам по себе не гарантирует качество. Но MoE позволяет увеличить общую ёмкость модели, не заставляя её использовать все параметры при каждом вычислении.
Для сравнения, у Mistral Large 3 было 675 млрд параметров всего и 41 млрд активных. В Large 4 общий объём вырос примерно на 56%, а активная часть — примерно на 20%. То есть Mistral заметно увеличила размер модели, не увеличивая вычисления на токен в той же пропорции.
Похожий подход используется и в других крупных MoE-моделях, например в Kimi K2.7 Code.
Отдельная работа с изображениями и контекст на 1 млн токенов
В официальной карточке Mistral указано, что Large 4 получила vision-энкодер на 1,6 млрд параметров. Он отвечает за работу с изображениями, поэтому модель может принимать и текст, и визуальные данные.
Максимальный контекст составляет 1 млн токенов. Это очень большой объём: в один запрос можно передать крупную документацию, большой набор документов или значительную часть кодовой базы. Поместится ли проект целиком, зависит от его реального размера.
Длинный контекст особенно полезен там, где модели нужно одновременно видеть много связанных материалов и отвечать по ним без постоянного разбиения на отдельные запросы.
Что поддерживает API
По официальной документации Mistral Large 4 поддерживает structured outputs, function calling, Document QnA, Chat Completions, пакетную обработку, Agents & Conversations и встроенные инструменты.
Проще говоря, модель можно использовать не только как чат. Она умеет возвращать данные в заданной структуре, вызывать внешние функции, работать с документами и быть частью агентного сценария.
Mistral называет Large 4 своей state-of-the-art моделью общего назначения с открытыми весами. Здесь лучше использовать термин open-weight, а не open-source: доступ к весам и условия лицензии — разные вещи.
Что важно учитывать
Large 4 пока находится в Public Preview, а не в статусе General Availability. Для критичных рабочих процессов я бы сначала проверял её на отдельном сценарии и только потом думал о переносе нагрузки.
Есть ещё один важный момент с MoE. 49 млрд активных параметров не означают, что модель стала маленькой. Активная часть влияет на объём вычислений при обработке токена, но все 1,05 трлн параметров всё равно нужно хранить и обслуживать при самостоятельном развёртывании. Поэтому Large 4 нельзя воспринимать как модель для обычного ноутбука только из-за числа «49 млрд активных».
Кому стоит попробовать Mistral Large 4
В первую очередь модель интересна тем, кто хочет работать с open-weight моделями и при этом получить длинный контекст, мультимодальность и инструменты для агентных сценариев.
Она также выглядит интересно для работы с большими наборами документов и кодом, где контекст в 1 млн токенов действительно может быть полезен.
Если вы строите ИИ-агента, Large 4 поддерживает function calling и структурированные ответы. Но оценивать её стоит на своей задаче: взять реальный сценарий, прогнать одинаковые данные через Large 4 и текущую модель, а затем сравнить качество, скорость и стоимость.
Если пока неясно, по каким критериям сравнивать модели, можно начать с материала как выбрать LLM под задачу.
Главное здесь не триллион
Само число 1,05 трлн хорошо выглядит в заголовке, но архитектурно важнее другое: при каждом токене Large 4 использует 49 млрд параметров.
Это и есть главный смысл MoE в этой модели. Mistral увеличила общий размер модели намного сильнее, чем активную часть. Насколько хорошо это сработало на практике, покажут независимые тесты. Одного числа параметров для вывода о качестве недостаточно.
Ссылки
Ссылки
- Документация: Mistral Large 4 — model card