 Vorobeoff
RAG — способ заставить языковую модель отвечать по вашим документам, а не по тому, что она запомнила при обучении. Система находит нужные фрагменты в базе знаний и передаёт их модели вместе с вопросом — так ответ опирается на проверенные источники.
Что это
RAG (Retrieval-Augmented Generation) — подход, при котором искусственный интеллект сначала ищет информацию в доступных ему документах, а затем использует найденное для ответа. Представьте сотрудника, который прежде чем ответить на вопрос, открывает инструкцию или договор и находит нужный пункт.
Например, вы загружаете регламент компании и спрашиваете: «Кто согласовывает закупку дороже 500 тысяч рублей?» Система находит соответствующий раздел и передаёт его языковой модели. Та формулирует понятный ответ и, если сервис поддерживает ссылки на источники, показывает, откуда взяла информацию.
RAG не переобучает модель и не гарантирует отсутствие ошибок. Он даёт ей дополнительный контекст: конкретные документы, с которыми нужно свериться.
RAG не делает модель умнее — он даёт ей нужный контекст в нужный момент.
Зачем нужно
- Ответы по внутренним материалам — сотрудники могут задавать вопросы по инструкциям, регламентам, договорам и базе знаний компании.
- Быстрый поиск — вместо просмотра десятков файлов можно получить короткий ответ и перейти к нужному месту в документе.
- Работа с обновлениями — когда документы меняются и поисковая база обновляется, система начинает использовать новые версии без переобучения языковой модели.
- Проверяемость — ссылки на документы позволяют сверить ответ с первоисточником.
- Основа для автоматизации — тот же поиск можно подключить к чат-боту поддержки или внутреннему ИИ-агенту.
Как устроено
Для пользователя всё выглядит просто: он задаёт вопрос и получает ответ. Внутри системы происходит несколько шагов.
| Этап | Что происходит | Простой пример |
|---|---|---|
Загрузка | Система получает документы и извлекает текст | PDF с договором и инструкции в Word |
Разбиение | Большие документы делятся на небольшие смысловые фрагменты | Отдельные разделы и пункты договора |
Индексация | Фрагменты подготавливаются для быстрого поиска | Создаётся поисковая база |
Поиск | По вопросу отбираются подходящие фрагменты | Находится пункт о сроке действия договора |
Ответ | Языковая модель использует найденный текст | «Договор действует до 31 декабря» со ссылкой на пункт |
Один из распространённых способов поиска — эмбеддинги. Это числовые представления текста, которые помогают находить похожие по смыслу фразы, даже если в вопросе использованы другие слова. Для хранения и поиска таких представлений используют, например, Qdrant, Weaviate или pgvector.
Однако поиск по смыслу не всегда хорошо справляется с артикулами, номерами договоров и точными формулировками. Поэтому в более развитых системах его объединяют с поиском по ключевым словам. Такой подход называют гибридным поиском. Дополнительно результаты можно перепроверять и сортировать по релевантности — это называется реранкингом.
Для первого проекта необязательно разбираться во всех этих компонентах. В готовых сервисах загрузка, поиск и формирование ответа уже объединены в одном интерфейсе.
Когда использовать
| Ситуация | Что подойдёт |
|---|---|
Нужно разобраться в нескольких PDF или отчётах | Готовый сервис для вопросов по документам, например NotebookLM |
Нужен внутренний помощник по инструкциям компании | База знаний с поиском и доступом к выбранной языковой модели |
Документы часто обновляются | Система с автоматической синхронизацией и повторной индексацией |
Вопросы содержат артикулы, номера и точные названия | Гибридный поиск: по смыслу и ключевым словам |
Есть требования к размещению данных | Решение на собственном сервере с подходящими правилами доступа |
Не каждую задачу нужно решать через RAG. Если требуется один раз кратко пересказать небольшой файл, проще передать его модели целиком. А если нужно регулярно отвечать на вопросы по сотням документов, поисковая система становится гораздо полезнее.
Пример
Попробуем сам принцип работы без программирования на примере NotebookLM — сервиса Google для работы с собственными источниками. Это простой способ почувствовать, как устроены ответы по документам, хотя он не заменяет настройку полноценной корпоративной RAG-системы.
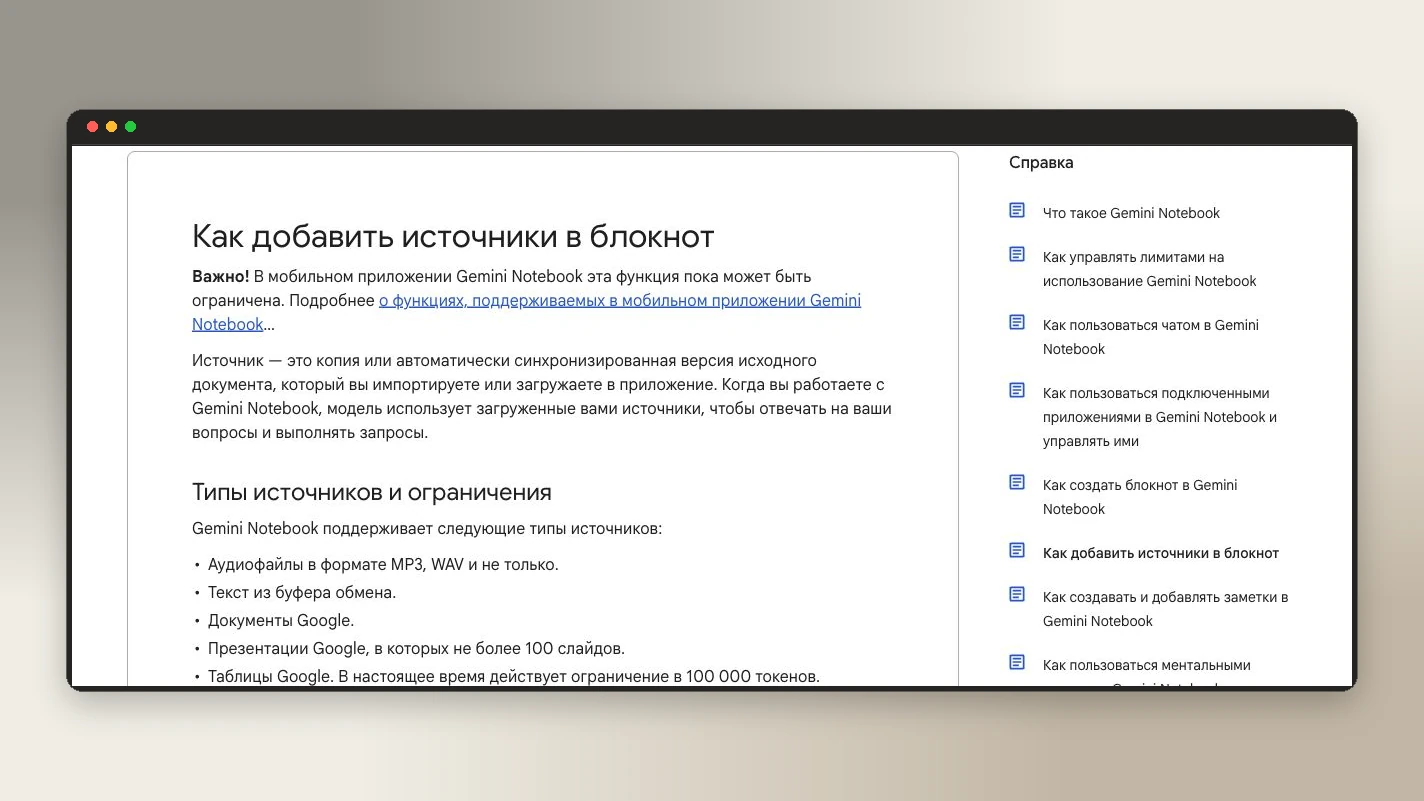
- Откройте NotebookLM и создайте новый блокнот.
- Добавьте один или несколько PDF, текстовых файлов или документов из поддерживаемых источников.
- Задайте конкретный вопрос, ответ на который есть в этих документах. Например: «На каких условиях можно расторгнуть договор?»
- Прочитайте ответ и откройте ссылки на использованные фрагменты. Сравните формулировку с оригиналом.
- Задайте второй вопрос, ответа на который в файлах нет. Посмотрите, как сервис справляется с отсутствующей информацией.
Для проверки лучше взять документы, содержание которых вам хорошо знакомо. Например, небольшую инструкцию с явно указанными сроками и ответственными. Так легче увидеть, нашла ли система нужный пункт.
Что должно получиться: вы задаёте вопрос обычным языком, получаете ответ по загруженным материалам и можете перейти к источнику. Если сервис не находит нужной информации, ответ следует перепроверить, а не принимать на веру.
А если нужен собственный RAG?
Тогда готового интерфейса может оказаться недостаточно. Для своей системы обычно выбирают инструмент загрузки документов, модель эмбеддингов, поисковое хранилище и языковую модель.
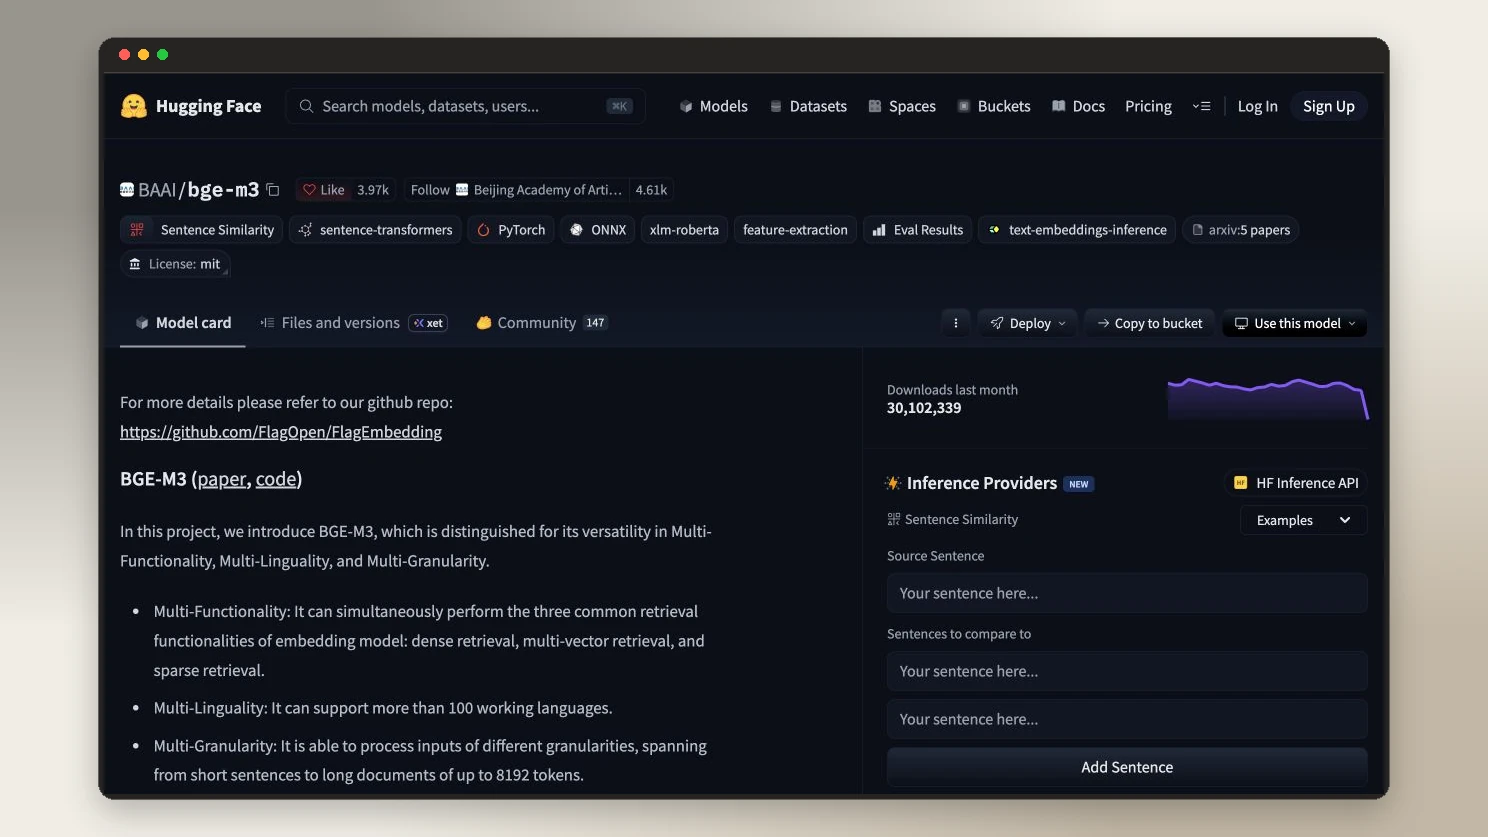
Например, можно использовать BGE-M3 для представления текста, Qdrant для хранения и поиска, а языковую модель — для окончательного ответа. Связать компоненты помогают LangChain или LlamaIndex. Такой вариант требует настройки, зато даёт больше контроля над данными, доступами и логикой поиска.
Для сложных задач существуют Agentic RAG и GraphRAG. Первый позволяет агенту выполнять несколько поисков и уточнять запросы; второй помогает работать со связями между сущностями. Для обычных вопросов по инструкциям начинать с них не нужно.
Ограничения
| Пункт | Пояснение |
|---|---|
Ошибки остаются возможными | — модель может неверно понять даже правильно найденный фрагмент. |
Качество зависит от документов | — скан без распознанного текста, неясная таблица или противоречивые версии ухудшают ответы. |
Новые файлы нужно индексировать | — обновление исходного документа не всегда сразу отражается в ответах. |
Доступы нужно разграничивать | — сотрудник не должен получать через чат сведения из документов, на которые у него нет прав. |
Поиск не равен полному анализу | — для сравнения всего большого отчёта иногда нужен другой способ обработки, а не выбор нескольких фрагментов. |
Антипаттерны
| Пункт | Пояснение |
|---|---|
Загружать всё подряд — устаревшие копии и дубли создают противоречия. | Лучше определить набор актуальных источников. |
Верить ответу без проверки | — даже ответ со ссылкой нужно сверять с соответствующим пунктом, особенно в юридических и финансовых вопросах. |
Полагаться только на смысловой поиск | — точные номера, коды и артикулы могут потребовать поиска по ключевым словам. |
Сразу строить сложную архитектуру | — сначала проверьте простую систему на реальных вопросах, затем добавляйте новые компоненты по необходимости. |
Игнорировать конфиденциальность | — перед загрузкой договоров и внутренних документов проверьте условия обработки данных выбранным сервисом. |
Чеклист
| Пункт | Пояснение |
|---|---|
Выберите документы | — начните с небольшой понятной подборки, а не со всего архива. |
Подготовьте источники | — проверьте, что текст извлекается, файлы читаются, а версии не противоречат друг другу. |
Составьте вопросы | — придумайте 10–15 реальных вопросов, на которые в документах есть ответы. |
Проверьте ссылки | — убедитесь, что система ведёт к нужным страницам и пунктам. |
Проверьте отсутствие ответа | — задайте вопросы, которых документы не покрывают. |
Продумайте обновления и доступы | — определите, кто добавляет новые версии и кому какие материалы доступны. |
Ссылки
- Документация: NotebookLM — добавление источников
- Документация: Qdrant
- Документация: LangChain
- Репозиторий: BAAI/bge-m3
По теме
- База знаний: BGE-M3: локальные эмбеддинги для поиска и RAG
- База знаний: Firecrawl: как скормить ИИ любой сайт без парсинга
- База знаний: ИИ-агенты: что это, как работают и зачем нужны