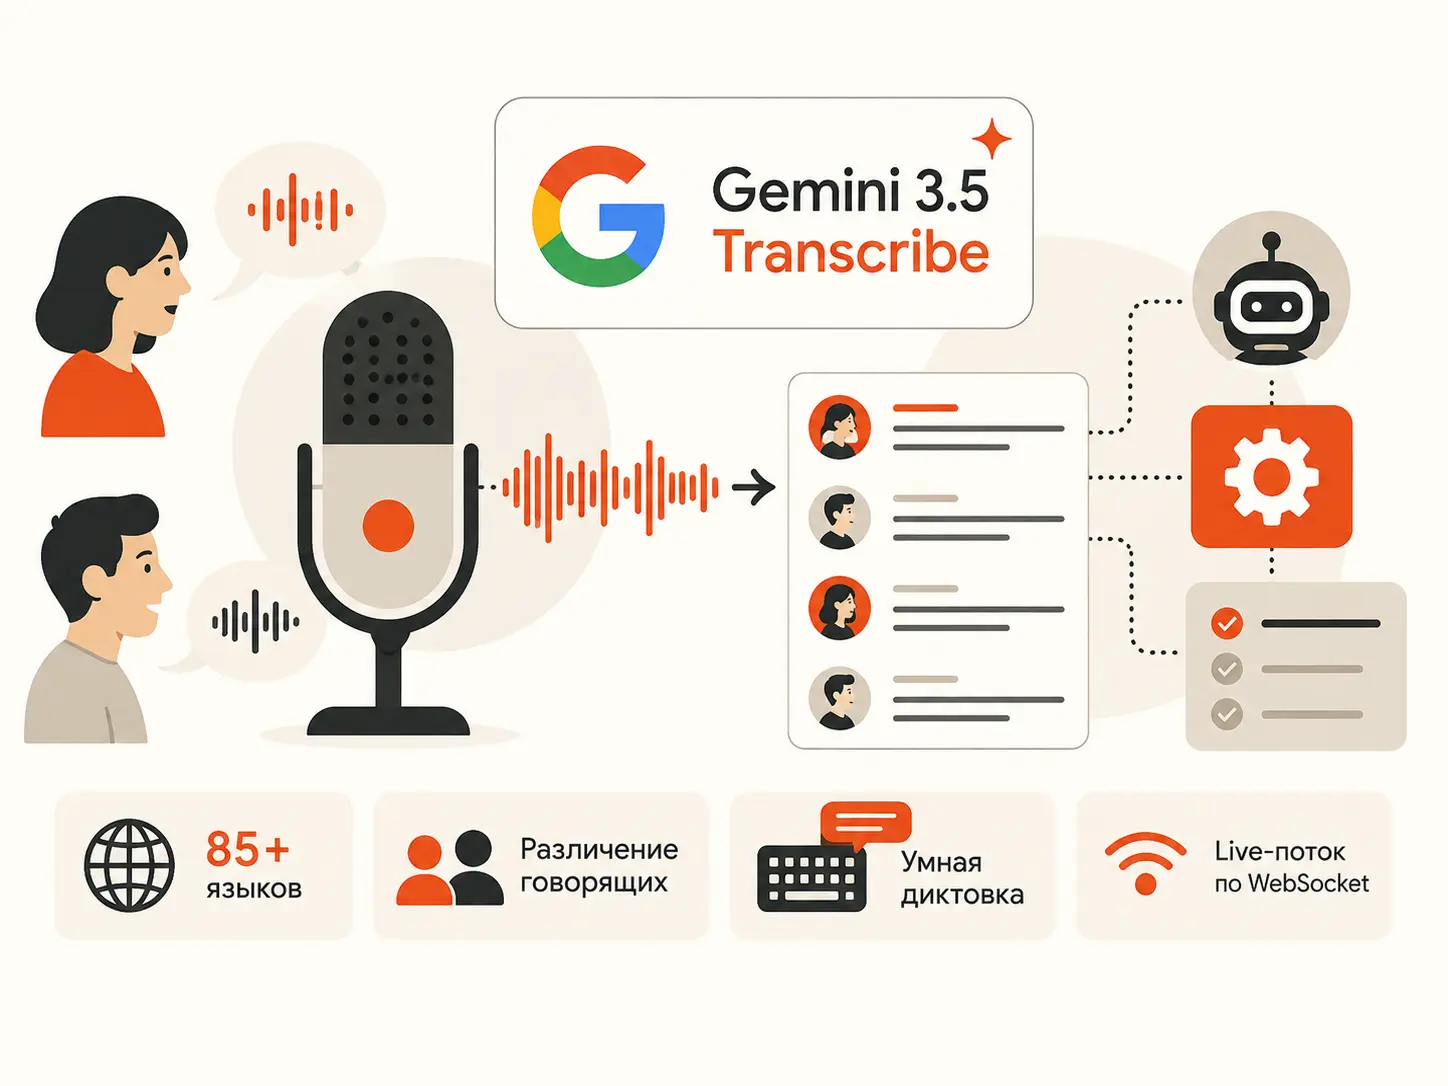
Google выпустил специализированную модель распознавания речи — Gemini 3.5 Transcribe. Она превращает аудио в чистый текст: снимает слова-паразиты, различает говорящих, ставит метки времени на каждое слово и подстраивается под собственный словарь терминов. Модель открыта в Gemini API в режиме общедоступного предварительного доступа: один вариант — для файлов, второй — для живого потока. Для приложений и агентов это значит, что слой преобразования голоса в текст больше не требует отдельного стека.
Любой голосовой сценарий начинается с одного и того же шага: из живого звука нужно сделать текст, с которым может работать система. До сих пор это означало отдельный слой — сторонняя служба распознавания речи, свой ключ, свои лимиты, свой формат ошибок. Текст приходил сырым: паузы «э-э-э», самопоправки, номера заказов слитно, смешение русского и английского — чистку выполнял следующий компонент.
Типичная цепочка выглядела так: запись уходит в сервис распознавания, результат поступает в языковую модель, дальше — в агента, который обновляет карточку в CRM или ставит задачу. Чем больше звеньев, тем больше точек отказа: разные учётные записи, разные договоры на данных, разная задержка.
Gemini 3.5 Transcribe сдвигает эту схему. Распознавание стало одним вызовом внутри того же API, откуда работает сам агент. Голосовая цепочка сбрасывает промежуточное звено — и с ним отдельный стек. Разберём, на что модель способна, где она работает и на какие ограничения натыкаться ещё в постановке задачи.
Распознавание речи переезжает в общий API
Gemini 3.5 Transcribe — модель преобразования речи в текст семейства Gemini 3.5. Она доступна в Google AI Studio и в Gemini Enterprise Agent Platform в статусе общедоступного предварительного доступа. Раньше Google предлагал для этой задачи модель Chirp 3 в отдельном сервисе; теперь распознавание встроено прямо в Gemini API.
Модель поставляется в двух вариантах под разный тип сценария. Идентификатор gemini-3.5-transcribe принимает готовые аудиофайлы длительностью до часа — встречи, записи звонков, интервью. Идентификатор gemini-3.5-transcribe-live работает через Live API по WebSockets: соединение открыто, звук идёт непрерывным потоком, текст приходит с задержкой меньше секунды. Первый вариант — для работы с уже записанным архивом, второй — для приложений, где голос обрабатывается в реальном времени.
Важно: один и тот же идентификатор с суффиксом live и без — это разные контракты. Потоковый вариант принимает до десяти минут на сессию и не умеет различать говорящих по факту завершения файла. Выбирать нужно под сценарий: архив звонков → unary-вариант, живой диалог → live.
Что модель умеет — по пунктам и цифрам
Документация фиксирует несколько возможностей, которые определяют, подходит ли модель под конкретный процесс.
- Языки. Свыше 85 языков и диалектов, включая русский, украинский, английский, немецкий, китайский и арабский. Определение языка автоматическое; модель корректно переносит смену языка посреди фразы.
- Различение говорящих. Модель приписывает реплики конкретному собеседнику. Обработка записей — до восьми говорящих; присвоение имён трём и более собеседникам помечено как экспериментальная возможность.
- Метки времени. Для каждого слова возвращается точная метка на шкале аудио — это нужно для кликабельных расшифровок, поиска по записи, нарезки фрагментов. Доступно только в файловом варианте.
- Умная диктовка. Модель снимает слова-паразиты и междометия, корректно оформляет номера, адреса, индексы, самопоправки вроде «встречаемся во вторник — нет, в среду».
- Собственный словарь. Можно передать до 1000 терминов — фамилии, названия продуктов, профессиональную лексику. Практика применения показывает, что наилучший эффект достигается на словаре объёмом до 100 терминов: слишком длинный список начинает влиять на точность.
Точность измеряется через процент ошибочно распознанных слов — это называется Word Error Rate, сокращённо WER. Чем ниже значение, тем чище результат. По данным Artificial Analysis, модель показывает 4,0% WER в потоковом режиме и 2,6% в файловой записи. На многоязычном наборе FLEURS по самым распространённым языкам результат составил 5,50% в потоке и 5,04% в файлах — заметно лучше, чем у предыдущей модели Chirp 3. Задержка до финальной расшифровки при этом сократилась на семьдесят процентов.
Артикулы, буквенно-цифровые строки, артикулы каталогов и почтовые индексы модель распознаёт отдельно: понимает, когда человек проговаривает буквы по буквам и когда — целое слово. В документации это описано как форматирование, учитывающее намерение говорящего.
Инсайт: цифры WER показывают качество на чистом и на шумном звуке. Разрыв между файловой и потоковой записью — закономерность: живой поток лишён возможности «взглянуть вперёд» в сигнале, поэтому точность ниже. Это ожидаемое поведение всех потоковых систем, не уникальный минус этой модели.
Живой поток по WebSocket: для диктовки и голосовых агентов
Потоковый вариант открывает двустороннее соединение. Клиент отсылает звук фрагментами, сервер возвращает частичную и финальную расшифровку. Десять минут на одну сессию — жёсткий потолок, после которого соединение нужно открывать заново.
Из важных ограничений: в живом потоке недоступны различение говорящих и пофразовые метки времени — они работают только над готовым файлом. Зато умная диктовка, определение языка и словарь терминов сохраняются.
Такой формат нужен тем сценариям, где отклик измеряется долями секунды: диктовка текста в форме, голосовой агент, который отвечает мгновенно, подписи в реальном времени. Google упоминает, что на этом варианте уже работают платформы разработчиков: Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel, Vision Agents — каждая берёт на себя инфраструктуру передачи медиа, а разработчик концентрируется на логике приложения.
Как выглядит запрос: минимальный код
Минимальный сценарий — один вызов с аудио-файлом. Пример ниже иллюстрирует общий порядок действий: получить ключ в Google AI Studio, установить SDK, отправить запрос вместе с аудио-файлом. Официальное руководство по транскрипции аудио и транскрипции в реальном времени лежит в документации Gemini API — ссылки в конце статьи.
# 1. Получить ключ в Google AI Studio
# 2. Установить SDK
pip install -U google-genai

# 3. Передать ключ в переменной окружения
export GEMINI_API_KEY="..."
from google import genai
client = genai.Client() # читает GEMINI_API_KEY
with open("meeting.mp3", "rb") as f:
audio_bytes = f.read()
response = client.models.transcribe(
model="gemini-3.5-transcribe",
audio=audio_bytes,
config={
"speaker_diarization": True, # различение говорящих
"word_timestamps": True, # метки времени на каждое слово
"custom_vocabulary": [
"Воробьёв", "CRM", "KPI-отчёт"
], # до 1000 терминов
},
)
print(response.text)
print(response.utterances) # реплики с говорящими и метками времениДля потокового варианта порядок другой: соединение открывается через WebSocket со специальным URI для model gemini-3.5-transcribe-live, звук отправляется фрагментами, текст возвращается в ответных событиях. Полный протокол — в руководстве по live-транскрипции.
Совет: собственный словарь начинайте с 20–50 терминов, которые реально встречаются в записях: имя компании, названия продуктов, фамилии собеседников. Расширяйте по мере обнаружения ошибок. «Больше» здесь не значит «лучше» — сверх 100 терминов эффект ослабевает.
Почему это меняет архитектуру голосовых сценариев
Ценность модели — не в самой способности переводить голос в текст. Таких моделей много. Ценность в том, что распознавание разделяет контекст с агентом, который с текстом работает дальше.
Типичная цепочка в приложении технической поддержки: запись звонка → Gemini 3.5 Transcribe → текст с разметкой говорящих и метками времени → агент → поиск по заказу в CRM → задача менеджеру. В этой цепочке не участвует внешний сервис распознавания — модель и агент внутри одного API, а это один счёт за токены, один протокол передачи данных, один договор о конфиденциальности вместо двух.
Второй сценарий — операционная диктовка. Модель уже работает в пользовательских продуктах Google: функция Rambler на Android превращает голосовые заметки в чистый текст без междометий, приложение Gemini на macOS распознаёт команды и обрабатывает запросы с учётом экранного контекста Антигравити. Совместно эти возможности показывают направление: пользователь говорит, система превращает сказанное в структурированные действия.
В Google AI Studio модель доступна в режиме Build — это значит, что прототип голосового интерфейса можно собрать голосовыми командами. Chrome тоже получит диктовку в любых текстовых полях — Google заявил о запуске в будущем.
Для корпоративного использования та же модель проходит через Gemini Enterprise Agent Platform, а в отдельной продукте Gemini Enterprise for Customer Experience она обещана позже.
Где модель упрётся в стену
На бумаге функций много. На практике их нужно накладывать на конкретные ограничения.
- Потолок по длительности. Файловый вариант принимает до одного часа аудио на один запрос, но с включённым различением говорящих или метками времени — только до тридцати минут. Запись двухчасовой встречи требует нарезки.
- Различение говорящих ограничено восьмью собеседниками; для трёх и более имён присвоение выходит в статус экспериментального. Строгая атрибуция показан на стабильных группах до двух голосов.
- Кэширование контекста, выполнение кода, поиск по файлам, вызов функций, генерация изображений — всё это в таблице возможностей модели помечено как не поддерживается. Модель делает одну работу: преобразует голос в текст. Остальное — в соседних вызовах.
- Пакетный API, гибкий вывод, приоритетный вывод — тоже не поддерживаются. Тот, кто привык экономить на массовых задачах через Batch API, здесь этой опции не получит.
- Метки времени на уровне слов немного снижают точность расшифровки — это указано в документации. Если приоритет — максимальная точность, функцию стоит отключить.
Внимание: 4,0% WER — это среднее по бенчмарку, не гарантия для конкретного канала связи. Плохой микрофон, шумный фон, региональный акцент могут дать худший результат. Проверяйте модель на записи из реального процесса, а не на синтетических демонстрациях.
Кому подходит и как проверить на своём процессе
Модель имеет смысл тестировать в трёх ситуациях.
Первая: у вас уже есть запись — звонки клиентам, встречи или интервью — и вы хотите получать атрибутированный текст с метками времени без отдельного сервиса распознавания.
Вторая: вы строите голосовой интерфейс, диктовку в формах, голосового агента и вам нужен живой поток с мгновенным откликом и подстройкой под терминологию.
Третья: вы уже внутри экосистемы Gemini API и хотите убрать из архитектуры отдельный поставщик распознавания речи. В этом случае экономический эффект складывается из простоты интеграции, а не только из цены за минуту.
Кому с моделью лучше подождать: тем, кому нужна строгая атрибуция больше восьми голосов, кому критично кэширование контекста или работа с записями свыше часа без нарезки.
Проверяйте на реальных записях. Возьмите двадцать-тридцать фрагментов из своего процесса — звонок с мобильного, голосовое сообщение, шумное совещание. Прогоните через модель и через текущую систему распознавания. Для каждой пары сравните три метрики: долю неправильно распознанных слов, скорость от звука до текста и цену за час записи. Если ошибок заметно меньше, а стоимость укладывается в бюджет — модель имеет смысл внедрять.
Распознавание стало частью агента
Gemini 3.5 Transcribe отвечает на вопрос, который до сих пор разработчики решали выбором стороннего сервиса: что делать с голосом на входе. Теперь это один вызов рядом с тем вызовом, который уже строит логику агента. Это меняет не скорость, а архитектуру — из цепочки удаляется промежуточное звено.
Начинать — с малого: один повторяющийся сценарий, одна запись, один словарь терминов. Затем смотрите на измеримый эффект меньше ручных исправлений, быстрее отклик, короче договорная база. Если все три пункта улучшаются — это рабочий признак того, что слой распознавания можно выводить из отдельного стека.
Ссылки
Ссылки
- Статья: Intelligent transcription with Gemini 3.5 Transcribe — Google
- Документация: Gemini 3.5 Transcribe — Google AI for Developers
- Документация: Транскрипция в реальном времени — Live API
- Документация: Model card — Gemini 3.5 Audio