 Vorobeoff
Mistral выпустила модель с триллионом параметров, которую можно запустить на своём железе. Звучит как маркетинг — пока не посмотришь на детали: активны лишь 49 миллиардов, контекст тянется на миллион токенов, а квантование доводят до четырёх бит.
Вокруг открытых моделей давно спор: облако удобно, но данные уходят наружу, а счета растут. Le Chonk предлагает другой разговор — большой вес дома, с рассуждением, кодом и зрением из коробки. Вопрос в том, сколько этого реально пригодится за пределами демо.
Почему эта модель появилась именно сейчас
Mistral уже пробовала гонку размеров, но предыдущие Large оставались закрытыми или полуоткрытыми. Сейчас компания отдала Large 4 под лицензией Mistral Ecosystem Open-Weight — коммерческое использование разрешено, вес доступен на Hugging Face, а API идёт параллельно для тех, кто не хочет возиться с железом.
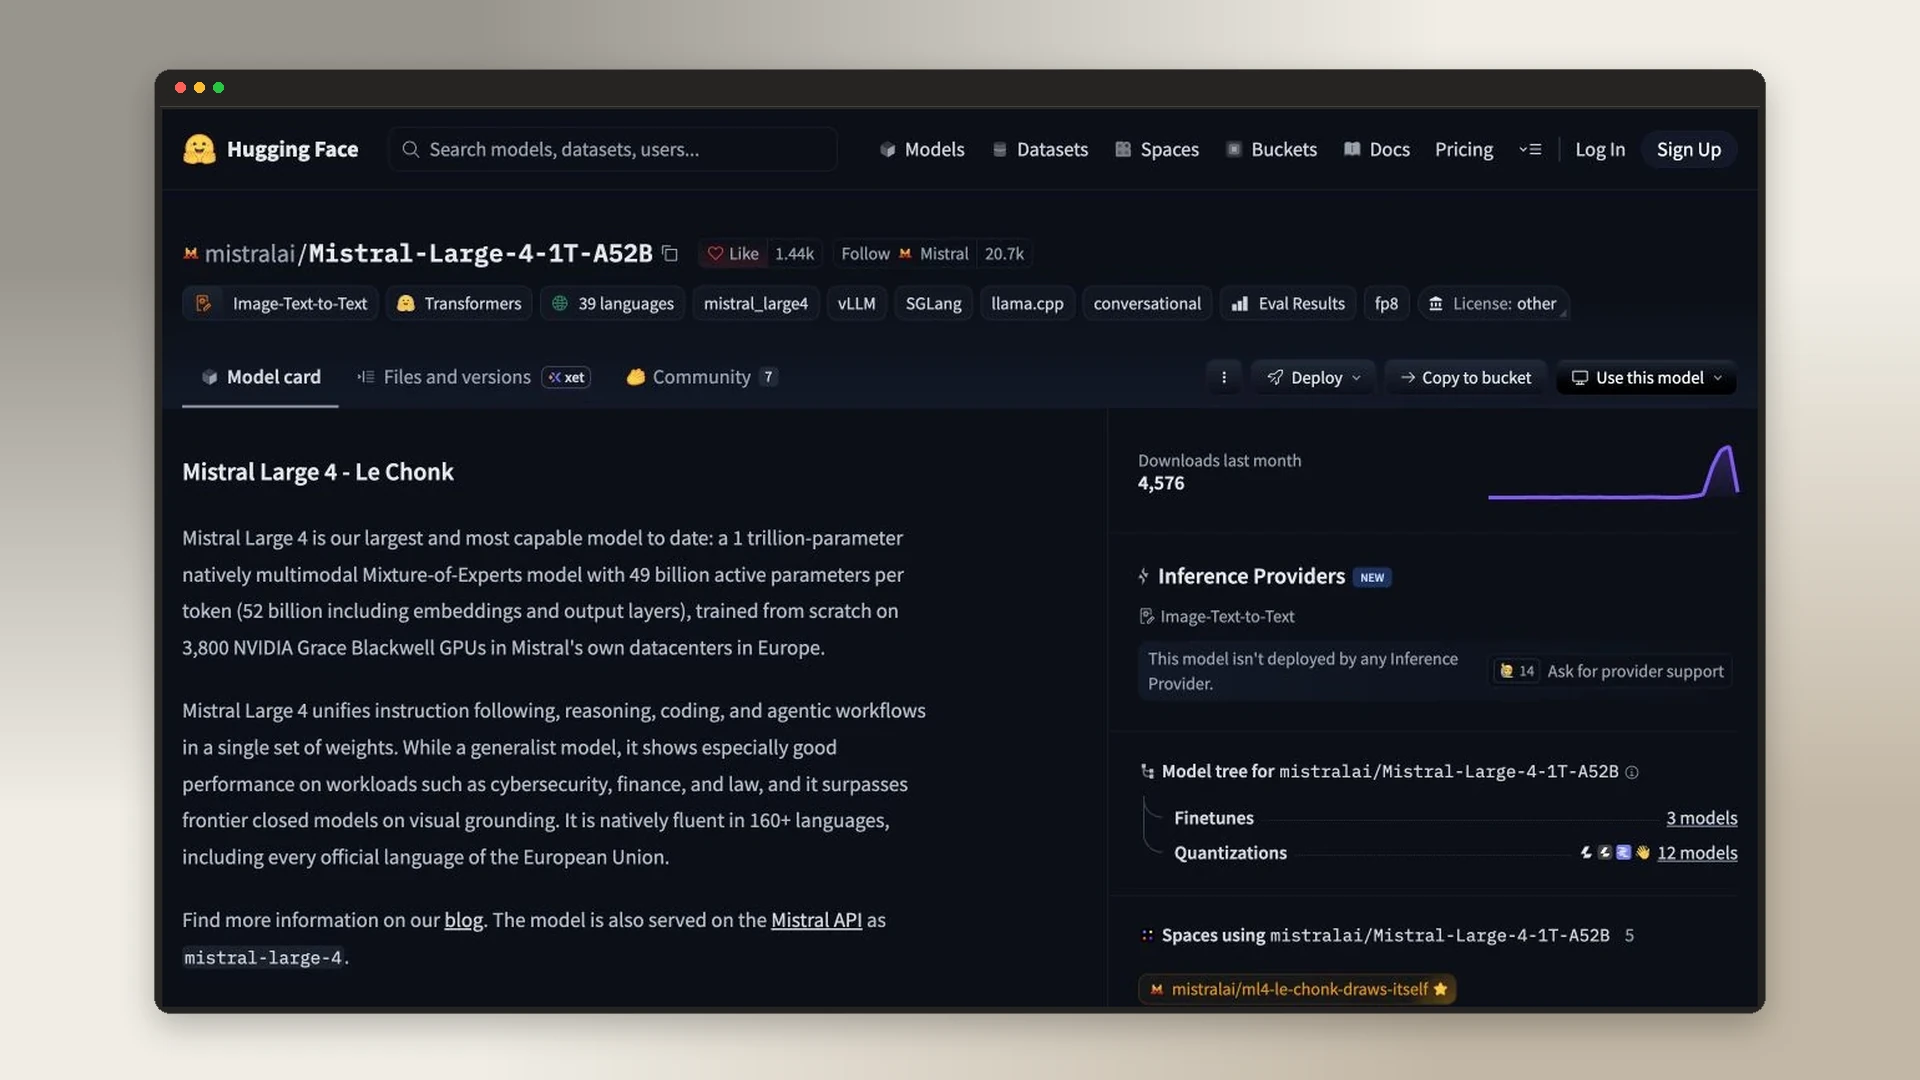
Релиз отражает общий сдвиг: разработчики хотят модели, которые держат длинный проект, пишут код пачками и не теряют контекст на середине рефакторинга. Отсюда ставка Mistral — не просто больше параметров, а архитектура, которая тянет длинные входы без квадратичного взрыва памяти.
Официальный анонс вышел на сайте Mistral, детали архитектуры и запусков — в блоге Hugging Face. Именно эти два источника задают фактическую рамку, остальное пока интерпретации.
Как устроен триллион: MoE, MLA и зрение в одном корпусе
Large 4 — это смесь экспертов (MoE) на 72 слоях. Общий объём — около триллиона параметров, но на каждом токене работают лишь 49 миллиардов. Такой подход экономит вычисления: модель хранит много знаний, а тратит ресурсы точечно.
За длинные контексты отвечает связка MLA и DSA — сжатое латентное внимание и разреженное внимание с линейной сложностью. На практике это даёт окно до миллиона токенов: можно скормить большой репозиторий или стопку документов и не резать их на куски.
Зрение закрывает Pixtral 1.6B — отдельный энкодер, который подаёт картинки в общий трансформер. Модель принимает текст и изображения одновременно, что нужно для разбора скриншотов, схем и интерфейсов.
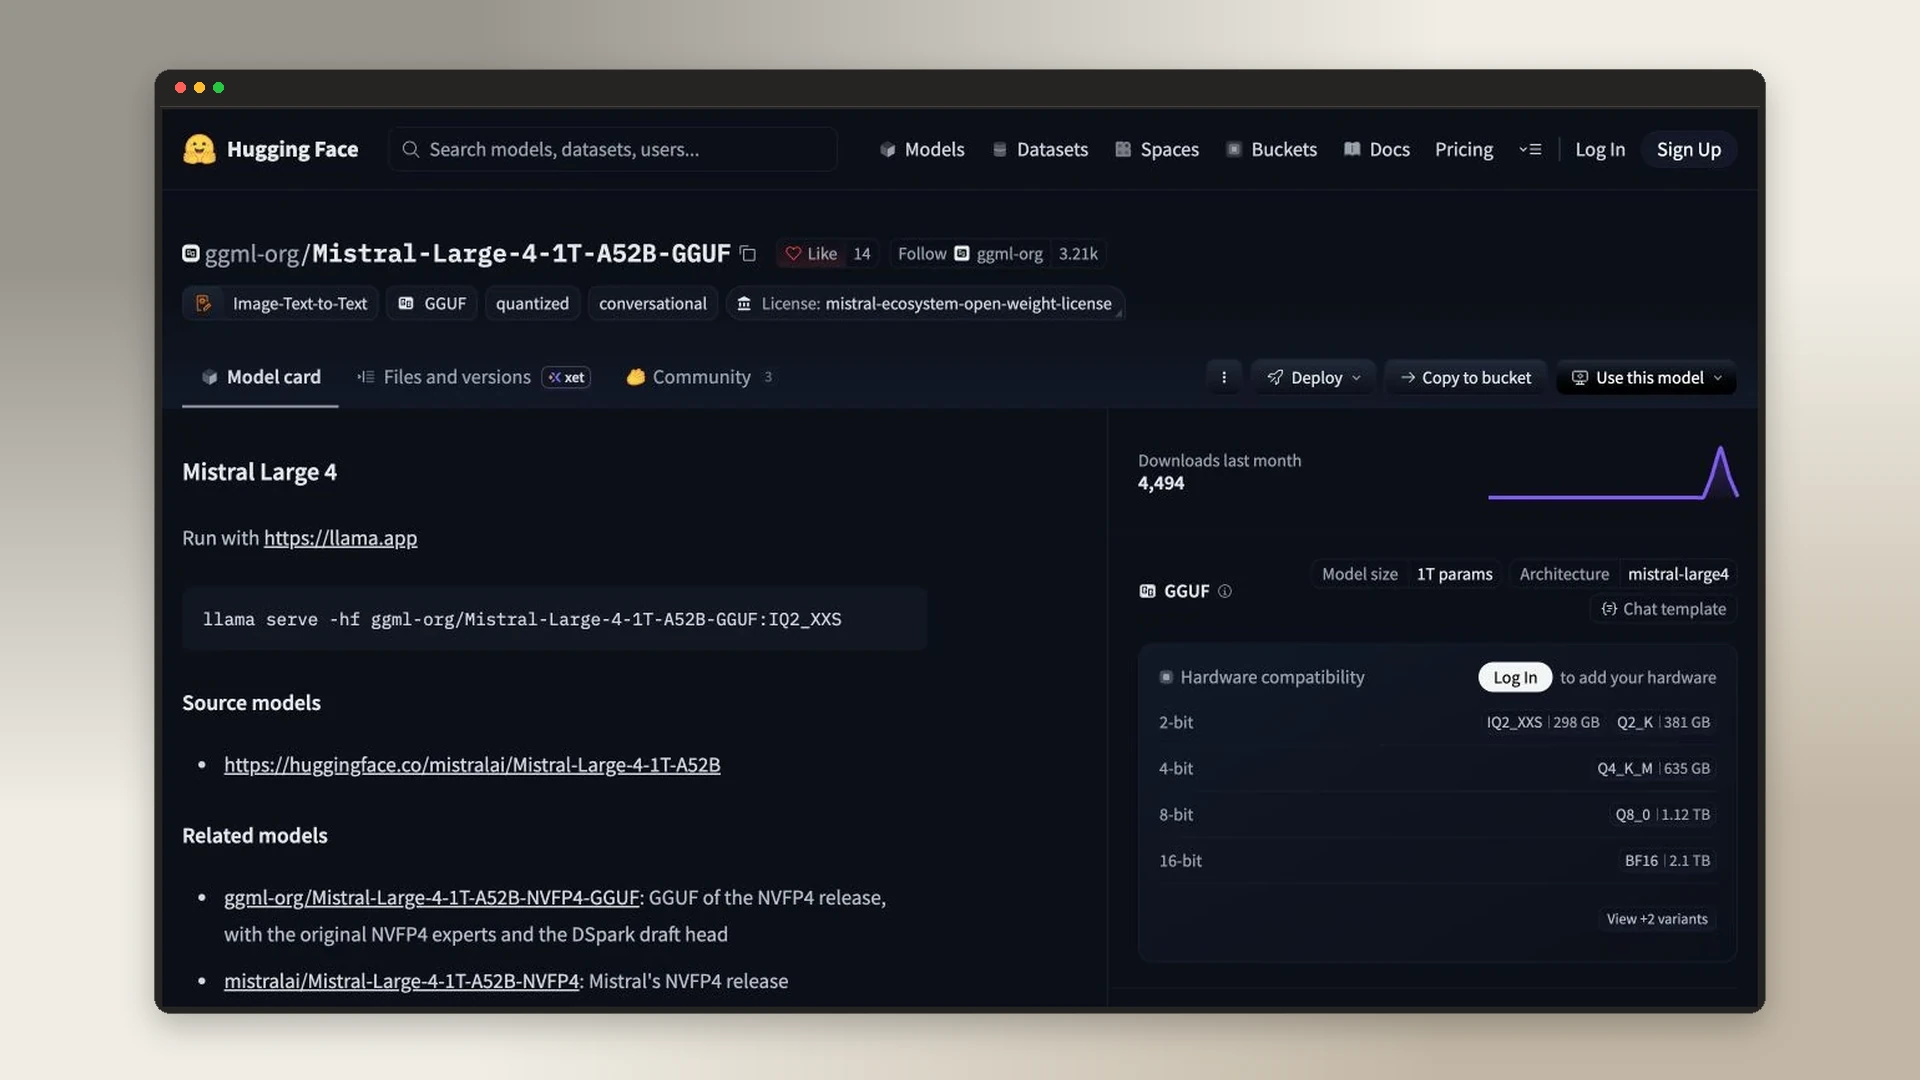
Для запуска доступны квантованные варианты — FP8, NVFP4 и GGUF. Именно они делают домашний сценарий реальным: триллион в полном весе требует кластер, а четырёхбитная сборка влезает в куда более скромную конфигурацию. Я бы проверял продукт именно на этих сборках, а не на эталонном облаке.
Три режима рассуждения
Mistral добавила переключатель reasoning: Low, Medium и High. В низком режиме модель отвечает быстро и экономит токены, в высоком — разворачивает цепочку рассуждений для сложных задач. Это не отдельный продукт, а настройка глубины мышления внутри одного запроса.
Такая градация полезна, когда часть запросов — рутина, а часть — отладка или планирование. Платить токенами за каждый чих не хочется, и селективный reasoning выглядит честной попыткой это учесть.
Где Le Chonk показывает характер: код, терминал и безопасность
Бенчмарки стоит читать как ориентиры, а не как приговор. Но цифры у Large 4 примечательные именно экономией.
- FrontierCode — 19,7%: задачи, где нужно спроектировать систему, а не дописать функцию.
- Coding Agent — 48% при −47% токенов относительно GLM-5.3. Модель решает почти половину сценариев агента и тратит вдвое меньше контекста.
- Terminal-Bench 2.0 — 41% при −30% токенов. Тест проверяет работу в настоящем терминале: команды, файлы, ошибки.
- Cyber-безопасность — 51% на Cybench, 82% и 93% на его подзадачах: поиск уязвимостей и эксплуатация в песочнице.
Что это значит на практике: модель не просто отвечает на вопросы о коде, а действует как агент — планирует шаги, вызывает инструменты, правит файлы. Если вы строите ИИ-агентов для разработки, такая экономия токенов напрямую бьёт по счету и по скорости итераций.
По API картина простая: $0,70 за миллион входных токенов, $0,07 при кэшировании и $2,10 за выход. Для длинных репозиториев кэш решает — повторные прогоны по одному проекту дешевеют в разы.
Что потребуется для внедрения
Сценарий внедрения выглядит так: команда грузит репозиторий и документацию в контекст, ставит задачу агенту и оставляет человека на ревью. Вход — код и требования, делает ИИ — план и патчи, остаётся человеку — проверка и мерж. Измерить эффект можно по доле принятых патчей и времени от задачи до мержа.
Ошибки чаще всего в двух местах: модель переоценивает свои правки и пропускает краевые случаи, а доступы к репозиторию настраивают слишком широко. Лечится это узкими правами и обязательным прогоном тестов до принятия изменений.
Что Le Chonk пока не решает и где стоит быть осторожным
Открытый вес — не бесплатный обед. Квантование режет качество, а длинные контексты требуют памяти и аккуратной отладки. Миллион токенов звучит заманчиво, но удерживать внимание на всём миллионе одинаково хорошо пока не умеет ни одна модель — деградация на хвосте остаётся риском.
Лицензия Ecosystem Open-Weight разрешает коммерцию, но с условиями атрибуции и ограничениями на использование бренда. Перед продом стоит прочитать текст лицензии, а не полагаться на пересказ.
Безопасность — двойной меч: высокие баллы на кибер-бенчмарках означают и пользу для защиты, и риск злоупотреблений. Если даёте модели доступ к боевым системам, изолируйте среду и логируйте каждый вызов инструмента.
Наконец, бенчмарки — это заявления и тесты в контролируемых условиях. Независимых сравнений на ваших данных пока нет. Я бы не переносил на эту модель критический контур без прогона на собственном наборе задач.
Тем, кто выстраивает локальную инфраструктуру под LLM, стоит заранее посчитать стоимость хранения веса, инференса и поддержки — облачный API может оказаться дешевле на старте, даже если цель — свой хост.
Кому пробовать Large 4 и как проверить за неделю
Модель подходит командам, которым нужен длинный контекст и агент для кода внутри своего периметра: финтех, медицина, внутренние платформы, где данные нельзя выносить. Не подходит тем, кто ждёт готового чата из коробки без настройки окружения.
Небольшой тест на неделю: возьмите один повторяющийся процесс — например разбор входящих багов и генерацию патчей. Дайте агенту на Large 4 доступ к репозиторию в песочнице, замерьте долю успешных исправлений и расход токенов в сравнении с текущим решением. Если экономия токенов подтверждается и качество не падает, есть смысл масштабировать.
Начинать лучше с API и кэшированного режима — проверить гипотезу дешево, а уже потом решать про GGUF на своём железе. Детальный план такого эксперимента я бы сверял с подходом к кодинг-агентам — там важны те же метрики полноты и цены ошибки.
Большой вес дома — не про размер, а про контроль
Le Chonk интересен не тем, что в нём триллион, а тем, что активная часть остаётся подъёмной. Mistral сделала ставку на управляемую мощность: много памяти, умеренный расход, рассуждение по требованию. Это попытка вернуть контроль над данными и стоимостью тем, кто устал считать токены в чужом облаке.
Инструмент пока не заменяет зрелую платформу разработки, но заметно сокращает путь от идеи до рабочего агента. Поэтому начинать стоит не с переноса всего контура, а с одного сценария, где результат можно проверить за неделю. Если у вас есть процесс, где команда каждый день переносит контекст между IDE, трекером и ревью, опишите его в нескольких предложениях — помогу определить, где агент на Large 4 действительно снимет ручную работу, а где добавит сложности.
Ссылки
- Статья: Mistral Large 4 — анонс на mistral.ai
- Статья: Mistral Large 4 на Hugging Face