 Vorobeoff
Семейство GPT-6 объединяет три модели OpenAI с разным балансом качества, скорости и цены. Здесь разберём, какую модель и уровень рассуждений выбирать под задачу, как настроить промпты и навыки, снизить затраты на длинных сценариях и удержать многочасовую работу в рамках цели.
Что это
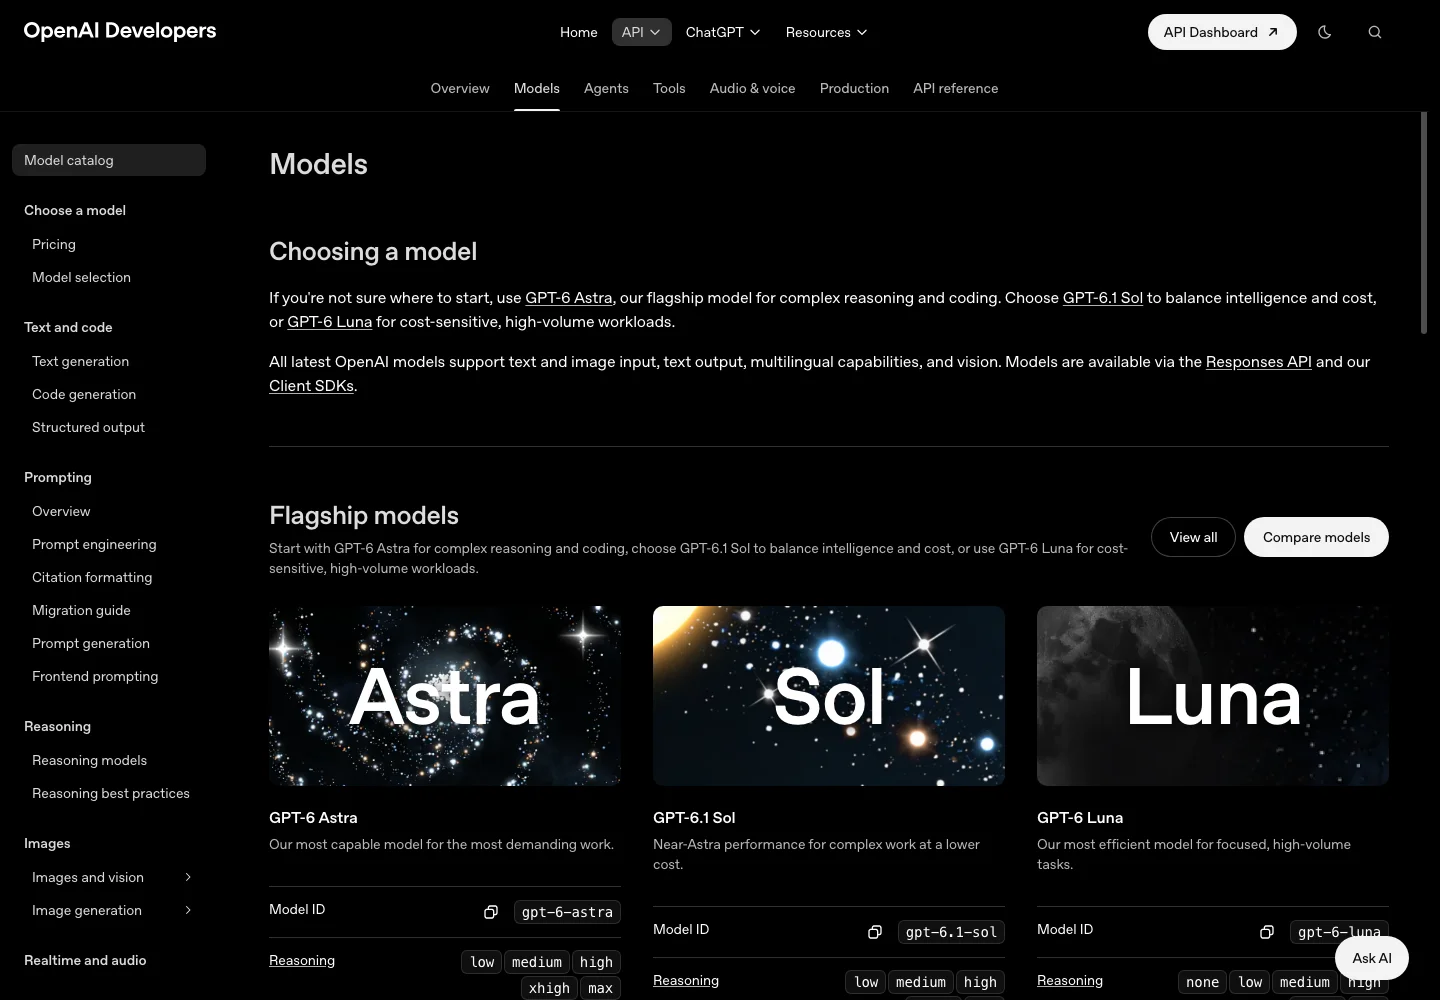
GPT-6 — самое передовое семейство моделей OpenAI. В него входят три модели с разным назначением: GPT-6 Astra рассчитана на самые сложные задачи, GPT-6.1 Sol даёт на сложных задачах результаты, близкие к Astra, при заметно меньшей цене, а GPT-6 Luna подходит для узких и массовых задач с чёткой целью.
Цены различаются в разы. При стандартной обработке и запросах до 272 тысяч входных токенов Astra стоит $10 за миллион входных токенов и $50 за миллион выходных, GPT-6.1 Sol — $2 и $10, Luna — $0,10 и $0,50. Кэшированный ввод стоит $1, $0,10 и $0,01 соответственно. Для более длинного контекста действуют повышенные ставки, поэтому эти цифры нельзя механически переносить на любой запрос.
Выбор модели — только часть работы. Дальше нужно настроить сам процесс: эффективность в продакшене, промпты и навыки, управление длительными задачами. Именно эти три направления OpenAI разбирает в своём практическом руководстве по семейству GPT-6.
Ключевое правило: модель подбирают под задачу, а не наоборот. Самую умную модель есть смысл включать только там, где её уровень действительно окупается.
Зачем нужно
Настроенная работа с семейством GPT-6 решает несколько задач разом:
- Выбрать модель и уровень рассуждений — найти баланс интеллекта, цены и скорости вместо того, чтобы всегда брать самую мощную модель.
- Снизить затраты — кэшированный ввод может стоить до 95% дешевле обычного, в зависимости от модели, а сжатие контекста уменьшает его объём в длинных диалогах, сохраняя состояние, нужное для продолжения.
- Перестроить промпты и навыки — чётко описать нужный результат, границы самостоятельности и критерий завершения вместо жёстких рецептов.
- Довести длительные задачи до конца — корректировка хода, асинхронные инструменты, делегирование и уточнения не дают многочасовой задаче отклониться от цели.
- Подготовиться к эксплуатации — мониторинг, контроль данных и замер успешности до развёртывания.
Как устроено
В основе семейства — три модели с разным позиционированием:
| Модель | Позиционирование | Вход / выход, $ за 1 млн токенов |
|---|---|---|
GPT-6 Astra | Сложнейшие задачи на рассуждения, максимальный интеллект | 10 / 50 |
GPT-6.1 Sol | Сложное программирование, исследования, управление компьютером; почти уровень Astra, в пять раз дешевле | 2 / 10 |
GPT-6 Luna | Узкие задачи в больших объёмах: извлечение полей счетов, классификация, структурированные сводки | 0,10 / 0,50 |
Уровень рассуждений и скорость
Помимо выбора модели, важен уровень рассуждений — сколько дополнительной работы модель тратит на задачу. В API используются уровни Low, Medium, High, Extra high и Max там, где модель их поддерживает; у Luna есть ещё None. Low подходит для извлечения фактов и небольших правок, Medium — для задач с оценкой и выбором, High — для сложной отладки и анализа. Extra high и Max стоит пробовать, когда High не хватает и прирост качества оправдывает дополнительные затраты времени и денег. Уровень можно менять по ходу диалога, не ломая кэш промпта.
Скорость — второй рычаг. В API есть Fast mode для сценариев, где важен быстрый и стабильный отклик, например в чатах или инструментах для разработки. Он стоит дороже стандартной обработки. Для GPT-6 Astra в API и Codex доступен ещё Ultrafast: он ускоряет генерацию токенов независимо от уровня рассуждений и подходит для случаев, где задержка действительно критична.
Продакшен: эффективность, кэширование, контроль
Первый блок — подготовка к продакшену. До развёртывания из входящего контекста вычищают всё, что для задачи лишнее, оставляя только нужное, а независимые операции запускают параллельно: одна медленная операция не должна блокировать остальные.
Ключевой приём экономии — кэширование промптов. Кэшированные входные токены могут стоить до 95% дешевле обычных, в зависимости от модели. Для этого постоянные инструкции и справочные материалы размещают перед меняющимися деталями задачи, а определения инструментов сохраняют неизменными. Понять, где повторное использование не сработало, помогают дашборд кэширования и руководство по диагностике. В долгих диалогах сжатие уменьшает объём контекста, сохраняя состояние, необходимое для продолжения.
До развёртывания решают, как отслеживать поведение модели, и изучают средства контроля данных для своего приложения. Затем тестируют: прогоняют типичные задачи и смотрят, насколько они успешны, какова задержка и во сколько обходится одна решённая задача.
Промпты и навыки: от рецептов к границам
Второй блок — перестройка промптов и навыков. Начинают с точного описания задачи: что должно получиться, кому это адресовано, какой контекст важен, какие есть ограничения и по каким признакам считать работу законченной. Дальше — четыре направления.
Первое — навести порядок в навыках: коротко обозначить, когда каждый из них включать, подгружать справочные данные только по необходимости и вместо жёстких предписаний оставлять рекомендации, откалиброванные под модели команды. Второе — переписать AGENTS.md: прописать, в каких случаях нужны те или иные документы и тесты, и прямо разрешить безопасные рутинные шаги, скажем локальный прогон тестов на одноразовых данных без доступа к продакшену.
Третье — очертить границы самостоятельности: что модель делает без вас, а что только после согласования, и вместо общей установки «спрашивать всегда» прописать конкретные границы. Четвёртое — зафиксировать, что считается готовым результатом: изменение внесено, нужные проверки запущены, результат просмотрен, найденные сбои устранены. Отдельно перечисляют решения, которые остаются за человеком.
Отдельно договариваются о нужном результате: что модель решает сама, в каких точках запрашивает ваши указания и как выглядит полезный ответ. Скажем, структуру сводки она выбирает сама, но менять объём проекта обязана согласовывать. А полезный ответ описывают явно: понятный язык, технические детали под уровень аудитории и короткое резюме — что изменено, что проверено, на что ещё обратить внимание.
OpenAI отдельно обращает внимание: модели стали лучше понимать нюансы и неоднозначность, поэтому чрезмерно конкретные инструкции иногда мешают там, где раньше помогали. Это повод пересмотреть накопившиеся «страховочные» правила и оставить только те, которые действительно нужны.
Длительные задачи: не дать работе отклониться от цели
Третий блок — управление задачами, которые занимают часы или дни. В API для этого три инструмента. Корректировка в ходе ответа позволяет отправить уточнение через Responses WebSocket API, пока модель работает: уточнения ставятся в очередь и не отменяют ни запущенные инструменты, ни уже выполненные действия. Асинхронный вызов инструментов позволяет модели выполнять независимую работу, пока приложение занято медленной задачей, например тестами, и получать результат по готовности. Делегирование открывает GPT-6.1 Sol многоагентные сценарии: модель раздаёт независимые куски работы субагентам — к примеру, изучение разных участков кодовой базы — и сводит их выводы в один ответ. Многоагентный режим сейчас в бета-версии.
В Codex механизм другой: там при длительных задачах нужны решения, которых не было в исходном промпте. С GPT-6 Astra Codex может запрашивать уточнения по ходу задачи. Стоит разрешать вопросы, влияющие на следующий шаг, и указывать, какую независимую работу можно продолжать, пока вы решаете. Если вы будете недоступны, сообщите Codex, что можно продолжать и когда остановиться. Если требования поменялись, задачу поправляют на ходу, поясняя, что именно меняется, а что остаётся как было.
Управление компьютером
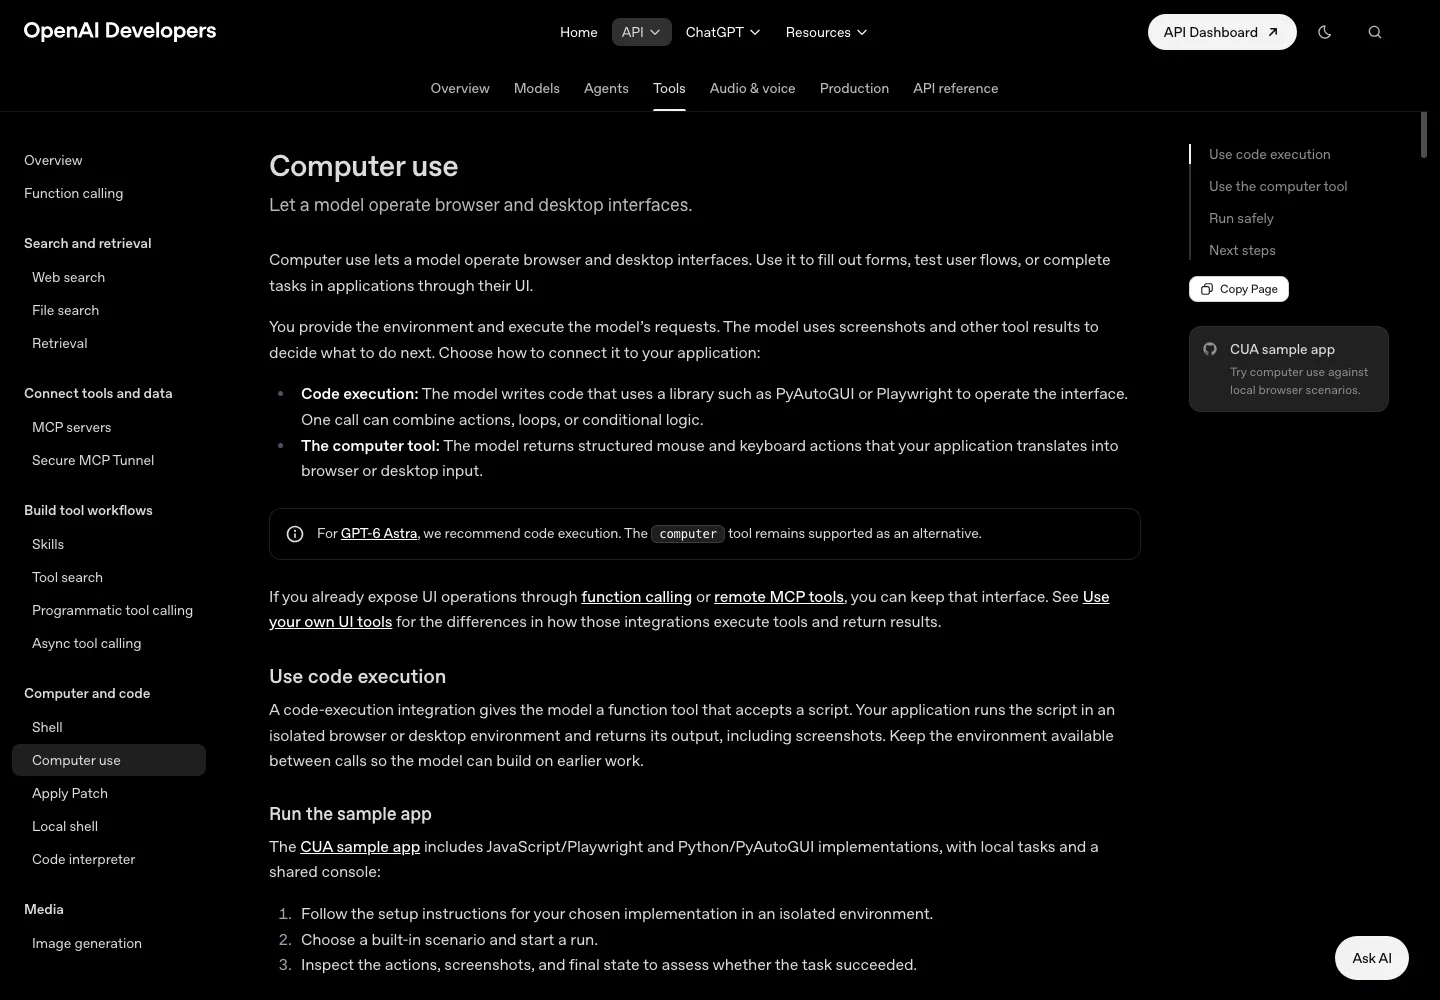
Управление компьютером позволяет Astra, Sol и Luna работать с сайтами и настольными программами через предоставленный инструмент, даже если у приложения нет API. Модель можно попросить, например, разобраться в ошибке, исправить код и открыть продукт в браузере, чтобы проверить результат. Для каждого шага лучше выбирать самый простой и надёжный путь: API или готовый инструмент, если они решают задачу напрямую; управление компьютером — когда нужно прочитать экран, нажать кнопку или заполнить форму. При встраивании в своё приложение среду выполнения предоставляет разработчик: Playwright подходит для браузера, PyAutoGUI — для настольных программ.
Когда использовать
Выбор модели и уровня рассуждений — это поиск баланса интеллекта и цены под конкретную задачу:
| Ситуация | Выбор | Почему |
|---|---|---|
Нужен максимум качества на сложных рассуждениях | GPT-6 Astra | Самый высокий интеллект семейства |
Сложный код, исследования или управление компьютером при ограниченном бюджете | GPT-6.1 Sol | Почти уровень Astra, в пять раз дешевле |
Большой поток узких однотипных задач — счета, классификация, сводки | GPT-6 Luna | Быстро и дёшево, разница в цене огромна |
Долгая многоэтапная работа, которая не должна останавливаться | Sol + делегирование, Codex + корректировка хода | Задача идёт независимо и не уходит в сторону |
Нужно работать с сайтом или приложением без API | Управление компьютером (Astra, Sol, Luna) | Модель читает экран, нажимает кнопки, заполняет формы |
Уровень рассуждений подбирают по сложности: Low — для рутины, Medium — для задач с оценкой и выбором, High — для сложной отладки и анализа. Режимы Extra high и Max стоит пробовать, только если High не даёт нужного качества и выигрыш оправдывает дополнительные затраты времени и денег.
Пример
Разберём два крайних сценария. Компания каждый день обрабатывает тысячи входящих счетов и извлекает из них сумму, дату и контрагента. Это узкая повторяющаяся задача с чёткой целью, и здесь подходит Luna. По стандартному тарифу она стоит $0,10 за миллион входных токенов и $0,50 за миллион выходных; кэшированный ввод — $0,01.
Другая задача — понять, почему продакшен падает в редких случаях, и исправить это. Нужна сложная отладка: гипотезы, анализ кода, проверка исправления. Такую работу берёт Astra с высоким уровнем рассуждений. После исправления можно попросить модель открыть продукт в браузере через управление компьютером и убедиться, что всё работает. Если отладка идёт в Codex и занимает часы, заранее разрешают модели задавать уточняющие вопросы и указывают, какую независимую работу продолжать, пока вы решаете.
Семейство уже используется в рабочих продуктах. Harvey сочетает сведения о судах, судебную практику, внутренние документы фирмы и предпочтения конкретного юриста, чтобы адаптировать черновики под его работу.
Cognition использует GPT-6 Astra внутри Devin для тестирования ПО. В примере с игрой для iPhone Devin подготовил запись из симулятора и отчёт, где пройденные проверки отделены от непроверенных зон.
Hex превращает вопросы о работе каналов продаж в текстовые выводы и интерактивные дашборды, включая разбивку по регионам. Модель также проверяет, выглядят ли числа правдоподобно и отвечает ли анализ на исходный бизнес-вопрос.
Invideo использует Astra для планирования правок на монтажной шкале и создания редактируемых эффектов. По данным компании, успешность задач цветокоррекции и цветового оформления выросла примерно втрое, а несколько редакторов за один день создали около 50 эффектов.
Эти кейсы показывают реальные способы применения Astra, но приведённые цифры — данные самих компаний из материалов OpenAI, а не независимые бенчмарки. Их лучше воспринимать как примеры рабочих сценариев, а не как гарантию такого же результата в другом проекте.
Ограничения
Что учитывать, прежде чем строить работу на семействе GPT-6.
| Пункт | Пояснение |
|---|---|
Высокие уровни рассуждений требуют больше ресурсов | — Extra high и Max стоит включать, только если улучшение результата оправдывает дополнительные затраты времени и денег. |
Делегирование подзадач пока в бета-версии | — Многоагентный режим в Responses API, где GPT-6.1 Sol поручает независимую работу субагентам, находится в бета-версии и может меняться. |
Ultrafast доступен только для Astra — В семействе GPT-6 этот режим ускоренной генерации доступен GPT-6 Astra. | Для GPT-6.1 Sol и Luna остаются Standard и Fast mode. |
Длинный контекст меняет цену — Если запрос превышает 272 тысячи входных токенов, для GPT-6 Astra, GPT-6.1 Sol и Luna применяются повышенные ставки. | Базовые цены из таблицы выше к таким запросам не относятся. |
Кэширование срабатывает не всегда | — Повторное использование контекста нужно контролировать через дашборд кэширования и руководство по диагностике, а не считать его само собой разумеющимся. |
Антипаттерны
Чего не делать.
| Пункт | Пояснение |
|---|---|
Брать самую мощную модель на рутинную задачу — Astra может оказаться неоправданно дорогой для извлечения полей или простой классификации. | Сравните модели на своих типовых примерах и оставьте самую лёгкую конфигурацию, которая проходит ваш порог качества. |
Писать жёсткие рецепты вместо рекомендаций — Модели лучше работают с гибкими указаниями, настроенными под конкретную модель команды. | Слишком детальные правила могут сбивать их с толку. |
Держать правило «всегда спрашивай» без границ — Оно тормозит работу. | Замените его чёткими границами: какие действия модель делает сама, какие требуют вашего одобрения. |
Запускать длительную задачу и не следить за ней — Без корректировки хода работа может отклониться от цели. | Обновляйте инструкции по ходу и определите, когда модель должна обращаться к вам. |
Разворачивать в продакшен без теста | — Сначала прогоните типичные задачи и замерьте долю успеха, отклик и цену одной успешно решённой задачи. |
Чеклист
Проверка перед запуском.
| Пункт | Пояснение |
|---|---|
Модель и уровень рассуждений подобраны | — Выбранная модель соответствует сложности задачи, а уровень усилий на рассуждения выставлен под неё. |
Промпты и навыки обновлены — Задача сформулирована чётко: | результат, аудитория, контекст, ограничения и критерий завершения. |
Границы самостоятельности заданы | — Указано, что модель решает сама, а что согласует с вами; критерий «готово» описан. |
Кэширование и сжатие контекста настроены | — Постоянные инструкции и справочные материалы размещены до меняющихся деталей задачи. |
Длительные задачи управляются | — Настроена корректировка хода, делегирование независимых подзадач и точки обращения к вам. |
Тест перед развёртыванием пройден | — Типичные задачи прогнаны, успешность, задержка и стоимость измерены. |
Ссылки
- Документация: OpenAI — Models (описание семейства GPT-6)
- Документация: OpenAI — Codex
- Документация: OpenAI — Computer use