 Vorobeoff
Block показала Dessa — голосовую модель, которая училась говорить только на человеческих разговорах, без текста и без готовых языковых моделей. Она слушает и говорит одновременно, слышит эмоции и паузы и работает прямо на ноутбуке. Разбираем, что в ней нового и что это меняет для голосовых ассистентов.
Голосовые ассистенты давно умеют говорить, но разговор с ними часто раздражает. Вы говорите, ассистент ждёт пока вы закончите, превращает речь в текст, думает в тексте и только потом озвучивает ответ. Вся интонация, смех, сарказм, пауза теряются по дороге.
Block решила проверить другую идею: а что если модель вообще не будет видеть текст и научится разговору только на звуках, как ребёнок? 23 октября компания открыла страницу Dessa и выложила живые записи диалогов. Это не продукт и не чат-бот с новым голосом, а исследовательский проект про то, как учить ИИ слушать.
Что именно показала Block
Dessa — так называется и исследовательская лаборатория внутри Block, и сама модель. На официальном сайте она описана так: «the Conversation Model trained only on speech» — разговорная модель, обученная только на речи.
По заявлению Block, Dessa — первая модель, с которой можно вести реалистичный живой диалог и которая при этом обучалась исключительно на человеческой речи. Никакого текста, никаких предобученных языковых моделей. Только звуки разговоров.
Анонс поддержал основатель Block Джек Дорси: «We believe voice is the most natural way to interact with intelligence, so we created Dessa, the most authentic full-duplex speech model ever built». На сайте доступны записи живых разговоров — Block подчёркивает, что никто не подсказывал модели что говорить: Dessa сама выбирает что сказать, когда и каким голосом. Субтитры добавили уже после записи.
Лаборатория небольшая и отчитывается напрямую Дорси. Её собрали выходцы из торонтского стартапа Dessa, которые занимаются генеративными голосовыми моделями больше восьми лет. Руководит направлением Ragavan Thurairatnam.
Как устроена Dessa и чем отличается от обычных голосовых ИИ
Обычная схема голосового ИИ выглядит так: микрофон → текст → языковая модель → текст → озвучка. На каждом шаге теряется информация, которую текст не передаёт. Block называет это главной проблемой и предлагает прямой путь: аудио на вход, аудио на выход.
Голосовые ассистенты такого типа называют speech-to-speech. Dessa — как раз такая модель, причём full-duplex: она слушает и говорит одновременно, как человек в диалоге. Она может перебить, вставить «ага», «понял», вовремя замолчать или продолжить фразу.
Block отдельно объясняет, почему учить модель на звуке сложнее, чем на тексте:
- Речь никогда не повторяется одинаково. Дважды сказанная фраза даёт разные данные, тогда как текст всегда идентичен.
- Звук намного тяжелее текста. Одно spoken слово занимает в тысячи раз больше байт, чем то же слово в тексте.
- Смысл зависит не только от слов. Акцент, пауза, дыхание, интонация, темп — всё это меняет значение. На сайте приводят пример: фразу «I didn’t say she stole my CUDA code» можно произнести с ударением на разных словах и получить разный смысл.
При этом, по словам команды, Dessa выучила язык на «в сотни раз меньшем количестве слов», чем большие языковые модели. Оговорка честная: языковым моделям приходится учить ещё и код, документы и многое другое.
Технические детали с официальной страницы: обучение прошло на одной системе NVIDIA GB200 NVL72, а инференс работает быстрее реального времени и поэтому отвечает без неловкой паузы. Модель компактная — Block заявляет, что она запускается локально на MacBook Pro с чипом M4 Max и выше.
Что Dessa уже умеет на демо
Block не публикует бенчмарки и таблицы сравнений. Вместо них — записи диалогов, где слышно поведение модели:
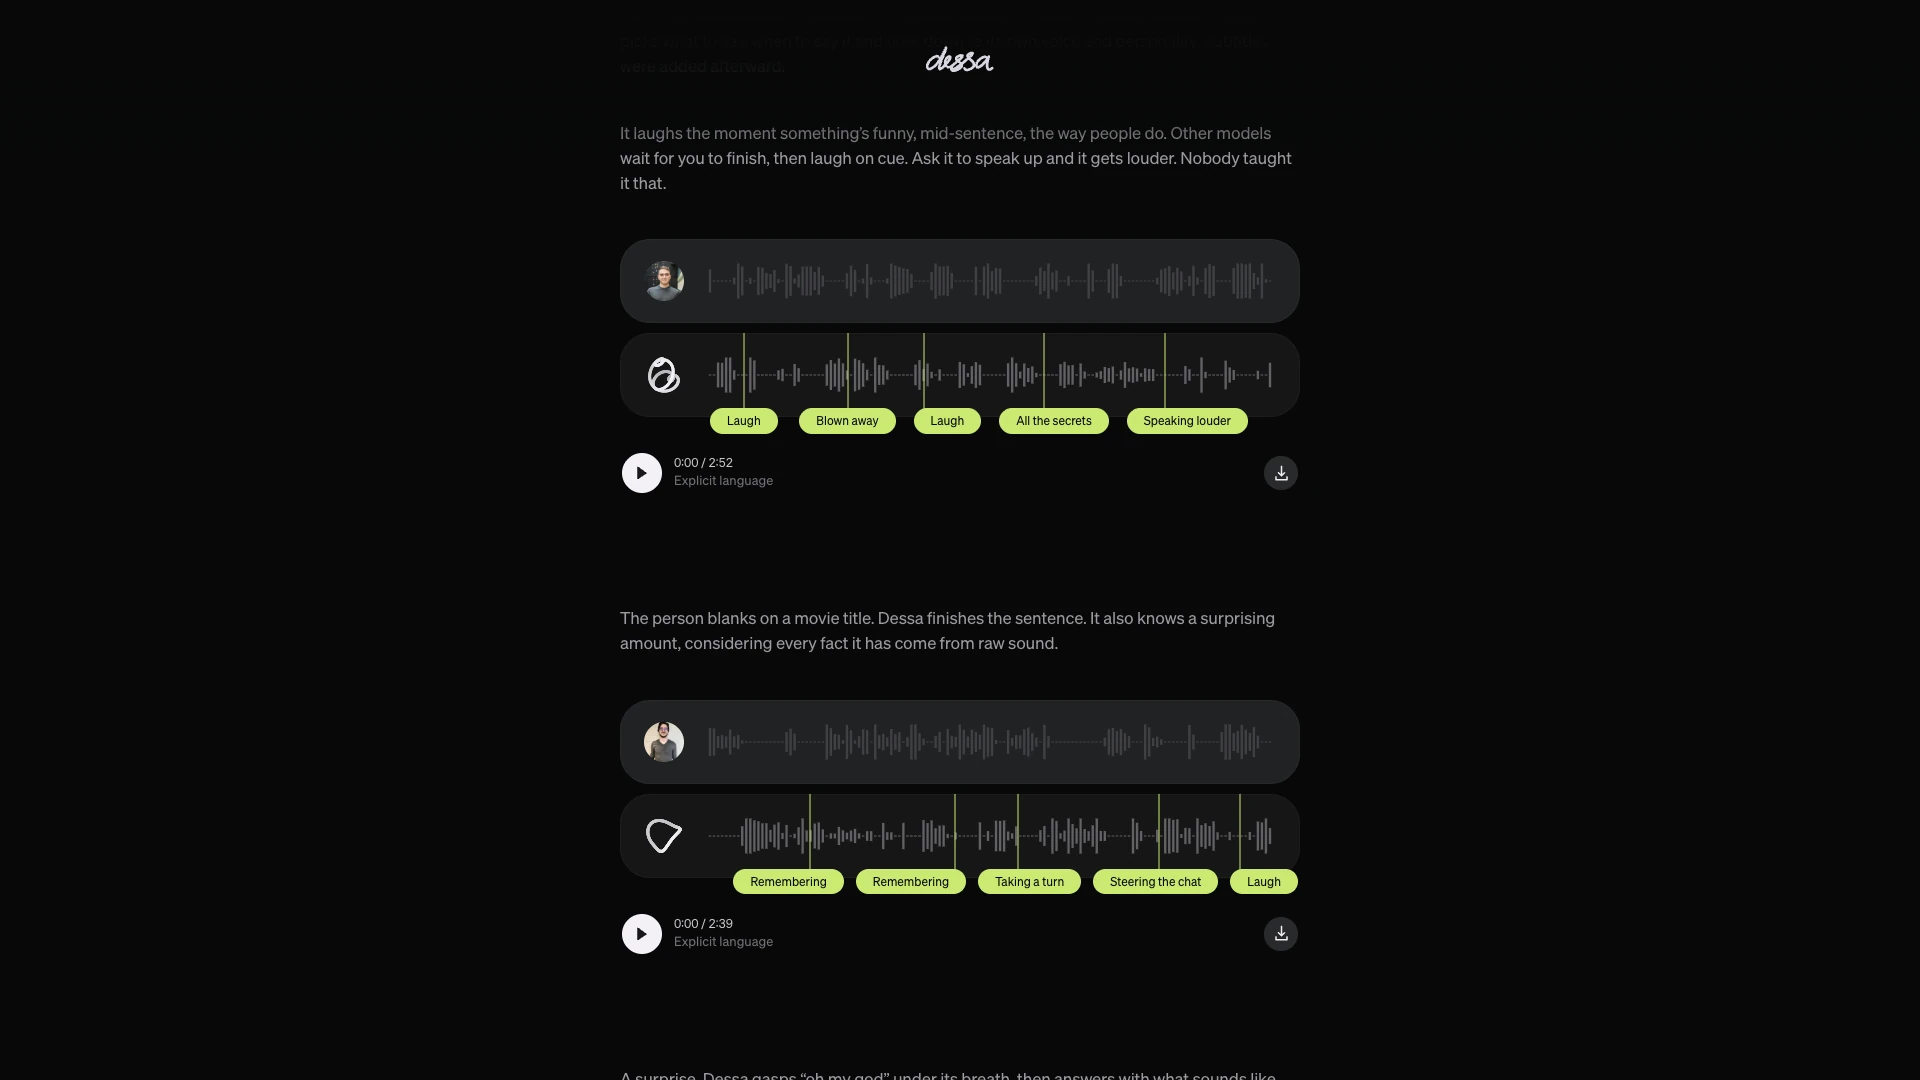
- Смеётся посреди фразы, когда слышит что-то смешное, а не ждёт конца реплики.
- Меняет громкость по просьбе «говори громче» без отдельного обучения этой команде.
- Договаривает фразу, когда собеседник забывает название фильма.
- Реагирует на сюрприз — на сайте есть эпизод, где модель ахает и отвечает с интонацией, похожей на растроганность.
- Слышит и воспроизводит сарказм, вздох разочарования, дрожащий от грусти голос, разный темп и интонацию.
На сайте есть и отдельный диалог Dessa с другой голосовой моделью GPT-Live-1. Block уточняет, что это сторонняя модель и её разработчик не связан с Block и не оценивал Dessa.
Для практики это означает более естественный темп разговора: модель не ждёт тишины, а ведёт беседу с перебиваниями и поддакиваниями, как живой собеседник. Именно этого не хватает текущим ассистентам, которые превращают голос в текст.
Где такая модель может пригодиться
Block называет три причины, зачем вообще делать модель без текста: любопытство, более естественный интерфейс и безопасность. Последний пункт важный: когда ИИ не слышит эмоции в голосе, он может не заметить, что человеку плохо, и продолжать разговор как ни в чём не бывало.
Если смотреть на бизнес-применение, потенциальные сценарии понятны:
- Поддержка и продажи по телефону, где важны темп, эмпатия и умение не перебивать в неподходящий момент.
Голосовые ИИ-агенты такого типа пригодятся для интервью, онбординга и проверки знаний — там, где интонация несёт смысл.
- Ассистенты для людей, которым проще говорить, чем писать — от водителей до операторов на производстве.
Но пока это потенциал, а не готовый инструмент. Любой такой сценарий придётся проверять на своих звонках: как модель держит тему, помнит детали из звука и не выдумывает факты, которые она тоже учила только на слух.
Что пока не готово и на что смотреть внимательно
Dessa — это research preview, а не релиз продукта. На момент публикации у неё нет публичного доступа, нет открытых весов и нет заявленной цены. На сайте есть форма ожидания для исследователей безопасности — Block прямо зовёт внешних специалистов искать риски, потому что модель, обученная только на звуке, это новая территория.
Что остаётся открытым:
- Языки и акценты. Block не раскрывает, на каких языках и на каком объёме данных училась модель.
- Факты и точность. Если все знания пришли из сырых разговоров, важно понять, как модель проверяет факты и не путает услышанное.
- Приватность и данные. Обучение на реальных разговорах всегда ставит вопрос, чьи это были разговоры и как получено согласие — деталей компания пока не публиковала.
- Сравнение с другими. Без независимых тестов нельзя сказать, насколько стабильна модель вне подготовленных демо.
И ещё одно ограничение прямо из описания: речь требует намного больше данных в байтах и сложнее в обучении. Даже если Dessa научилась языку на меньшем числе слов, ей пришлось учить гораздо больше — паузы, интонации, эмоции. Это отдельная сложность, которую команда только начала исследовать.
Как следить за темой без лишних ожиданий
Сейчас самый полезный шаг — не ждать продукт, а понять, что именно проверяет Block. На странице Dessa компания формулирует открытые вопросы: насколько эффективно такие модели учат язык и факты по сравнению с текстовыми, как быстро осваивают новые языки и какие формы обучения на примерах им доступны.
Если вы отвечаете за голосовой продукт, имеет смысл оставить заявку как safety-исследователь, если у вас есть релевантный опыт, и параллельно собрать небольшой набор своих звонков для будущего сравнения. Когда доступ появится, проверять стоит простую вещь: где естественность разговора действительно помогает довести диалог до результата, а где достаточно обычного пайплайна голос → текст → ответ.
До появления независимых обзоров и документации к любому демо стоит относиться как к демонстрации идеи, а не как к гарантии поведения в продакшене.
Итог: голосовой ИИ пробует другой путь
Dessa интересна не тем, что у неё «лучше голос», а тем, что она училась иначе. Block показала, что модель может освоить разговор, слушая людей, без опоры на текст, и при этом держать естественный темп, эмоции и перебивания.
Это пока исследование, а не инструмент для внедрения. Но если подход подтвердится на независимых тестах, он может сдвинуть голосовой ИИ от схемы «озвученный чат» к модели, которая действительно слушает. Ближайший ориентир — публикации Block по устройству Dessa и первые внешние оценки, когда компания откроет доступ шире.
Ссылки
- Сайт: Dessa — the Conversation Model trained only on speech
- Сайт: Пост Джека Дорси с анонсом Dessa
- Сайт: Пост Block с анонсом Dessa
По теме
- База знаний: Голосовые ассистенты и ИИ-агенты: в чём разница
- База знаний: ИИ-агенты: что это и зачем нужны
- Статья: Как выбрать LLM для конкретной задачи: практический гид (2026)