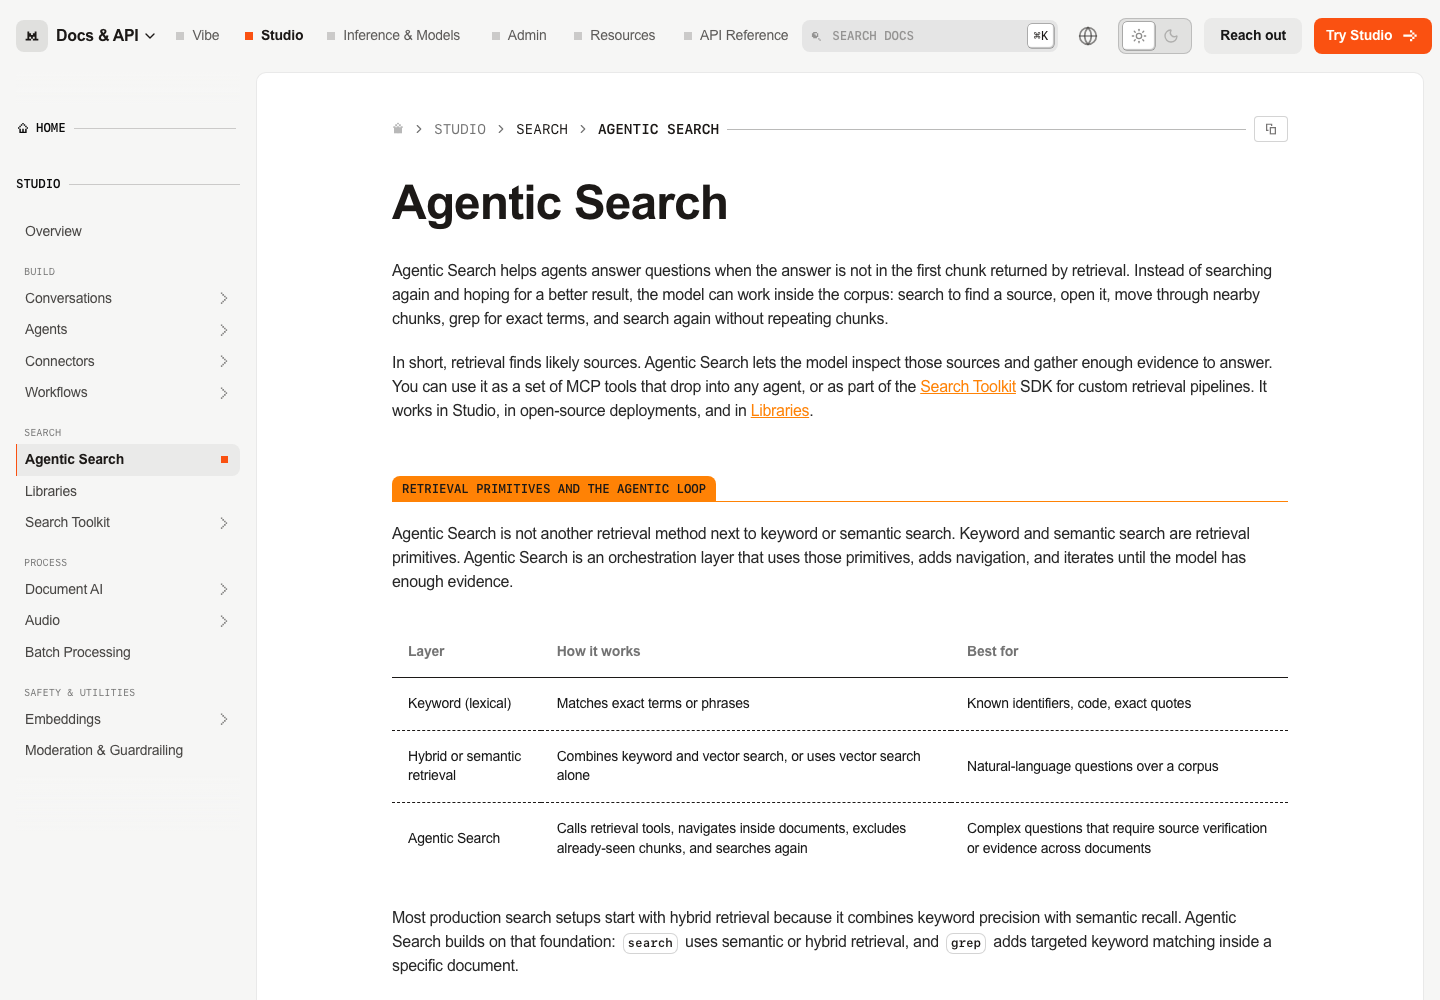
Обычный поиск по базе знаний работает так: система находит несколько отрывков текста и отдаёт их модели, чтобы та ответила за один проход. Агентный поиск идёт дальше — модель сама уточняет запрос, открывает документы, листает нужные страницы и проверяет найденное, прежде чем ответить.
В такой схеме поиск превращается в несколько шагов: найти документ, открыть его, дойти до таблицы, прочитать нужное и сверить с другими источниками. Mistral выпустила такой слой под названием Agentic Search — он доступен через Search Toolkit и встроен в Libraries в Studio и Vibe.
Важно: агентный поиск не заменяет индекс — он дополняет его. Индекс находит вероятные источники, а агент решает, что внутри них изучать и как сопоставлять.
Что это
Agentic Search — это уровень поиска, который даёт модели возможность самому ориентироваться внутри корпоративных данных: искать, открывать, читать и проверять информацию даже в самых сложных документах. Он вводит многошаговый цикл извлечения — модель не отвечает по первому набору результатов, а продолжает уточнять и исследовать источник, пока не доберётся до верного ответа.
Работает этот слой через пять инструментов, которые напоминают привычные операции с файлами:
search— находит подходящие документы по всему корпусу через готовый индекс;open— открывает конкретный документ;navigate— переходит к странице, разделу или участку внутри него;read— достаёт содержимое в указанном месте;grep— ищет совпадение по образцу внутри открытого документа.
Вместо того чтобы отвечать только по первым верхним результатам, модель может рассмотреть то, что нашла, уточнить запрос, открыть подходящие документы, дойти до нужных разделов и прочитать исходный материал перед ответом. Индекс указывает вероятные источники, а агентный поиск решает, что внутри них проверять.
Инсайт: эти инструменты не требуют дообучения модели под конкретную задачу. По мере того как модели лучше рассуждают и работают с инструментами, качество поиска растёт само по себе — без изменения инфраструктуры.
Зачем нужно
Данные, которые дают компании преимущество, живут за границами изоляции — в финансовых отчётах, договорах, внутренних регламентах и госдокументах. Это длинные и плотные документы, которые обычный поиск не может обойти эффективно. Агенты часто отделены от них из соображений безопасности.
Агентный поиск связывает рассуждения модели с инструментами извлечения, которые безопасно добираются до чувствительного материала. Зачем он нужен в таком виде:
- Работа с чувствительными данными — переносимое открытое средство не пересекает границы изоляции ни в облаке, ни на собственном сервере.
- Поиск за пределами отрывков — модель добирается до данных внутри длинных плотных документов или сразу нескольких источников.
- Использование готового индекса — новый слой строится на уже существующем поисковом индексе, его не нужно переделывать.
- Точность и скорость — меньше повторов запросов, меньше траты токенов и ниже задержка.
Как устроено
Mistral Search Toolkit даёт открытые модули для приёма, эмбеддинга и индексации данных в облаке или у себя. Agentic Search строится на этом индексе и добавляет модели пять инструментов — поиск, открытие, навигацию, чтение и grep.
| Инструмент | Что делает |
|---|---|
| search | Находит документы по корпусу через существующий индекс |
| open | Открывает конкретный документ |
| navigate | Переходит к странице, разделу или участку внутри документа |
| read | Получает содержимое в указанном месте |
| grep | Ищет совпадение по образцу внутри открытого документа |
Главное отличие от обычного одноразового RAG — возможность итерации. Классическая схема достаёт фиксированный набор отрывков и просит модель ответить в один проход. Это работает, когда ответ лежит в первых результатах, но подводит, если нужно обойти длинный отчёт, сверить несколько документов или проверить доказательства.
Обычный RAG уступает по трём причинам:
- Поиск без рассуждения — модель обязана ответить по отрывкам, отобранным на старте, даже если они неполные или нерелевантные.
- Предел уровня отрывка — индекс может найти нужный документ, но не может открыть его, дойти до таблицы, прочитать контекст и проверить ответ.
- Нет итераций — многие вопросы требуют не одного прохода: уточнить запрос, проверить документ, сравнить источники и попробовать другой путь.
Совет: ключевое свойство агентного поиска — качество извлечения растёт вместе со способностями модели, а не ограничено вашей стратегией разбиения на отрывки.
Когда использовать
Агентный поиск особенно полезен, когда ответ зависит от точного места в документе.
- Длинные документы — отчётность, договоры, руководства, техспецификации, где ответ лежит на конкретной странице или в таблице.
- Вопросы сразу из нескольких источников — задача, где нужно найти, сопоставить и свести доказательства из разных документов.
- Ответы, которые требуется проверять — финансовые цифры, правовые положения, регуляторные ссылки, операционные данные.
- Таблицы и структурированные документы — отчётность, госзаписи, сканы PDF, где смысл зависит от строк, колонок и положения на странице.
А когда обычный одноразовый поиск остаётся правильным началом:
- Прямые запросы — короткие и чистые документы, где ответ лежит в первых результатах.
- Высокочастотный поиск — ключевые или смысловые запросы, которым не нужно рассуждение и навигация.
- Простые предсказуемые вопросы — когда источник и место ответа заранее известны и дополнительные шаги вряд ли улучшат результат.
Пример
Задача: посчитать сумму расходов на оборону США за 1953 год в миллионах долларов по отчётности, где данные разложены по месяцам.
Без агентного поиска модель один раз обращается к индексу и получает разрозненные ежемесячные бюллетени, каждый из которых охватывает лишь часть года. Она видит данные за январь — июнь, но не находит июль — декабрь, поэтому ответ не получается.
С агентным поиском модель делает три шага: сначала ищет по ключевым словам, потом повторно запрашивает более широкое покрытие и находит полный документ за весь год, наконец открывает нужную страницу и читает таблицу со всеми двенадцатью месяцами. Так она получает полный набор значений и складывает их.
| Месяц | Янв | Фев | Мар | Апр | Май | Июн | Июл | Авг | Сен | Окт | Ноя | Дек |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Значение, $млн | 3 632 | 3 501 | 3 789 | 3 891 | 3 746 | 4 056 | 3 890 | 3 519 | 3 787 | 3 647 | 3 540 | 3 465 |
Сумма значений за год — 44 463 миллиона долларов. Вместо одного слепого поиска модель целенаправленно доходит до нужной страницы и таблицы, и ответ опирается на проверенный источник.
Бенчмарки
Mistral сравнила агентный поиск с обычным одноразовым RAG на двух отраслевых тестах. Настройка стандартная — разбиение и ранжирование по умолчанию, без подбора. Сами авторы называют эти результаты нижней границей, а не пределом: настройка под конкретную задачу может дать ещё больше.
В сводке Mistral приводит три общих числа. На финансовых отчётах точность вырастает примерно втрое — с 26,7% до 86% по FinanceBench. Прицельная навигация снижает p90-латентность до 39,6%. Меньше повторных поисков — расход токенов падает до трети.
Проверяли две модели через Search Toolkit: Mistral Medium 3.5 и Z.ai GLM-5.2. Закономерности одинаковые и для собственных, и для сторонних моделей — агентный поиск не привязан к конкретной модели и улучшится с появлением новых.
FinanceBench: 368 отчётов SEC, 150 вопросов
FinanceBench проверяет финансовые вопросы по 368 документам SEC (10-K, 10-Q, 8-K), в среднем около 147 страниц каждый, всего около 53 900 страниц — длинные, насыщенные таблицами материалы. Ответы оценивает судья на языковой модели, калиброванный по человеческим меткам.
- Главный рычаг качества — сам агентный цикл — переход от одноразового RAG к циклу из одного поиска поднимает точность на +47,3 п.п. для MM 3.5 и +52,6 п.п. для GLM-5.2, примерно втрое.
- Навигация добавляет точности — добавление open, navigate, read и grep даёт ещё +8,7 п.п. для MM 3.5 и +6,7 п.п. для GLM-5.2.
- Токены и быстродействие растут вместе с точностью — полный цикл с навигацией отвечает точнее, но тратит меньше токенов, чем цикл с одним поиском: MM 3.5 — на 23,9%, GLM-5.2 — на 33,7%.
- Латентность снижается — на FinanceBench p90 падает с 255 секунд до 154, средняя задержка — со 108 до 71 секунды.
OfficeQA Pro: 696 бюллетеней казначейства, 133 вопроса
OfficeQA Pro — проверяемый числовой тест по историческим бюллетеням Казначейства США: сканы, плотные таблицы, корпус из 696 документов и примерно 89 000 страниц. Отчёт — по первому проходу подмножества из 133 вопросов.
- Агентный поиск работает и на сложном тесте — полный цикл поднимает точность заметно: до 51,9% для GLM-5.2 (+45,6 п.п.) и на +27,1 п.п. для MM 3.5.
- Навигация улучшает качество и экономит ресурсы — полный цикл с навигацией поднимает точность до 35,6% (от +7,5 п.п. для MM 3.5 до +8,3 п.п. для GLM-5.2), снижая расход токенов; число шагов падает до 7,0% для MM 3.5 и на 2,3% для GLM-5.2.
Чем сложнее тест, тем важнее становится цикл поиска. OfficeQA Pro построен на числовых ответах в сканах — обычный RAG почти не продвигается, а агентный цикл позволяет модели искать и проверять доказательства по шагам.
Как начать
Начать можно в облаке или у себя на серверах — в зависимости от выбранного пути.
- Mistral Search Toolkit — встраивание агентного поиска в собственных агентов, рабочие процессы и клиентские внедрения.
- Libraries — агентный поиск из коробки в Studio и Vibe, без самостоятельной сборки системы поиска.
Самый быстрый способ проверить Toolkit — Search Starter App: он создаёт локальный индекс для вашего корпуса по конфигурации по умолчанию, так что агентный поиск можно попробовать, даже не будучи экспертом по поиску.
Когда понадобится настроить вариант под себя, доступны три шага:
- Настроить приём данных — выбрать парсеры, стратегии разбиения, модели для эмбеддинга и экстракторы под ваши данные и типы файлов.
- Настроить индексацию и ранжирование — управлять схемами Vespa, поведением индекса и профилями релевантности.
- Расширить поиск — добавить переписывание запроса, реранжирование или смешанный (гибридный) поиск в конвейер.
Агентный поиск снимает главное ограничение одноразового RAG — невозможность искать долго и глубоко. Когда ответ спрятан в таблице, сноске или разбросан по нескольким документам, модель добирается до сути и проверяет её.
Ограничения
Ограничения
Технические границы, которые важно учитывать перед внедрением агентного поиска.
Нужен правильно настроенный индекс — агентный поиск строится на существующем индексе и не заменяет его.
Если индекс плохо обрабатывает данные — даже многошаговый цикл не спасёт качество.
Результаты зависят от качества данных — для точных цифр документ должен быть читаемым и структурированным.
Сканированные PDF и таблицы без явной структуры могут усложнить поиск.
Стоимость и сложность развёртывания — для запуска у себя нужно разворачивать стек приёма, индексации и поиска в облаке или на своих серверах.
Это вложения в инфраструктуру, которые стоит учитывать заранее.
Дополнительные шаги и латентность — многошаговый цикл длится дольше одного прямого запроса.
Для простых вопросов, где ответ известен заранее, выигрыша не будет.
Антипаттерны
Антипаттерны
Ошибочные ходы, которые сводят пользу агентного поиска к нулю.
Применять ко всем запросам без разбора — агентный поиск окупается на сложных вопросах.
Для прямых запросов с готовым ответом он добавляет шаги без выгоды.
Полагаться на цикл вместо индекса
— если документы разбиты неверно или индекс не находит нужное, агентный цикл тоже не найдёт ответ.
Игнорировать навигацию и проверку
— инструменты открытия, чтения и grep заметно повышают точность на сложных документах.
Чеклист
Чеклист
Проверяемые действия перед внедрением агентного поиска.
Индекс правильно настроен
— проверено разбиение на отрывки, ранжирование и профили релевантности.
Задача уместна для агентного поиска
— вопрос требует поиска по документу или сверки источников.
Выбран инструмент развёртывания — решено, как запускать:
через Search Toolkit с собственной настройкой или через Libraries в Studio и Vibe.
Настроены этапы запуска
— выбраны парсеры, стратегии разбиения, модели для эмбеддинга и экстракторы под данные.
Ссылки
Ссылки
- Документация: Документация Mistral
- Сайт: Продукты Mistral