 Vorobeoff
Alibaba открыла превью Qwen4-Max — первой модели семейства Qwen 4. Это флагман с окном в миллион токенов, мультимодальным входом и упором на кодинг и агентные сценарии. Разбираем официальные характеристики, условия доступа и планы по остальным моделям семейства.
Линейка Qwen — одна из самых активных среди открытых и облачных моделей. После Qwen3 и Qwen3.8 команда готовит следующее поколение: 22 сентября на Apsara Conference Alibaba объявила, что Qwen 4 находится в тренировке, и показала план на Qwen 4.5 и Qwen 5.
Первый шаг этого плана уже доступен для теста. 11 ноября в Model Studio открылось двухнедельное превью Qwen4-Max — флагмана семейства. Модель работает в облаке Alibaba Cloud и доступна через Qwen Chat, приложение Qwen, Qwen Studio, Qwen Work и IDE Qoder.
Семейство Qwen 4 заявлено как линейка из четырёх моделей: Max, Plus, Flash и 27B. Ниже — что известно о каждой из них и как устроен флагман на старте.
Что представила Alibaba
22 сентября 2026 года на Apsara Conference в Ханчжоу Alibaba Cloud объявила, что следующее поколение Qwen 4 находится в тренировке. Глава команды Qwen Лю Даихенг показал слайд с четырьмя позициями: Max, Plus, Flash и 27B. В пресс-релизе того дня компания добавила ориентир для следующих поколений — Qwen 4.5 и Qwen 5 с масштабом до 5–10 трлн параметров.
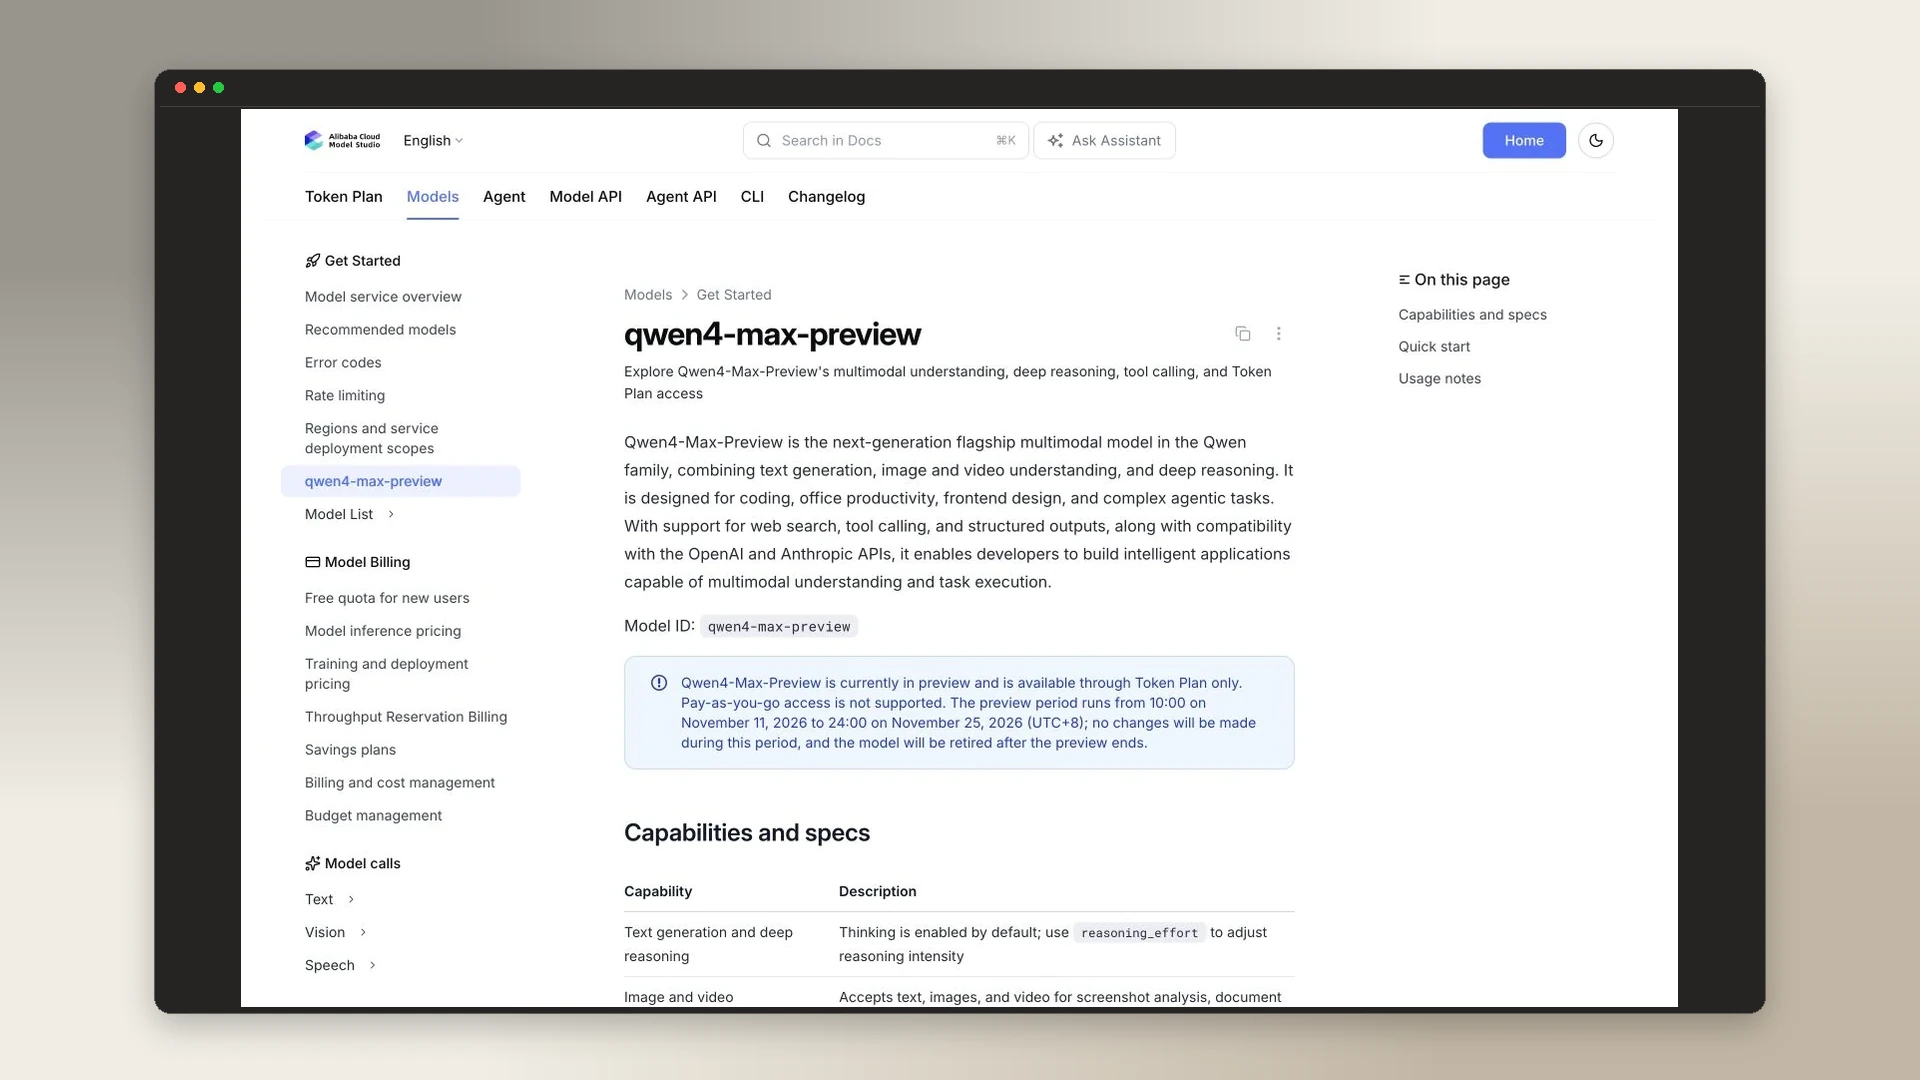
Через полтора месяца последовал первый практический шаг. 11 ноября в Model Studio появилась страница qwen4-max-preview с пометкой Token Plan. Это единственная модель семейства, которую можно потрогать: через Qwen Chat, приложение Qwen, Qwen Studio, Qwen Work и IDE Qoder. Доступ идёт только по подписке Token Plan. Pay-as-you-go недоступен, превью закроют 25 ноября в 24:00 UTC+8.
6 ноября официальный аккаунт Qwen выложил тизер без названия модели — классическую фразу и три английских слова The becoming begins.. Технических деталей в нём не было, это чисто анонсовый постер.
Qwen4-Max Preview: что подтверждает документация
Официальная спека Model Studio описывает Qwen4-Max-Preview как флагманский мультимодальный релиз: текст, изображение и видео на входе, генерация текста и глубокое рассуждение на выходе. Модель заточена под кодинг, работу с документами, фронтенд и агентные сценарии.
Ключевой параметр — контекст 1 млн токенов и максимальный вывод 393 216 токенов. Это общий бюджет на thinking и финальный ответ: рассуждение съедает часть лимита, поэтому max_tokens в Chat Completions теперь эквивалентен max_completion_tokens. Если выставить привычный лимит только под ответ, вывод обрежется.
Thinking включён по умолчанию. Интенсивность задаётся параметром reasoning_effort: low, medium, xhigh — последний стоит по умолчанию. До трёх уровней, без отдельного max. При мультихходовой беседе нужно возвращать reasoning_content из assistant-сообщений как есть и не склеивать его с content — иначе контекст мышления потеряется.
Набор инструментов стандартный для облачных флагманов: Function Calling, встроенный веб-поиск, structured outputs в виде JSON Object и JSON Schema. Заявлена совместимость с OpenAI Chat Completions, Responses и Anthropic Messages API, что упрощает подмену эндпоинта.
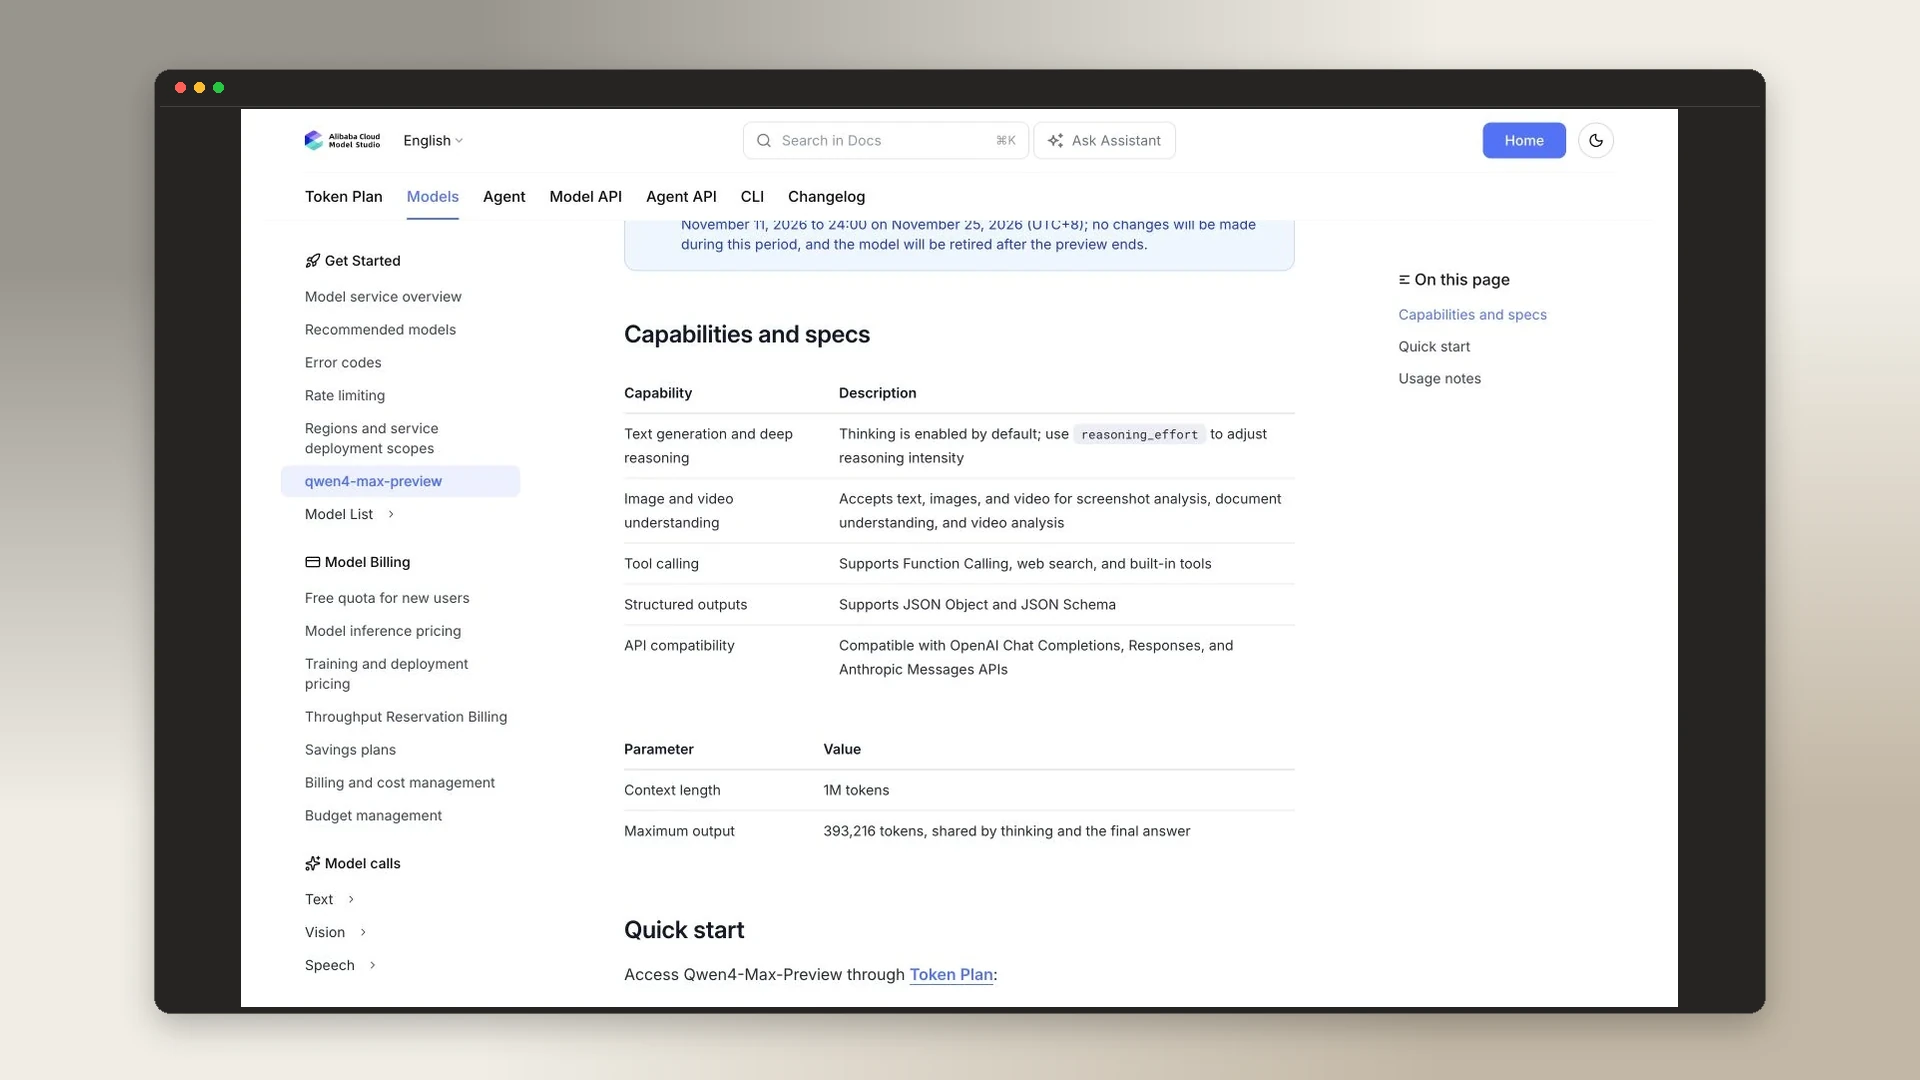
| Параметр | Значение |
|---|---|
ID модели | qwen4-max-preview |
Контекст | 1 000 000 токенов |
Макс. вывод | 393 216 токенов (thinking + ответ) |
Входы | текст, изображение, видео |
Thinking | вкл. по умолчанию: low / medium / xhigh (дефолт) |
Доступ | только Token Plan, 11–25 ноября 2026 |
Endpoint |
Важно: Qwen4-Max Preview — облачная модель без весов. Локально её не запустить, выгрузить веса нельзя, а после 25 ноября превью-модель будет отозвана.
Семейство из четырёх моделей: что анонсировано и чего нет
На слайде Apsara семейство выглядело аккуратно: Max как самый способный флагман, Plus как сбалансированный мультимодальный уровень, Flash для быстрой работы с большими объёмами и 27B как модель с открытыми весами для локального развёртывания.
Но это и всё, что известно официально. Никаких карточек, параметров, лицензий, цен и дат для Plus, Flash и 27B нет. Даже тизерное название Qwen4-27B означает только порядок размера — 27 млрд, как у предыдущей плотной 27B-модели Qwen3.8-27B, — а не подтверждённую архитектуру. Сравнивать её напрямую с текущими открытыми весами пока рано.
Ориентир по срокам даёт предыдущее поколение. Qwen3.8-Max вышел в начале августа как MoE на 2,4 трлн параметров с 95 млрд активных и тем же окном в 1 млн токенов. Младшие открытые веса появились позже флагмана. Если Alibaba повторит эту схему, 27B и остальные модели выйдут уже после общего релиза Max, а не внутри двухнедельного превью.
Отдельно стоит вспомнить логику открытых весов: открытая модель живёт на вашем железе и под вашей лицензией, а облачный флагман — в чужом облаке и по чужим правилам. Для Qwen 4 эту границу пока не проводили — весь Qwen 4 сейчас только облако.
Архитектурный намёк и зачем он нужен
Единственная публичная подсказка про будущую архитектуру — карточка Qwen3.8-Flash-Next. В ней прямо сказано, что это экспериментальный превью архитектуры, которая ляжет в основу Qwen4. Модель открытая, её можно скачать и пощупать сегодня.
Это полигон для обкатки будущей архитектуры, а не сам Qwen 4. По нему видно направление — больше эффективности на длинных контекстах и агентных сценариях, — но переносить цифры и лицензии с превью-архитектуры на будущий релиз нельзя. Как и считать, что Qwen4-27B уже готова, раз анонс прозвучал.
Подтверждённых бенчмарков Qwen4-Max в документации Model Studio тоже нет. Все сравнения, которые гуляют по соцсетям, пока относятся к Qwen3.8-Max или к неофициальным прогонам.
Кому стоит тестировать превью прямо сейчас
Превью имеет смысл трём группам. Разработчикам агентов — чтобы проверить, как модель держит длинные цепочки с инструментами, сохраняет thinking между шагами и возвращает структурированный JSON. Командам, которые делают документы и фронтенд, — чтобы прогнать скриншоты, видео и вёрстку в одном запросе с окном в миллион токенов. И тем, кто уже сидит в экосистеме Qwen (Chat, Work, Qoder) — там доступ включается быстрее.
Практический тест займёт полчаса. Возьмите один повторяющийся сценарий: разбор отчёта с тремя графиками, генерация лендинга по скриншоту, или агент, который ищет в вебе, вызывает две функции и отдаёт JSON по схеме. Прогоните его на Qwen4-Max Preview и на Qwen3.8-Max через тот же OpenAI-совместимый эндпоинт, сравните качество структуры ответа, стабильность вызовов и расход бюджета на thinking. Этого достаточно, чтобы понять, есть ли выигрыш до общего релиза.
Тем, кто ждёт локальный запуск, тестировать пока нечего. Лучше дождаться карточки Qwen4-27B с лицензией и реальными весами. Любые инструкции «скачайте Qwen4-27B сегодня» — ошибка.
Статус остальных моделей и ограничения превью
- Открытых весов Qwen 4. Ни Max, ни Plus, ни Flash, ни 27B не выложены на Hugging Face или ModelScope.
- Цены за токен. Model Studio прямо пишет: Token Plan only, без pay-as-you-go и без прайса за токен в превью. Считать экономику продакшена пока нельзя.
- Бенчмарков от Alibaba. В официальной спеке их нет, поэтому сравнивать Qwen4-Max с GPT, Claude или DeepSeek по чужим таблицам некорректно.
- Дат для Plus, Flash и 27B. «Очень скоро» с 22 сентября — это единственная официальная формулировка, не дедлайн.
- Гарантий сохранения превью-модели. После 25 ноября qwen4-max-preview ретайрится. Код, завязанный на этот ID, перестанет работать — закладывайте смену модели заранее.
Пока для Plus, Flash и 27B нет весов, цены, бенчмарков и дат — только общий анонс от 22 сентября. Превью Max завершится 25 ноября, после чего модель будет отозвана, поэтому код стоит сразу делать переносимым на будущий общий релиз.
Что это меняет и с чего начинать
Alibaba делает предсказуемый шаг: флагман уходит в облачную подписку с длинным контекстом и агентным уклоном, а открытые веса остаются на потом. Это повторяет логику Qwen 3.8, но с более жёсткой привязкой к Token Plan уже на этапе превью.
Для команд это означает развилку. Если ваш процесс требует длинного окна, мультимодальности и стабильных вызовов инструментов, Qwen4-Max стоит прогнать в превью, чтобы оценить механику thinking-бюджета и работу со схемой ответа. Если же ваша сильная сторона — локальные пайплайны и контроль данных, ждите 27B и проверяйте лицензию, а не тизер.
Начните с одного сценария, где результат видно глазами: вёрстка по скриншоту, сводка по десятку документов или агент с двумя функциями и JSON-выходом. Сравните поведение с Qwen3.8-Max на тех же данных. Если выигрыш устойчив, готовьте переход на общий релиз Max; если нет — оставьте Qwen4 в списке наблюдения и не перестраивайте архитектуру под двухнедельное превью.
Ссылки
- Документация: Qwen4-Max-Preview — спека и доступ
- Документация: Model Studio: новые релизы моделей
- Сайт: Alibaba Cloud на Apsara: роадмап Qwen 4 / 4.5 / 5