В модели Fish Audio S2 Pro нет привычных фонем. Разработчики научили её генерировать звук так же, как LLM генерируют текст, и теперь интонацией управляют обычные текстовые теги.
Обычные системы синтеза речи подходят для новостей и аудиокниг. Но если вы делаете голосового бота, начинаются проблемы. Голос звучит монотонно. Он не чувствует контекст. Чтобы добавить эмоции, приходится собирать сложные конструкции из SSML-тегов (как в Silero или облачных движках).
Fish Audio предложили другой подход. Их новая модель S2 Pro обучалась на 10 миллионах часов аудио. Она работает со звуком как с обычным языком. Вы больше не настраиваете ползунки интонации. Вы пишете в тексте \[whisper\] или \[laughing\], и голос отыгрывает нужную эмоцию. Посмотрим, как это устроено.
Эмоции прямо в тексте
В старых TTS-моделях для смены интонации приходилось дообучать сеть или мучиться с фонетической разметкой. В S2 Pro вы управляете голосом через теги. Модель понимает более 15 000 описаний на английском языке — от коротких команд вроде \[angry\], \[sigh\], \[laughing\] до свободных фраз типа \[professional broadcast tone\].
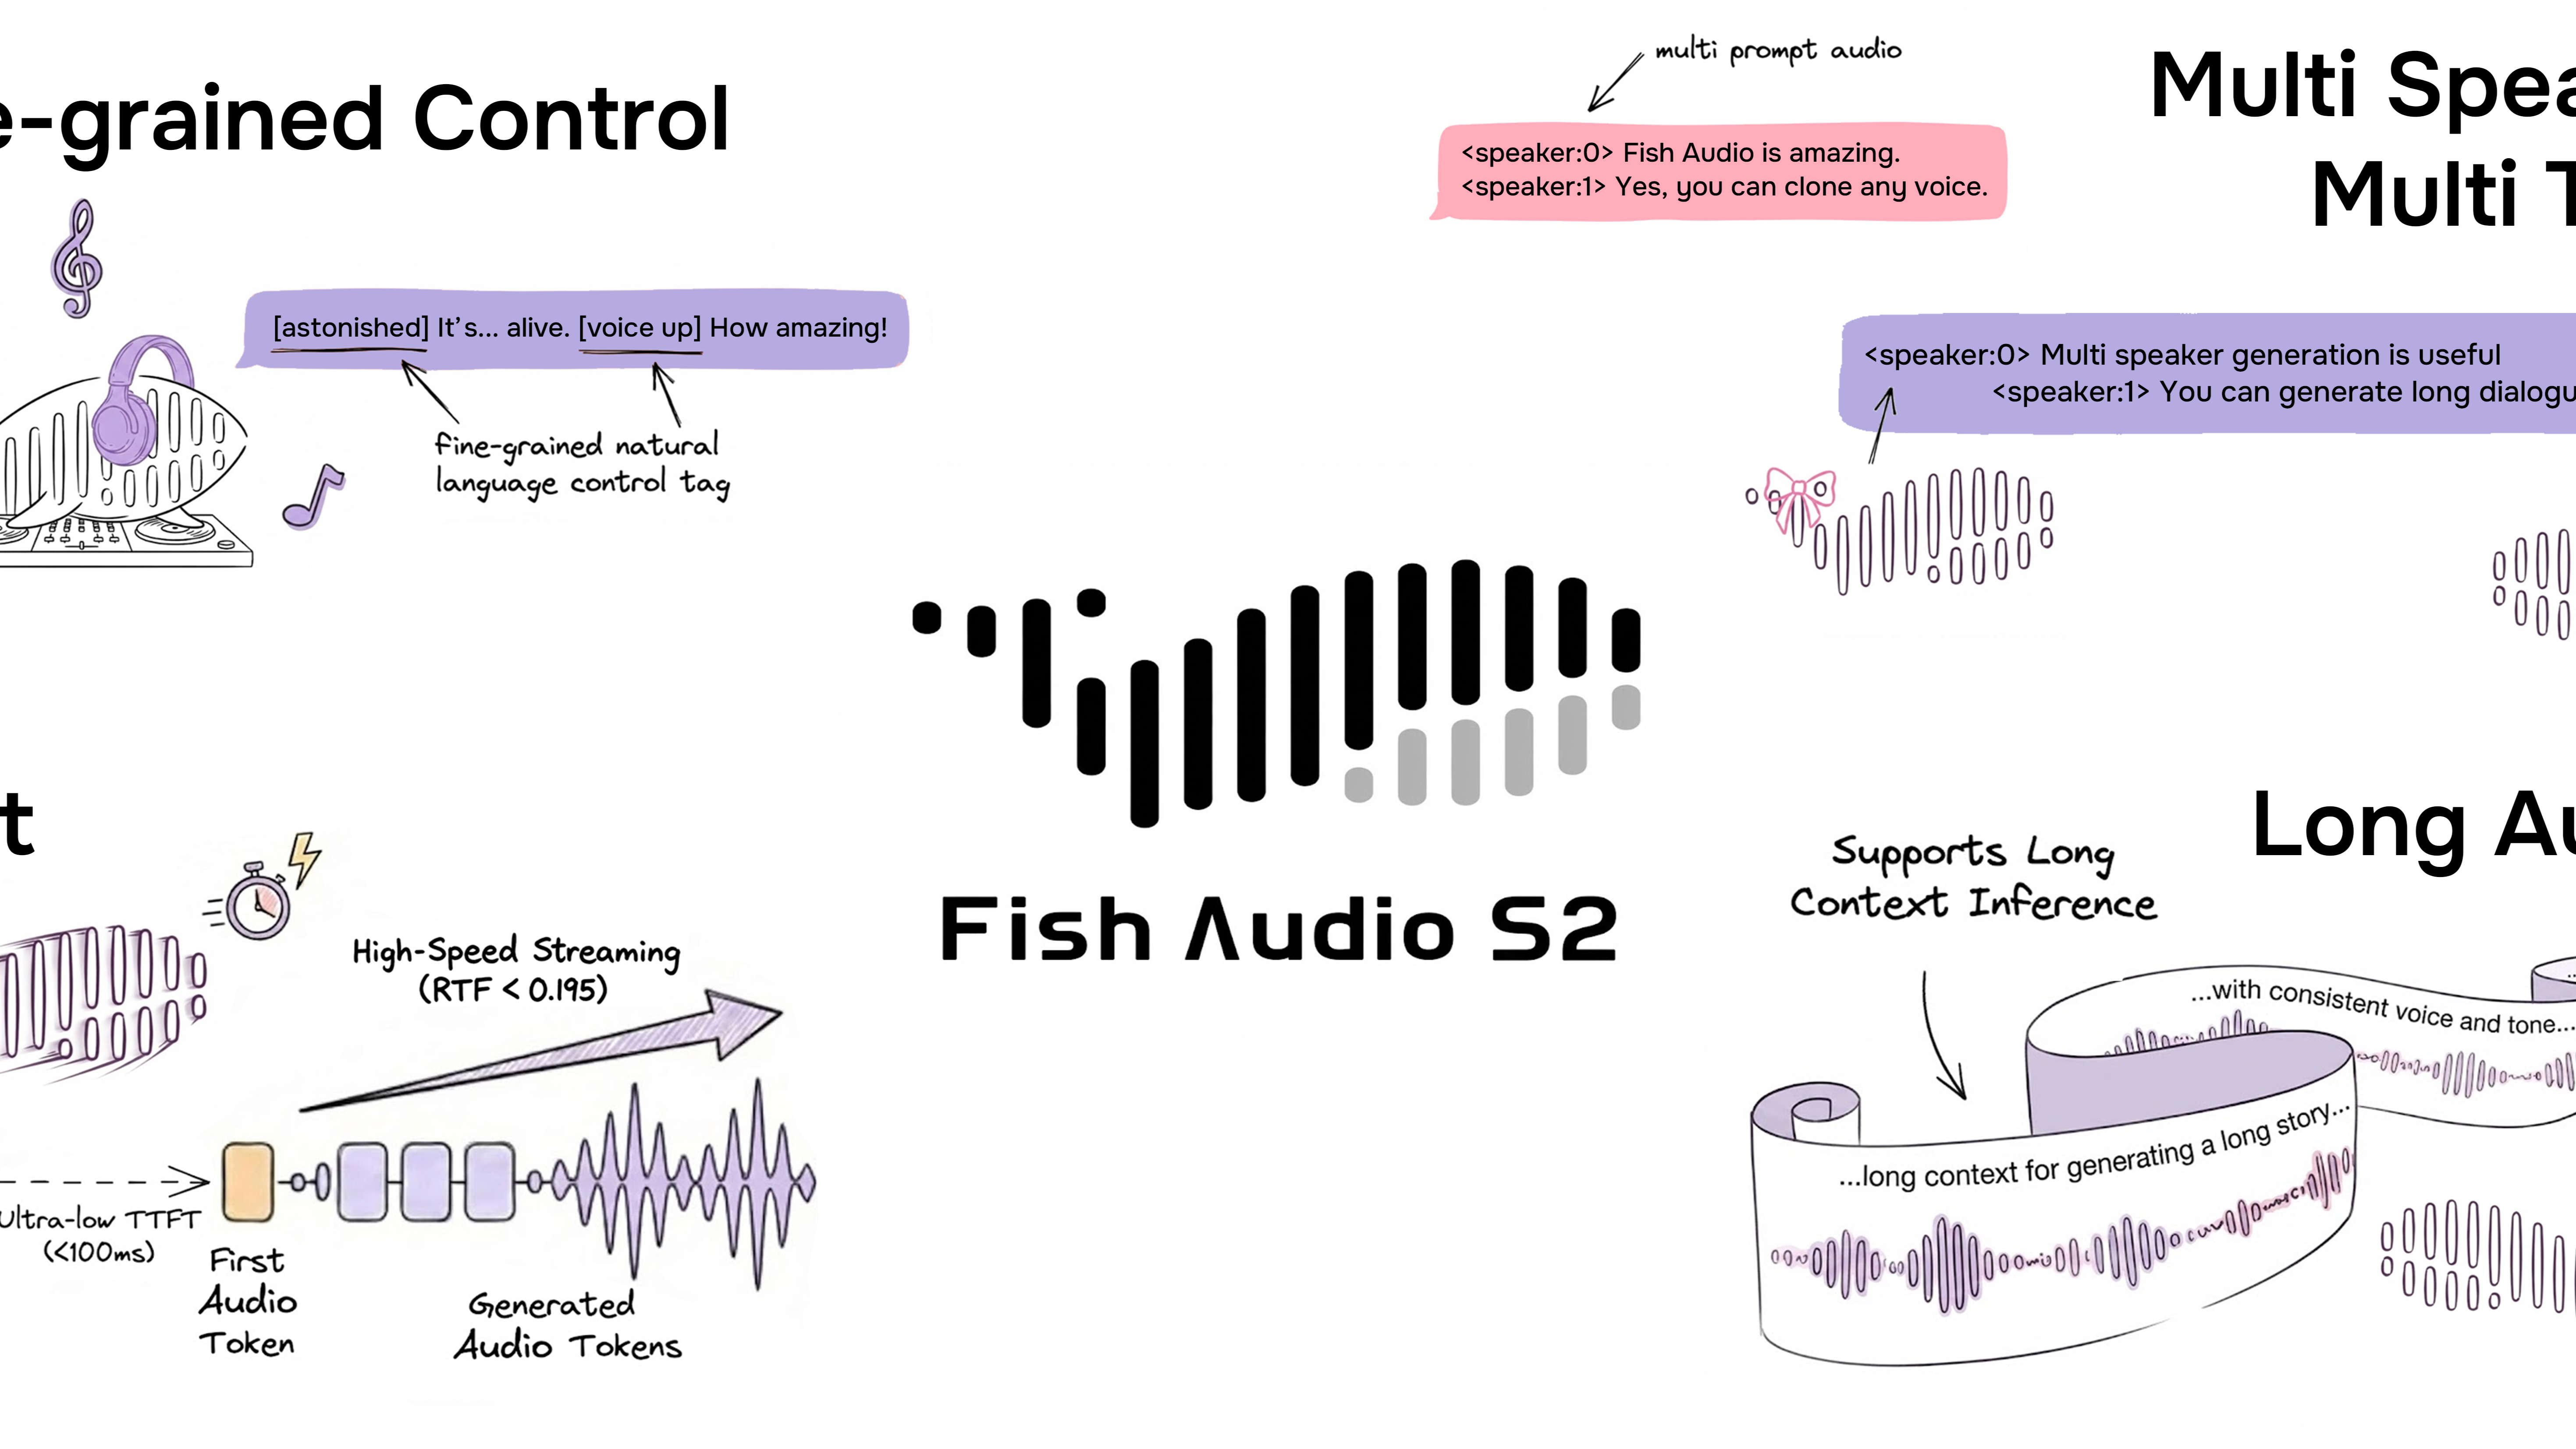
Для разработчиков это меняет архитектуру приложения. За логику эмоций теперь отвечает не аудио-модель, а ваша основная языковая LLM (открытая модель вроде Qwen или облачный агент). Она сама решает по контексту, где вставить вздох \\\[short pause\\\], а где сказать фразу с акцентом \\\[with strong accent\\\]. Fish Audio лишь озвучивает переданные теги. Модель также нативно поддерживает мультиязычность и умеет говорить разными голосами в одной реплике, если передать токены <|speaker:i|>.
Как это работает изнутри: Dual-AR архитектура
В S2 Pro нет привычной цепочки «текст → акустическая модель → вокодер». Здесь работает двойная авторегрессионная архитектура (Dual-AR), состоящая из двух трансформеров:
- Медленный AR (4 млрд параметров). Движется по временной оси и генерирует базовый семантический слой звука. Именно он следит за интонацией и выполняет текстовые команды из тегов.
- Быстрый AR (400 млн параметров). На каждом шаге он достраивает остальные 9 слоев остаточных кодовых книг (residual codebooks). Это восстанавливает акустические детали, добавляя звуку глубину и реалистичность.
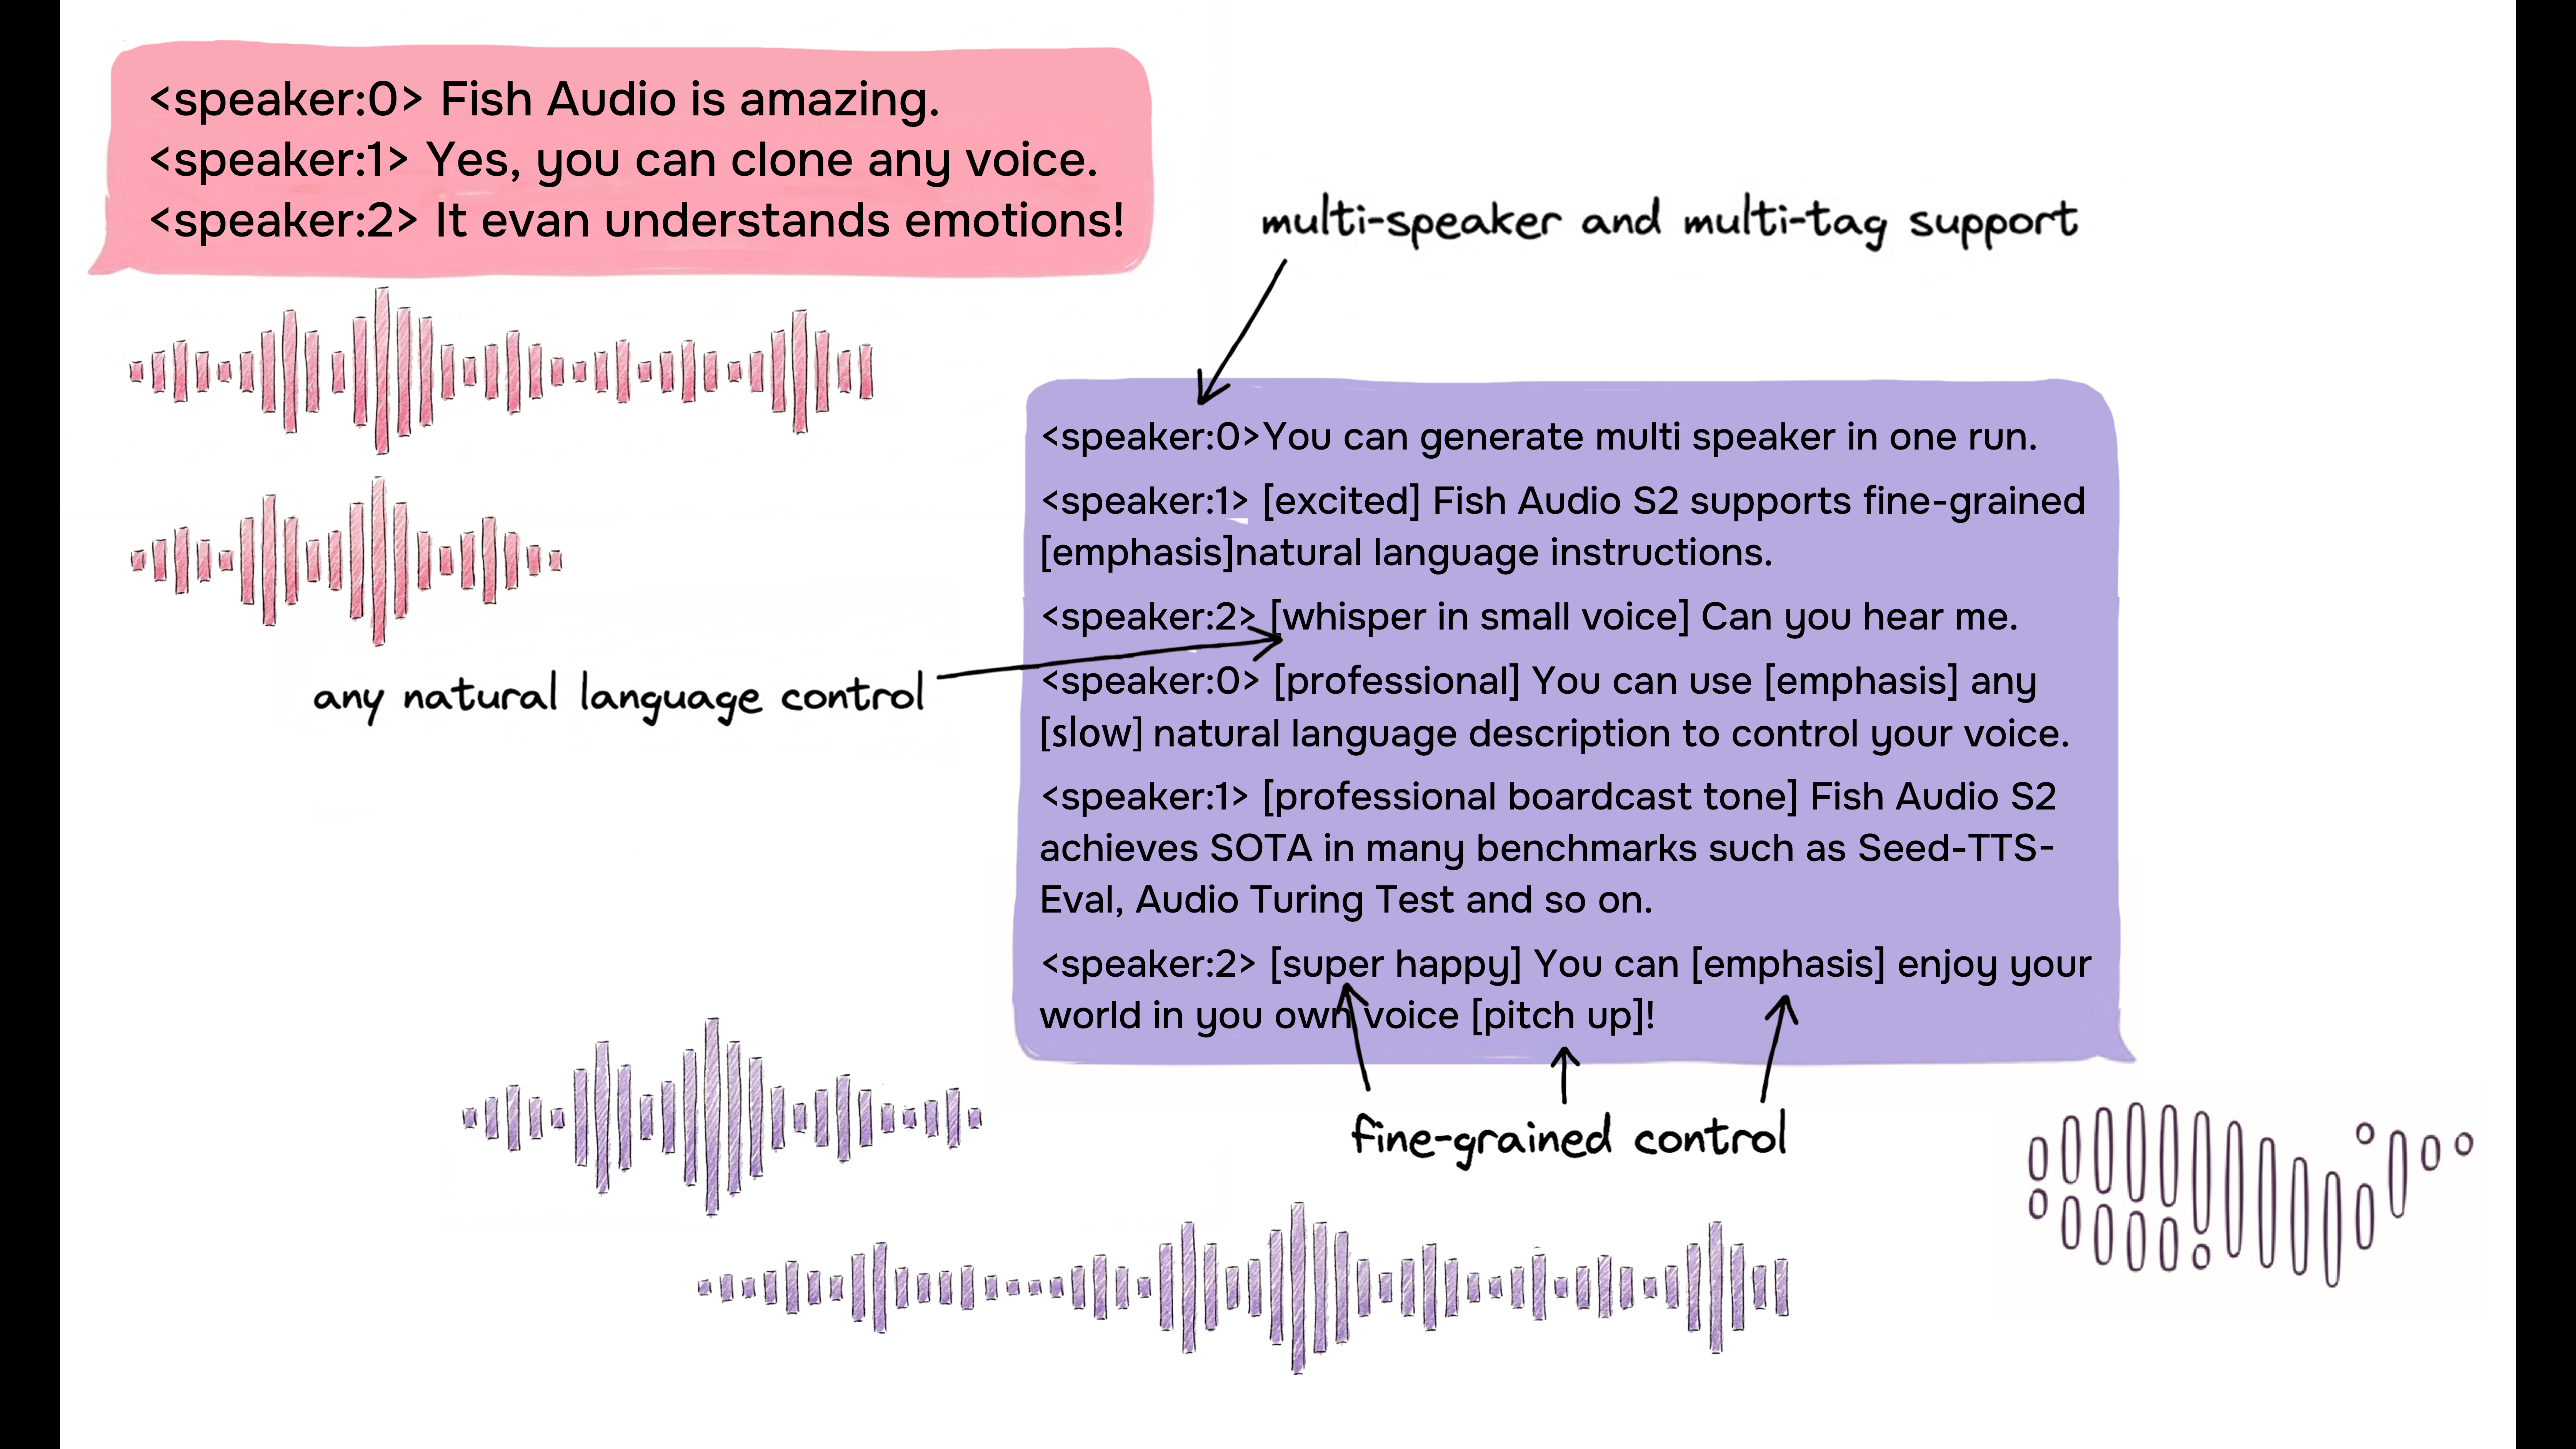
Такая асимметрия задач дает высокую детализацию звука без потери скорости. На видеокарте H200 модель выдает фактор реального времени (RTF) около 0.195, а время до первого звука (Time-to-First-Audio, TTFA) составляет всего около 100 миллисекунд. Голосовой бот начинает отвечать без пауз.
Обучение с подкреплением для звука (GRPO)
Текстовые LLM давно тренируют с помощью RLHF, чтобы они давали адекватные ответы. Создатели Fish Audio применили этот же метод к генерации аудио, используя алгоритм GRPO (Group Relative Policy Optimization) на этапе выравнивания.
Отдельные модели-критики (реворд-модели) слушают сгенерированный звук и оценивают его по четырем параметрам: семантическая точность, следование тегам, акустическая привлекательность и сходство тембра с оригиналом. Благодаря этому S2 Pro реже ошибается в ударениях и звучит естественно, даже если модель обучали на «грязных» аудиозаписях из интернета.
Ограничения
Ограничения
Требования к железу: Модель крупная (4B).
Для стриминга с низким RTF в продакшене потребуется GPU уровня H200 и серверный движок SGLang с поддержкой Paged KV Cache.
Аудиогаллюцинации: В основе лежит языковая модель, поэтому иногда она придумывает лишнее.
Голос может проглотить окончание, сгенерировать неразборчивый звук или добавить случайный вздох.
Zero-shot клонирование: Модель умеет клонировать голос «на лету» по отрывку аудио в 10–30 секунд.
Но если вам нужен безупречный фирменный голос для бренда без артефактов, сеть всё равно придется дообучать (файн-тюнинг).
Антипаттерны
Антипаттерны
Писать сложную разметку:
Использовать старые SSML-теги для пауз и эмоций вместо естественных текстовых команд вроде \[whisper\].
Жестко задавать эмоции: Прописывать интонации в коде вручную.
Логичнее поручить выбор эмоций текстовой LLM, которая генерирует сам ответ бота.
Запускать на CPU для интерактива:
Пытаться развернуть 4-миллиардную модель на слабых серверах без GPU и ожидать приемлемого TTFA для диалогового агента.
Чеклист
Чеклист
Подготовьте реальные фразы:
Соберите 20-30 реплик из логов ваших реальных разговоров с пользователями.
Настройте LLM-маршрутизатор:
Попросите вашу текстовую нейросеть расставить эмоции в этих фразах (например, добавить \[chuckle\] в шутку).
Сделайте клон:
Запишите 15–30 секунд чистого референсного аудио для инициализации голоса.
Замерьте задержки: Посчитайте время от отправки запроса до первого звука (TTFA).
Для комфортного разговора оно должно укладываться в 100–300 мс.
Ссылки
Ссылки
- Документация: Fish Audio Docs: Capabilities
- Репозиторий: Fish Speech GitHub Repository
- Репозиторий: HuggingFace: s2-pro Model