 Vorobeoff
Open-source библиотека, которая синтезирует, распознаёт и детектирует русскую речь на обычном процессоре — без облака, API-ключей и платных подписок.
Что это
Голос в приложении обычно означает зависимость: облачный API, лимиты, ключи, счета. Silero идёт другим путём. Это набор предобученных нейросетей для работы с речью, которые запускаются локально — на том же процессоре, где крутится ваш код. Модели подключаются одной строкой через pip или torch.hub, не требуют GPU и работают офлайн.
Внутри три семейства:
- TTS (text-to-speech) — синтез речи из текста. Главная причина, по которой большинство разработчиков приходят в проект.
- STT (speech-to-text) — распознавание речи в текст. По качеству сопоставимо с Google, Yandex и SberSpeech, но работает без сети.
- VAD (voice activity detection) — детектор голоса. Отделяет тишину и шум от полезного сигнала. Silero VAD v6 стал индустриальным стандартом для голосовых пайплайнов.
Проект развивает российская команда Silero Team. Ключевая идея — embarrassingly simple: модели подключаются минимальным кодом, работают на обычном CPU и не требуют инфраструктуры. Это не облачный сервис с тарифами, а библиотека, которую можно установить и забыть про счета.
Лицензии разделены. Основной репозиторий опубликован под CC-BY-NC 4.0 — только некоммерческое использование. Но модели v5_cis_base и v5_cis_base_nostress вышли под MIT, их можно использовать в коммерческих продуктах. Русский язык в них доступен с префиксом ru_.
Важно: перед внедрением в коммерческий проект проверьте, какая именно модель вам нужна. Бесплатные модели для исследований и платные для бизнеса — это разные пакеты лицензий.
Что это и как использовать
Если вы когда-нибудь работали с Ollama для локальных LLM, логика знакома: одна команда установки, модель скачивается при первом запуске, дальше всё работает офлайн. Silero — то же самое для речи.
Три шага до первого аудио:
-
- Установите библиотеку:
pip install silero torch torchaudio omegaconf
- Установите библиотеку:
-
- Загрузите модель одной строкой кода — она скачается и закешируется автоматически
-
- Вызовите
model.save\_wav(text="Привет", speaker="xenia")— получите WAV-файл
- Вызовите
Пять минут от установки до готового файла. Не преувеличение.
Возможности русского языка
Русский — флагманский язык проекта. В актуальной версии v5_5_ru доступны пять голосов: aidar, baya, kseniya, xenia, eugene. Каждый со своим тембром и характером — от мягкого женского до низкого мужского.
Но голоса — это начало. Вот что делает русский слой уникальным:
- Автоматические ударения. Модель сама определяет ударную гласную в каждом слове. Размечать текст вручную не нужно.
- Омографы по контексту. Слова «зАмок» и «замОк» пишутся одинаково, но звучат по-разному. Модель различает их по тому, как слово употреблено в предложении.
- Вопросительная интонация. Доступна с версии v5_4_ru. Вопросы озвучиваются с корректным повышением тона в конце, а не как утверждение с вопросительным знаком.
- SSML-разметка. Управление паузами, скоростью и тоном через XML-теги прямо внутри текста — аналог того, что предлагают облачные TTS-сервисы.
- Три частоты дискретизации: 8000, 24000 и 48000 Гц. 48 кГц звучит почти студийно. 8000 Гц — для телефонии, где важна экономия трафика.
Алфавит — стандартный русский: абвгдеёжзийклмнопрстуфхцчшщъыьэюя.
Версии русских моделей
Модель эволюционировала через несколько версий. Каждая добавляла возможности:
| Модель | Голоса | Ударения | Омографы | Вопросы |
|---|---|---|---|---|
v5_5_ru (последняя) | aidar, baya, kseniya, xenia, eugene | Да | Да | Да |
v5_4_ru | aidar, baya, kseniya, xenia | Да | Да | Да |
v5_3_ru | 5 голосов | Да | Да | Нет |
v5_ru | 5 голосов | Да | Да | Нет |
v4_ru | 5 голосов + random | Да | Нет | Нет |
Для коммерческих проектов подойдут v5_cis_base и v5_cis_base_nostress — русские голоса в них доступны с префиксом ru_ и лицензией MIT. Модели из основной таблицы выше предназначены только для некоммерческого использования.
Совет: если вам не нужна вопросительная интонация, v5_3_ru и v5_ru работают почти так же, но легче и быстрее. Выбирайте минимальную модель, которая покрывает ваши требования.
Как устроено
Архитектура — end-to-end нейросети. Это значит, что модель принимает сырой текст на вход и отдаёт аудиосигнал на выходе, без промежуточных этапов фонемизации, выравнивания и вокодера, которые разделяют классические TTS-системы. Один проход сети — готовый звук.
Минимальные требования: Python 3.8+, процессор с поддержкой AVX2 (любой современный x86/64 CPU), PyTorch 2.0+ для моделей пятой версии. GPU не обязателен — модели работают на процессоре с приемлемой скоростью. На Mac с Apple Silicon доступно ускорение через mps.
Установка
Три способа подключения, от простого к продакшен-варианту.
Через pip
Рекомендуемый путь для большинства задач:
pip install silero torch torchaudio omegaconfЧерез PyTorch Hub
Если не хотите ставить отдельный пакет Silero, достаточно PyTorch:
pip install torch torchaudio omegaconfМодель скачивается при первом вызове torch.hub.load() и кешируется в ~/.cache/torch/hub.
Standalone — офлайн на проде
Для production-окружения без доступа в интернет: скачайте.pt файл один раз, дальше используйте локально. Нужны только PyTorch и стандартная библиотека Python.
curl -L -o v5_ru.pt https://models.silero.ai/models/tts/ru/v5_ru.ptПример
Три способа запустить синтез — под тот же способ установки.
Через pip-пакет
from silero import silero_tts

model, example_text = silero_tts(language='ru', speaker='v5_ru')
audio = model.apply_tts(text=example_text)
Через PyTorch Hub
import torch

language = 'ru'
model_id = 'v5_ru'
sample_rate = 48000
speaker = 'xenia'
device = torch.device('cpu')

model, _ = torch.hub.load(
    repo_or_dir='snakers4/silero-models',
    model='silero_tts',
    language=language,
    speaker=model_id,
)
model.to(device)

text = 'Привет! Это первый тест синтеза речи на русском языке.'
audio_path = model.save_wav(
    text=text,
    speaker=speaker,
    sample_rate=sample_rate,
)
print(f'Файл сохранён: {audio_path}')
Standalone — офлайн-вариант
import os
import torch

device = torch.device('cpu')
torch.set_num_threads(4)
local_file = 'v5_ru.pt'

if not os.path.isfile(local_file):
    torch.hub.download_url_to_file(
        'https://models.silero.ai/models/tts/ru/v5_ru.pt',
        local_file,
    )

model = torch.package.PackageImporter(local_file).load_pickle('tts_models', 'model')
model.to(device)

text = 'Меня зовут Лёва Королёв, и я открою все ваши замки.'
model.save_wav(text=text, speaker='baya', sample_rate=48000)
Управление озвучкой через SSML
SSML (Speech Synthesis Markup Language) — язык разметки для управления речью. Позволяет вставлять паузы, менять скорость и тон отдельных фраз, размечать параграфы. Работает как XML-теги внутри текста, который передаёте в model.save_wav().
ssml_text = '''
<speak>
  Сегодня <prosody rate="slow">очень важная</prosody> новость.
  <break time="500ms"/>
  Мы запускаем новый продукт!
</speak>
'''

model.save_wav(text=ssml_text, speaker='kseniya', sample_rate=48000)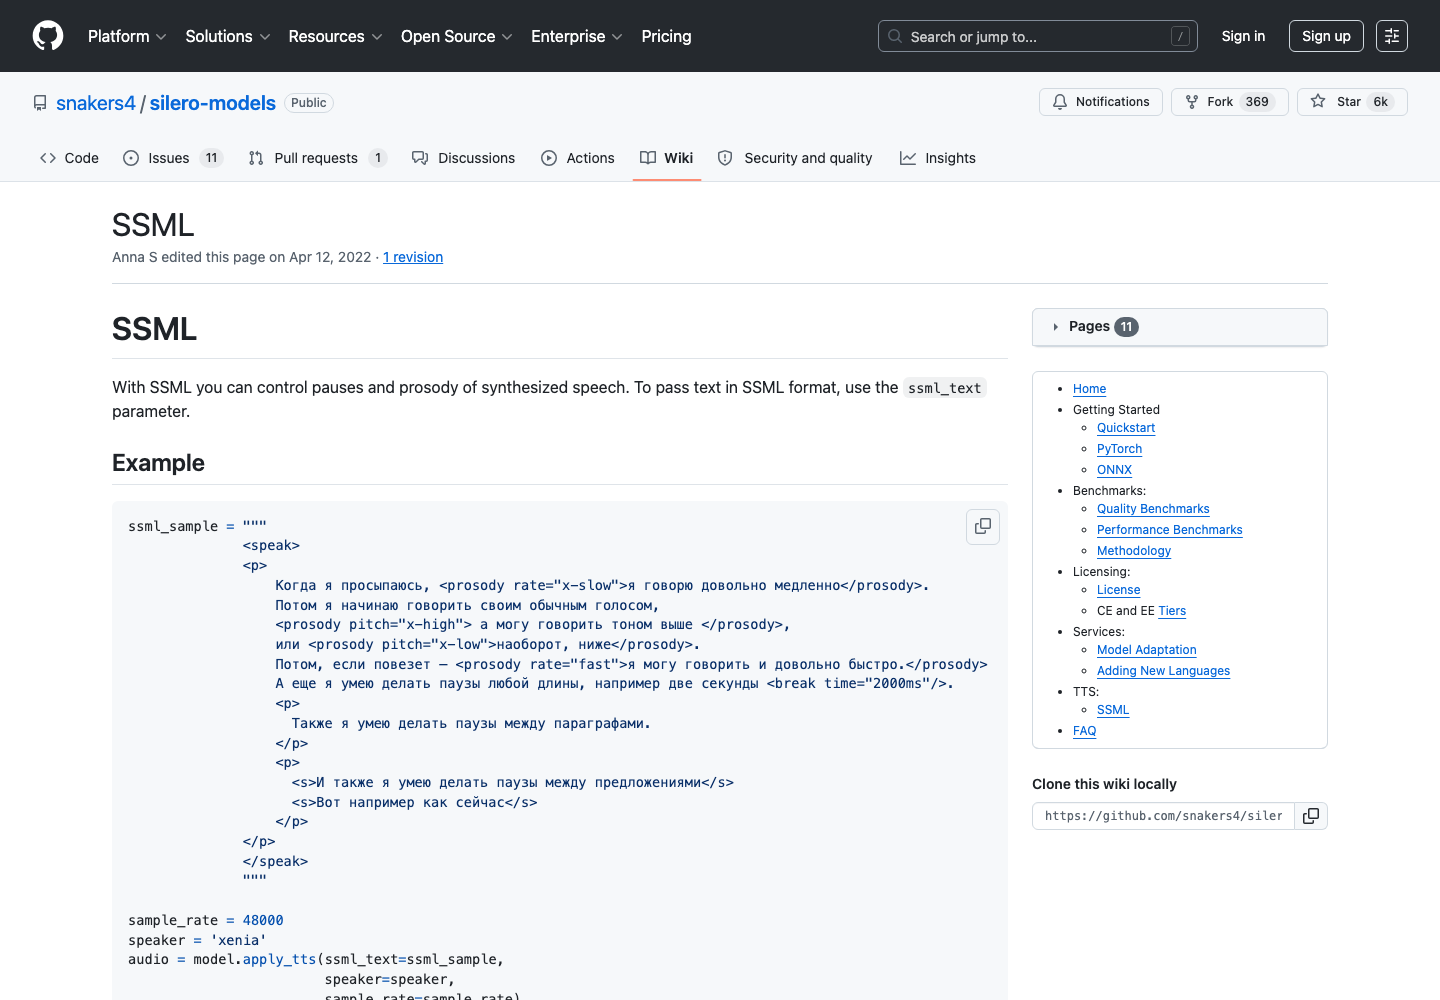
Базовые теги разметки:
<break time="500ms"/>— вставка паузы на указанное время<prosody rate="slow|fast">...</prosody>— меняет темп произнесения отрывка<prosody pitch="high|low">...</prosody>— сдвигает тон голоса вверх или вниз<p>и<s>— разметка параграфов и предложений, между которыми модель ставит дыхательные паузы
Инсайт: SSML — это единственный способ тонко настроить интонацию без переобучения модели. Если голос звучит монотонно на длинном тексте, расставьте
между абзацами — результат меняется радикально.
Ручная расстановка ударений
Автоматика иногда ошибается с омографами. Если модель выбрала неправильное ударение, поставьте его вручную — знаком + перед нужной гласной:
text = 'Стальной з+амок и навесной зам+ок — это разные вещи.'
model.save_wav(text=text, speaker='xenia', sample_rate=48000)
Тот же приём работает в моделях v5_cis_base. Но там ручная разметка ударений требуется для каждого слова на не-славянских языках — автоматика их не расставляет.
Использование в связке с Codex
Codex — CLI-агент от OpenAI, который умеет ставить пакеты и запускать скрипты. Silero вписывается в его workflow без трения: одна команда установки плюс один Python-файл.
Шаблон промпта для Codex
Текст, который можно передать Codex для развёртывания Silero:
Настрой Python-окружение для Silero TTS на русском:
1. Создай venv в папке .venv и активируй его.
2. Установи зависимости: pip install silero torch torchaudio omegaconf soundfile.
3. Создай скрипт tts.py, который принимает текст из аргумента --text
   и имя голоса --speaker (по умолчанию xenia), генерирует WAV в папке out/
   через модель v5_ru на 48 кГц.
4. Покажи пример запуска и проверь, что файл создаётся.
Codex развернёт окружение и напишет скрипт примерно такого вида:
# tts.py
import argparse
import os
from pathlib import Path
import torch

MODEL_URL = 'https://models.silero.ai/models/tts/ru/v5_ru.pt'
MODEL_FILE = Path('models/v5_ru.pt')

def load_model():
    MODEL_FILE.parent.mkdir(parents=True, exist_ok=True)
    if not MODEL_FILE.exists():
        torch.hub.download_url_to_file(MODEL_URL, str(MODEL_FILE))
    model = torch.package.PackageImporter(str(MODEL_FILE)).load_pickle('tts_models', 'model')
    model.to(torch.device('cpu'))
    return model

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--text', required=True)
    parser.add_argument('--speaker', default='xenia',
        choices=['aidar', 'baya', 'kseniya', 'xenia', 'eugene'])
    parser.add_argument('--out', default='out/result.wav')
    args = parser.parse_args()

    Path(args.out).parent.mkdir(parents=True, exist_ok=True)
    model = load_model()
    path = model.save_wav(text=args.text, speaker=args.speaker, sample_rate=48000, audio_path=args.out)
    print(f'OK -> {path}')

if __name__ == '__main__':
    main()
Запуск:
python tts.py --text "Codex теперь умеет говорить." --speaker bayaРазвёрнутые сценарии для Codex
Когда базовый скрипт работает, поверх него можно строить полноценные сервисы. Вот что Codex собирает без доработки:
- Пайплайн пакетной озвучки — подайте файл posts.md с текстами постов, и агент разобьёт его на абзацы, сгенерирует отдельный WAV для каждого и сложит в папку
- Telegram-бот на aiogram — бот принимает текстовое сообщение, прогоняет через tts.py и отвечает голосовым сообщением
- HTTP-сервис на FastAPI — эндпоинт /tts принимает JSON с текстом и именем голоса, отдаёт WAV-файл в ответ
- Озвучка сценария для YouTube — Codex берёт сценарий, вставляет SSML-паузы между абзацами и склеивает финальный WAV через pydub
- Параллельная обработка папки — все файлы из texts/*.txt озвучиваются одновременно, torch.set_num_threads(4) ограничивает загрузку CPU
Настройки для стабильной работы с Codex
Несколько правил, которые экономят время в Codex-сессиях:
- Фиксируйте параметры явно: версию модели (v5_5_ru), имя голоса, частоту дискретизации. Codex по умолчанию может выбрать устаревшую версию
- Требуйте локальное кеширование.pt файла — без этого агент скачивает модель при каждом запуске скрипта
- На Mac с Apple Silicon укажите: «ускорение через mps, если доступно, иначе cpu» — это использует GPU чипа M-серии
- Для текстов длиннее ~1000 символов просите агента автоматически нарезать на чанки и склеивать WAV-файлы — модель не рассчитана на длинные фрагменты за один вызов
STT и VAD
TTS — не единственная возможность библиотеки. Если в задаче нужен не только синтез, но и распознавание:
- Silero STT — распознавание русской речи. Качество на уровне облачных сервисов Google, Yandex и SberSpeech, но без сетевого соединения. Аудио не покидает машину — это важно для конфиденциальных записей.
- Silero VAD v6 — определитель присутствия голоса в аудиопотоке. Отсекает тишину, шум и паузы, оставляя только речевые сегменты. Необходим в любом голосовом контуре: транскрибация звонков, голосовые ассистенты, запись встреч. Без VAD распознавание работает с мусорными данными.
Оба модуля подключаются тем же torch.hub.load. Для замкнутого голосового пайплайна в Codex получается готовая цепочка: VAD отсекает тишину, STT переводит речь в текст, ваша логика генерирует ответ, Silero TTS озвучивает результат.
Важно: VAD — не опция по желанию для голосового пайплайна. Без него STT получает куски тишины и шума, которые портят распознавание и тратят ресурсы. VAD стоит первым в цепочке.
Ограничения
Что учитывать
Лицензия и коммерческое использование — главный барьер.
Голос больше не требует облака. Пять строк кода, один WAV-файл, ноль счетов за API.
| Пункт | Пояснение |
|---|---|
CC-BY-NC 4.0 на основном репозитории — Модели v5_5_ru, v5_4_ru, v5_3_ru, v5_ru, v4_ru доступны только для некоммерческих проектов. | Для коммерции нужно использовать модели под MIT: v5_cis_base и v5_cis_base_nostress, где русский доступен с префиксом ru_. |
Требование AVX2 — Модели не запустятся на старых процессорах без инструкций AVX2. | Любой x86/64 CPU последних лет их поддерживает, но на арендованных VPS с устаревшими конфигурациями стоит проверить через lscpu | grep avx2. |
PyTorch 2.0+ для v5 — Пятерка моделей требует свежий PyTorch. | На старых версиях работают только v4 и ниже, что означает потерю вопросительной интонации и разрешения омографов. |
Ограничение по длине текста — Модели не рассчитаны на синтез длинных текстов за один вызов. | Для текстов свыше ~1000 символов требуется ручная нарезка на чанки и последующая склейка WAV-файлов. |
Антипаттерны
Чего не делать
| Пункт | Пояснение |
|---|---|
Не использовать основную модель в коммерческом проекте — Лицензия CC-BY-NC 4.0 запрещает. | Если продукт зарабатывает деньги, берите v5_cis_base под MIT. Разница в качестве есть, но юридический риск перевешивает. |
Не качать модель при каждом запуске — Файл.pt весит десятки мегабайт. | Без локального кеширования каждый запуск начинается с сетевой задержки. В Codex-сессиях это особенно критично: агент может перезапускать скрипт многократно. Скачайте один раз и используйте standalone-режим. |
Не игнорировать SSML на длинных текстах — Без пауз и вариаций скорости голос звучит монотонно. | Чем длиннее текст, тем заметнее проблема. Расставьте между абзацами и для акцентов — результат звучит как начитка, а не как робот. |
Чеклист
Проверка перед запуском
| Пункт | Пояснение |
|---|---|
Проверьте лицензию | — Определите, нужна ли коммерческая модель (v5_cis_base под MIT) или достаточно основной (v5_5_ru под CC-BY-NC 4.0) |
Проверьте AVX2 — Выполните lscpu | grep avx2 на Linux или sysctl -n machdep.cpu.features на Mac. | Если AVX2 нет, модель не запустится. |
Установите PyTorch 2.0+ — Для v5-моделей это обязательное требование. | Проверьте версию командой python -c import torch; print(torch.version) |
Выберите частоту дискретизации | — 48000 Гц для студийного качества, 24000 Гц для веб-аудио, 8000 Гц для телефонии |
Протестируйте омографы — Если в тексте есть слова типа «замок», «мука», «печи», проверьте, правильно ли модель расставила ударения. | Если нет — используйте ручную разметку через + |
Ссылки
- Репозиторий: github.com/snakers4/silero-models
- Документация: SSML Wiki
- Сайт: Telegram-чат проекта
- Статья: Омографы и ударения
- Статья: v5 и качество синтеза