 Vorobeoff
Открытый инструмент: подаёте на вход ссылку, видео, подкаст или файл — получаете готовое саммари. Два интерфейса — терминал и боковая панель браузера. Ни копипаста, ни переключения вкладок.
Что это и как начать
Summarize — утилита, которая берёт источник (веб-страница, видео, подкаст, PDF, файл на диске) и отдаёт суть. Это не браузерный bookmark-менеджер и не note-taking app. Это конвейер: подали на вход — получили текст.
Аналогия из разработки: curl для содержимого. Вы не открываете страницу руками и не копируете текст в ChatGPT. Вы указываете URL — инструмент сам загружает, очищает, транскрибирует (если нужно) и суммаризирует через LLM.
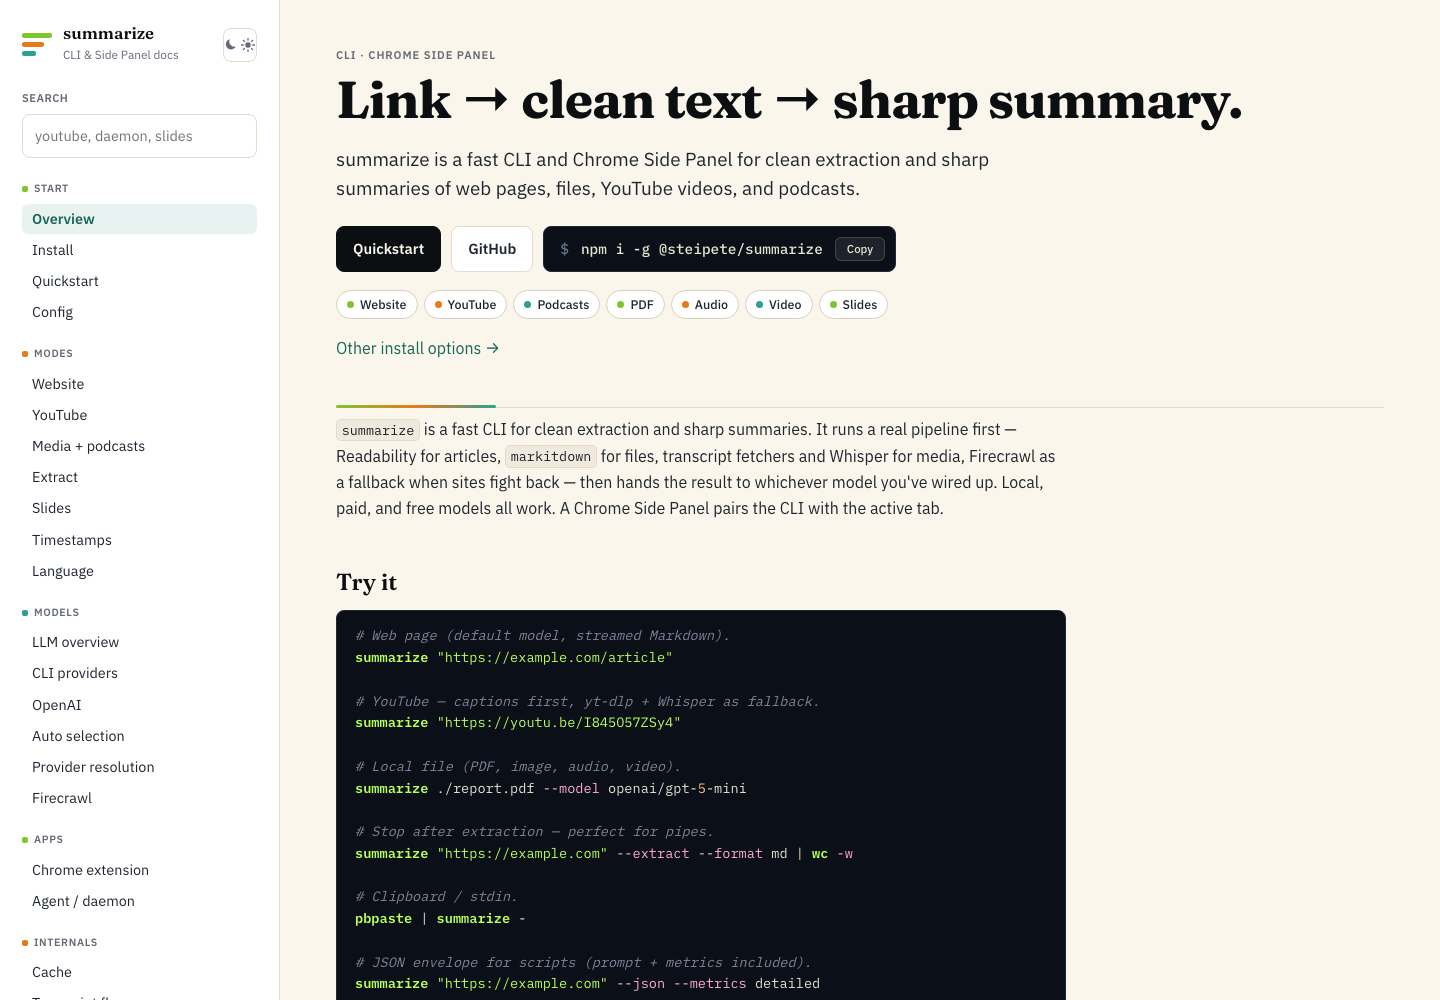
Три шага до первого саммари:
- Установите CLI:
npm i -g @steipete/summarize - Задайте ключ API любой поддерживаемой модели (или запустите локальную через Ollama)
- Выполните:
summarize "https://example.com/article"
Пять минут, не преувеличение. Если у вас уже стоит Ollama — даже быстрее, ключ не нужен.
Проект открытый, лицензия MIT, написан на TypeScript. На GitHub больше 6 500 звёзд, последний релиз — v0.21.7 (июль 2026). Активно развивается, коммиты идут регулярно.
Зачем нужен
Десять ссылок в закладках, три непросмотренных подкаста, PDF-отчёт на 80 страниц. Знакомая картина. Ручное чтение каждого источника съедает часы, а итог — пара ключевых тезисов, ради которых всё и открывалось.
Summarize сокращает маршрут: вы указываете на источник, получаете структурированное саммари. Без копипаста в чат-бот, без переключения между вкладками.
Инсайт: Инструмент решает не проблему «прочитать быстрее», а проблему «решить, стоит ли читать вообще». Саммари — это фильтр, не замена.
Кому полезен:
- Разработчикам контент-пайплайнов, где из потока ссылок нужно вытащить главное — автоматически, скриптом, без ручного чтения
- Тем, кто работает с медиа, но не готов тратить час на подкаст ради нескольких содержательных минут
- Создателям AI-агентов, которым нужен очищенный от разметки текст со страниц — не обрывки HTML, а читаемые данные
Как работает
Конвейер из трёх этапов. Каждый решает свою задачу и передаёт результат следующему.
Fetch + Extract. Загрузка источника, очистка HTML, нормализация в Markdown. Для сайтов с тяжёлым JS или защитой от парсинга подключается Firecrawl — сервис, который рендерит страницу и извлекает чистый текст. Это fallback, не основной путь.
Transcript. Для YouTube и подкастов — поиск опубликованных транскриптов (субтитры YouTube, RSS-фиды подкастов). Если готового транскрипта нет — запускается Whisper, модель распознавания речи от OpenAI, которая работает локально и расшифровывает аудио в текст.
Summarize + Format. LLM генерирует саммари. Результат выводится потоково — в терминал или в боковую панель браузера. Потоковый вывод означает, что текст появляется по мере генерации, не дожидаясь полного ответа.
Важно: Все три этапа работают локально, кроме вызова к LLM. Если используете облачную модель — текст уходит к провайдеру. Если локальную через Ollama — ничего не покидает машину.
CLI: ключевые возможности
Установка через npm:
npm i -g @steipete/summarizeБазовые команды:
# Саммари веб-страницы
summarize "https://example.com/article"

# YouTube-видео с автоопределением транскрипта
summarize "https://youtu.be/..." --youtube auto

# PDF с выбором модели
summarize "/path/report.pdf" --model google/gemini-3-flash-preview

# Длинное саммари
summarize "https://example.com" --length long
Что умеет CLI:
- Обрабатывать URL, PDF, изображения, аудио и видео, YouTube и подкасты
- Извлекать чистый текст без суммаризации через
--extract— полезно, когда нужен исходный текст, а не пересказ - Выводить результат в JSON через
--json— для передачи в другие инструменты и скрипты - Показывать метрики через
--metrics— количество токенов, время обработки, выбранная модель - Выбирать модель в автоматическом режиме через
--model auto— размер входных данных и тип контента определяют, какая модель справится лучше - Кэшировать транскрипты — повторный запрос к тому же видео не запускает расшифровку заново, текст берётся из кеша
Совет: Флаг
--extractбез суммаризации — недооценённая возможность. Если вы строите RAG-пайплайн (система, которая ищет релевантные фрагменты текста и передаёт их LLM для ответа), чистый текст из веб-страниц без HTML-шума — именно то, что нужно.
Chrome Side Panel и Firefox Sidebar
Браузерное расширение встраивает боковую панель. Клик — и текущая вкладка схлопывается в саммари. Есть режим автосуммари: переключаетесь на другую вкладку, панель перегенерирует содержимое сама.
В сайдбар встроен чат с историей и потоковым выводом. Можно уточнять детали по содержимому страницы, не уходя с неё.
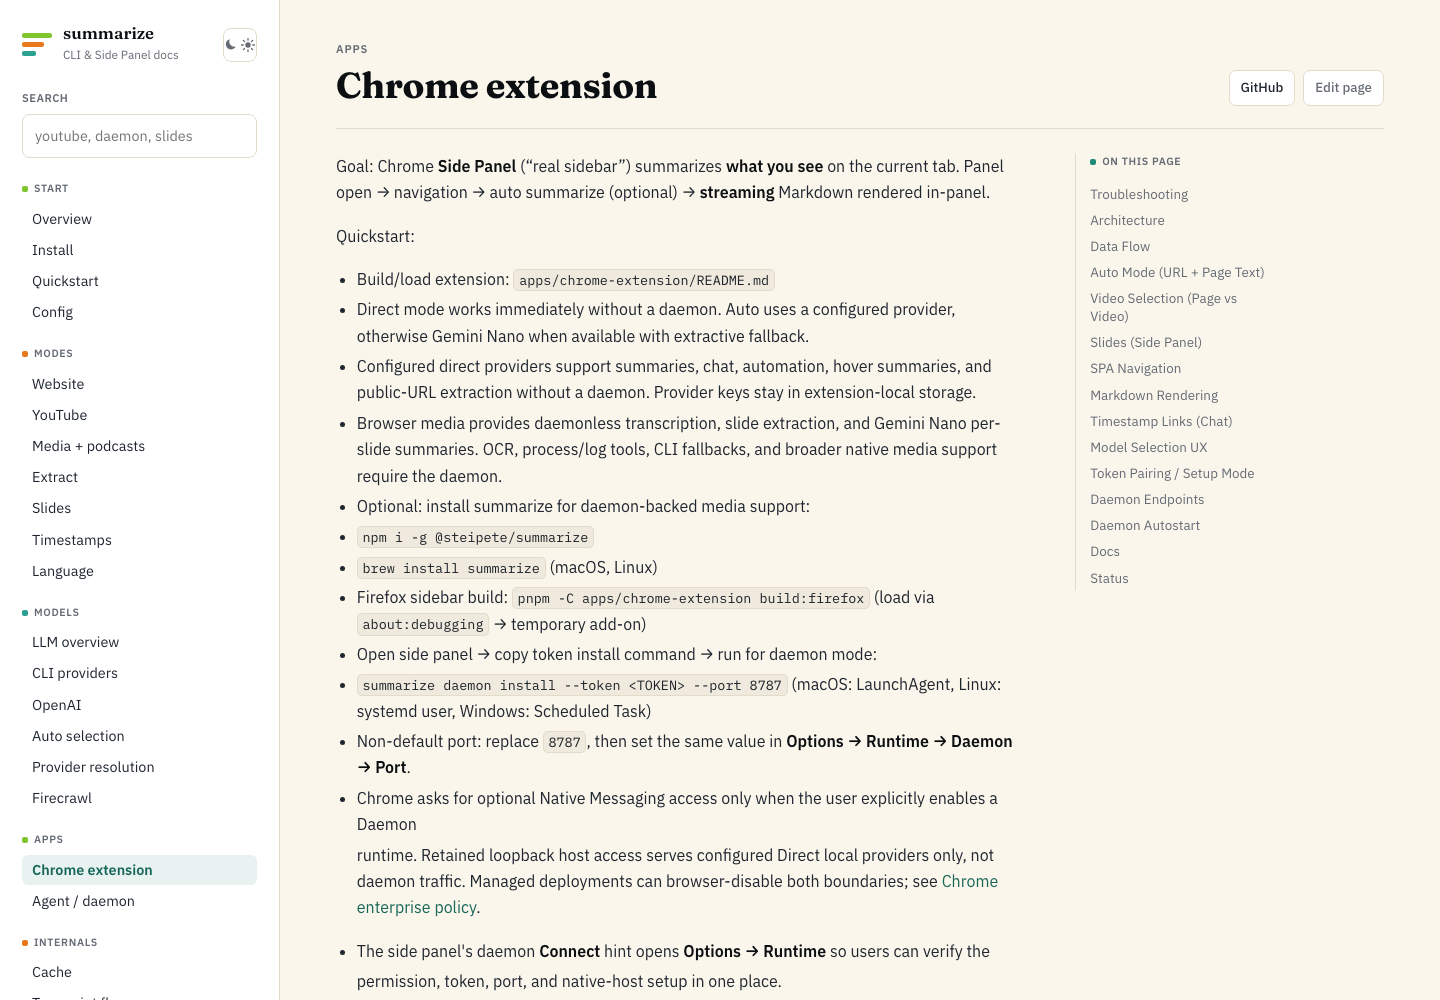
Архитектура: расширение обращается к локальному демону на localhost, доступ к которому защищён токеном. Данные никуда не уходят — за исключением запросов к LLM, если выбрана облачная модель. CLI и расширение — это не два продукта, а один инструмент с двумя лицами. Терминал — для скриптов и автоматизации. Боковая панель — для работы мышкой.
Расширение доступно в Chrome Web Store. Альтернатива — сборка из исходников.
Внимание: Локальный демон должен быть запущен для работы расширения. Если CLI не установлен или демон неактивен — боковая панель не сможет генерировать саммари.
Поддержка моделей
Summarize — provider-agnostic. Это значит, что инструмент не привязан к конкретному провайдеру LLM и работает с любым OpenAI-совместимым API.
Поддерживаются:
- Локальные модели через OpenAI-совместимые шлюзы — Ollama, LM Studio и аналогичные
- Платные провайдеры — OpenAI, Google Gemini, Anthropic Claude
- Бесплатные модели через OpenRouter — сервис-агрегатор, который даёт доступ к моделям разных разработчиков через один API
Флаг --model auto включён по умолчанию. Он подбирает модель, исходя из типа контента и объёма токенов на входе. Не сработала одна — инструмент переключается на следующую из списка. За этим стоит практическая логика: короткую веб-страницу нет смысла гонять через модель с большим контекстным окном, а часовой подкаст маленькая модель просто не осилит.
Инсайт: Provider-agnostic — не маркетинговое слово, а архитектурное решение. Инструмент обращается к моделям через единый протокол (OpenAI API format), и добавление нового провайдера сводится к поддержке этого формата. Если завтра выйдет новая модель — она заработает без обновления Summarize.
YouTube и подкасты
Медиа-контент — отдельный контур. Видео и аудио нельзя «прочитать» как HTML, нужен транскрипт. Summarize использует двухэтапный подход:
Сначала ищет опубликованные транскрипты. Для YouTube это субтитры, которые загрузил автор или сгенерировал сам сервис. Для подкастов — RSS-фиды, в которых часто есть текстовая расшифровка. Это быстро и бесплатно.
Если готового транскрипта нет — запускает Whisper. Модель распознавания речи работает локально, расшифровывает аудио в текст. Это медленнее, но не требует подписок и не отправляет аудио в облако.
Дополнительные возможности:
- Таймкоды — кликабельные метки
\[mm:ss\]в тексте саммари переносят к нужному моменту видео - Режим слайдов для YouTube — скриншоты видео + OCR (распознавание текста на изображениях) + транскрипт с привязкой ко времени. Полезно для презентаций и лекций, где визуальный контент важен не меньше речи
Совет: Кэш транскриптов экономит и время, и токены. Второй запуск по тому же источнику не запускает Whisper — расшифровка берётся из кеша. Для пайплайнов, которые регулярно обращаются к одним и тем же ссылкам, это критично.
Когда использовать
- Ресёрч и мониторинг — оценка за полминуты, стоит ли открывать статью или видео целиком. Саммари работает как фильтр, не как замена
- Контент-пайплайны —
summarizeв cron-задаче или bash-скрипте перерабатывает десятки ссылок без участия человека. Тезисы собираются автоматически - Видеоконтент — суть часового подкаста за 30 секунд. Таймкоды ведут к нужному фрагменту, перемотка не нужна
- AI-агенты — флаги
--jsonи--extractотдают структурированные данные, готовые для передачи в другие инструменты. Агент получает чистый текст, а не разметку
«Но ведь это просто очередной AI-саммаризатор, которых десятки?»
Нет. Разница в архитектуре: Summarize — не веб-сервис, а CLI-инструмент с браузерным интерфейсом. Вы контролируете, какая модель работает, где она работает (локально или в облаке), и как результат интегрируется в ваш пайплайн. Веб-сервис даёт удобство ценой контроля. CLI даёт контроль ценой порога входа. Summarize даёт оба интерфейса.
Инструмент, который берёт хаос из 20 вкладок и возвращает суть в одном окне — это не магия, а правильно собранный конвейер.
Ограничения
| Пункт | Пояснение |
|---|---|
Требует Node.js и npm — Установка через npm i -g, что означает необходимость Node.js окружения. | Для пользователей без Node.js это барьер входа. Альтернативы — Docker-образ или сборка из исходников, но оба пути сложнее одной команды npm. |
Локальный демон для расширения — Браузерное расширение работает только при запущенном локальном демоне на localhost. | Если демон не активен, боковая панель бесполезна. Это связывает расширение с машиной, на которой установлен CLI — удалённая работа с расширением требует дополнительной настройки. |
Качество саммари зависит от модели — Инструмент не имеет собственной модели и не улучшает качество входного текста. | Если модель слабая, саммари будет поверхностным. —model auto смягчает это, но не гарантирует оптимальный выбор для каждого случая. |
Whisper требует ресурсов — Локальная транскрибация часового подкаста через Whisper занимает время и требует вычислительных ресурсов. | На машине без GPU процесс может длиться минуты. Для регулярной обработки длинных медиа-файлов стоит рассмотреть GPU-ускорение. |
Антипаттерны
| Пункт | Пояснение |
|---|---|
Использовать только для коротких страниц — Для статьи на 500 слов саммари избыточно. | Инструмент раскрывается на длинных источниках: часовые подкасты, PDF на 80 страниц, многостраничные гайды. Короткий текст быстрее прочитать глазами. |
Игнорировать —extract — Если вам нужен чистый текст для RAG-пайплайна или датасета, —extract даёт именно его без суммаризации. | Использование полного саммари вместо исходного текста теряет детали, которые могут быть критичны для поиска. |
Передавать чувствительные данные через облачные модели — Если источник содержит конфиденциальную информацию, облачная модель отправит его провайдеру. | Для таких случаев используйте локальные модели через Ollama. Инструмент не предупреждает об этом автоматически. |
Полагаться на —model auto для критичных задач — Автоматический выбор модели оптимизирован для скорости и стоимости, не для максимального качества. | Для аналитических саммари, где важна точность, указывайте модель явно через —model. |
Чеклист
| Пункт | Пояснение |
|---|---|
Node.js и npm установлены — Команда node —version возвращает версию без ошибок. | Если Node.js нет — установите через официальный инсталлятор или пакетный менеджер. |
CLI установлен — npm i -g @steipete/summarize завершилась без ошибок. | Проверьте: summarize —help выводит справку. |
Ключ API настроен — Хотя бы один провайдер доступен: | ключ API для OpenAI/Gemini/Claude/OpenRouter, или Ollama запущена локально на порту по умолчанию. |
Базовая команда работает — summarize «https://example.com» отдаёт результат. | Если ошибка — проверьте ключ API и подключение. |
Для расширения: | демон запущен — Локальный демон активен, токен сгенерирован, боковая панель подключается и генерирует саммари текущей вкладки. |
Для медиа: Whisper доступен — Проверьте через summarize —help, есть ли опция транскрибации. | Для длинных медиа убедитесь, что хватает ресурсов (GPU ускорит процесс). |
Для пайплайнов: JSON протестирован — Вывод —json парсится вашим скриптом корректно. | Структура JSON соответствует ожиданиям до боевом запуске. |
Ссылки
- GitHub: steipete/summarize
- Сайт: summarize.sh
- Документация: Chrome Web Store