 Vorobeoff
Docling — инструмент с открытым исходным кодом для обработки документов. Он извлекает текст, таблицы и сведения о структуре страниц из PDF, сканов и офисных файлов, а затем преобразует результат в формат, удобный для поиска и дальнейшей обработки. Это полезно при создании баз знаний и систем RAG, которым нужны данные из документов, а не просто набор страниц.
Что это
Docling развивается в экосистеме IBM Research и LF AI & Data. Он помогает работать с документами, где обычное копирование текста даёт плохой результат: например, с PDF в две колонки, отсканированными договорами или отчётами с таблицами. Инструмент определяет порядок чтения, распознаёт текст там, где это необходимо, и сохраняет структуру документа.
Основной компонент — Python-библиотека. Объект DocumentConverter принимает файл или ссылку на него и возвращает DoclingDocument. В этом представлении сохраняются текстовые блоки, заголовки, таблицы и другие элементы. Результат можно экспортировать в Markdown, JSON и другие форматы. Для работы из терминала предусмотрен интерфейс командной строки (CLI), для подключения по HTTP — docling-serve, а для ИИ-агентов существует MCP-сервер.
Библиотеку можно запустить локально на Linux, Windows и macOS, без обязательной отправки документов в стороннее облако. На 16 ноября 2026 года актуальные версии в PyPI — docling 2.150.1 и docling-serve 1.38.2. Docling распространяется под лицензией MIT, но лицензии отдельных моделей могут отличаться. Для установки библиотеки нужен Python 3.10–3.14.
При подготовке данных для RAG Docling решает задачу, которая предшествует поиску: превращает исходный файл в текст с понятной структурой. Затем его можно разделить на небольшие фрагменты (чанки), добавить сведения об источнике и передать в поисковую систему. Сам Docling не заменяет векторную базу или языковую модель. О том, как работает весь процесс, подробнее рассказано в материале RAG для чайников.
Зачем нужно
- Обрабатывать сложные PDF. Извлекать текст из документов с колонками, заголовками, сносками и таблицами, сохраняя их расположение и порядок чтения.
- Распознавать сканы. Использовать OCR (оптическое распознавание символов), чтобы получить текст из отсканированных страниц и фотографий документов.
- Готовить документы для RAG. Сохранять заголовки и структуру, чтобы при разбиении на фрагменты не терялся контекст.
- Работать с нетекстовыми элементами. Извлекать таблицы, формулы и код, а при дополнительной настройке получать описания изображений.
- Создать единый сервис обработки. Запустить Docling на собственном сервере и обращаться к нему из других приложений через HTTP API.
Как устроено
Docling обрабатывает документ в несколько этапов. Для обычного PDF он может извлечь текст напрямую, а для страницы-скана применить OCR. Отдельные компоненты определяют расположение элементов и восстанавливают таблицы. Полученные данные объединяются в объект DoclingDocument.
| Этап | Что происходит | Примеры технологий |
|---|---|---|
Анализ страницы | Определяются заголовки, абзацы, колонки, списки и порядок чтения | Модели определения структуры страницы, в том числе Heron |
Распознавание текста (OCR) | Текст извлекается из изображений и сканированных страниц | Tesseract, EasyOCR, RapidOCR, OcrMac и другие движки |
Обработка таблиц | Восстанавливаются строки, столбцы и объединённые ячейки | TableFormer и поддерживаемые модели для таблиц |
Обработка изображений | Изображения классифицируются; при необходимости создаются текстовые описания | Модели классификации и визуально-языковые модели (VLM) |
Формулы и код | Дополнительные модели помогают извлекать математические выражения и фрагменты кода | CodeFormula и другие поддерживаемые модели |
Экспорт | Результат сохраняется вместе со структурой документа | Markdown, JSON, HTML, DocTags и другие форматы |
Есть два основных подхода к обработке. Стандартный конвейер последовательно выполняет отдельные операции: определяет структуру, распознаёт текст и восстанавливает таблицы. Вариант с VLM (визуально-языковой моделью) анализирует изображение страницы целиком. Второй подход полезен для некоторых сложных макетов, но требования к памяти, скорости и оборудованию зависят от выбранной модели.
Docling поддерживает PDF, изображения, DOCX, XLSX, PPTX, HTML, Markdown, CSV и ряд других форматов. Для некоторых типов файлов и функций требуются дополнительные зависимости: например, LibreOffice для части старых офисных форматов, а для обработки аудио и видео — соответствующие расширения и инструменты. Полный перечень лучше проверять в документации Docling.
Результат можно получить в Markdown для чтения и поиска или в JSON, если нужно сохранить больше сведений о структуре документа. Для RAG предусмотрены средства разбиения текста на фрагменты с учётом заголовков и других элементов. Это помогает избежать ситуации, когда кусок таблицы или раздела теряет связь с исходным контекстом.
По умолчанию не все дополнительные функции включены. Например, распознавание формул, описание изображений и способ обработки таблиц настраиваются отдельно. Доступные OCR-движки и модели перечислены в каталоге моделей. Некоторые работают на CPU, другие эффективнее или доступны только на GPU. При использовании внешнего API документы или их содержимое могут передаваться выбранному провайдеру; при полностью локальной настройке этого не требуется.
Для командной работы существует docling-serve. Он предоставляет HTTP API, поэтому приложения могут отправлять документы на обработку без отдельной установки библиотеки на каждом компьютере. Для очередей и распределения задач можно использовать Redis и RQ. MCP-сервер позволяет вызывать обработку документов из ИИ-агента; подробнее о самом протоколе рассказано в материале Что такое MCP-сервер.
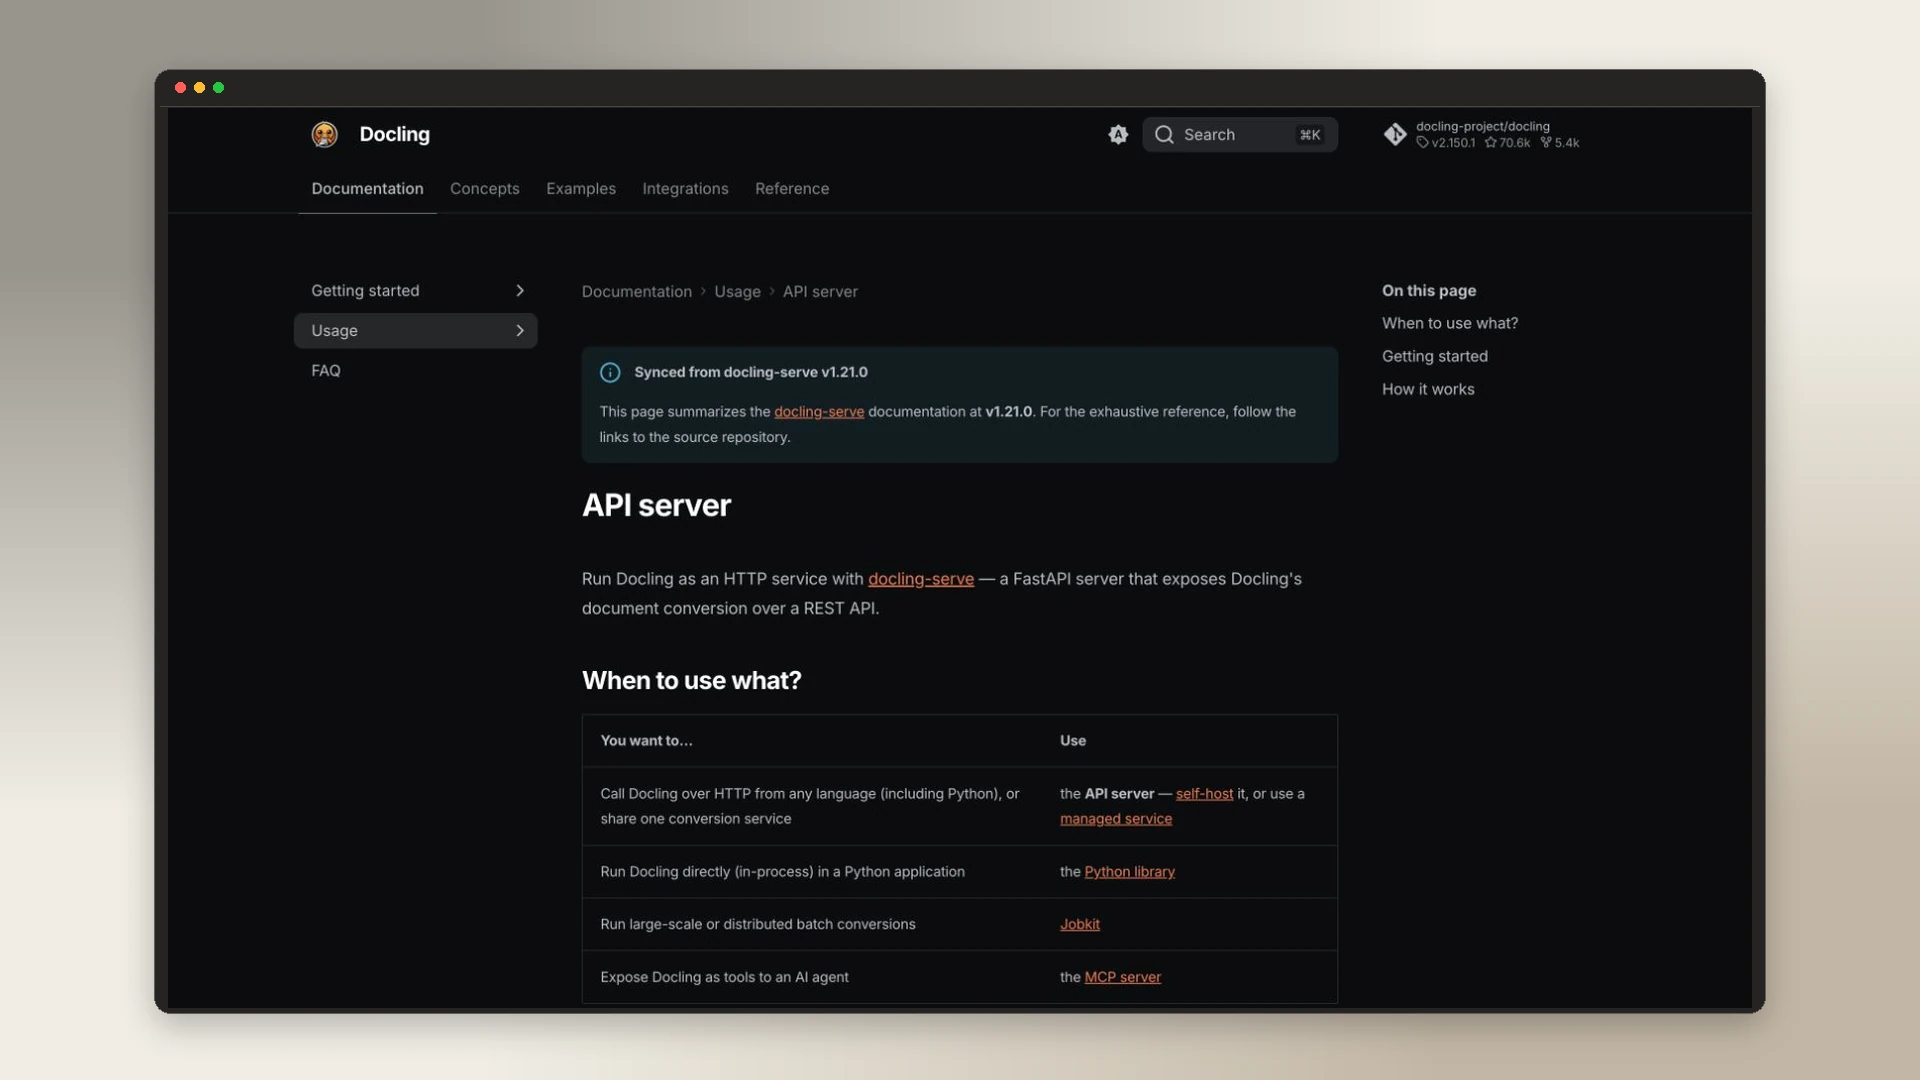
Когда использовать
| Ситуация | Что выбрать | Почему |
|---|---|---|
Нужно преобразовать один PDF в Markdown | Локальную библиотеку docling | Не требуется развёртывать отдельный сервер |
Нужно обработать скан на русском или другом языке | OCR с подходящей языковой моделью | Качество распознавания зависит от языка, качества изображения и выбранного движка |
В документах много таблиц и колонок | Стандартный конвейер с обработкой структуры таблиц | Сохраняется больше информации о связях между ячейками и блоками |
Документы содержат сложные формулы или графики | Дополнительные модели для формул и изображений | Обычного извлечения текста может быть недостаточно |
Несколько приложений должны обращаться к одному обработчику | docling-serve | Один HTTP API вместо установки и настройки на каждом компьютере |
Обработка идёт потоком и задачи могут занимать много времени | docling-serve с очередью задач | Очередь и отдельные обработчики позволяют управлять нагрузкой |
Если компьютер работает без видеокарты, разумно сначала попробовать стандартный конвейер на CPU. Более тяжёлые VLM-модели и некоторые режимы ускорения требуют подходящего GPU и совместимых библиотек. Перед массовой обработкой проверьте результат на нескольких типичных файлах: ошибки OCR и распознавания таблиц возможны даже при успешном завершении задачи.
Пример
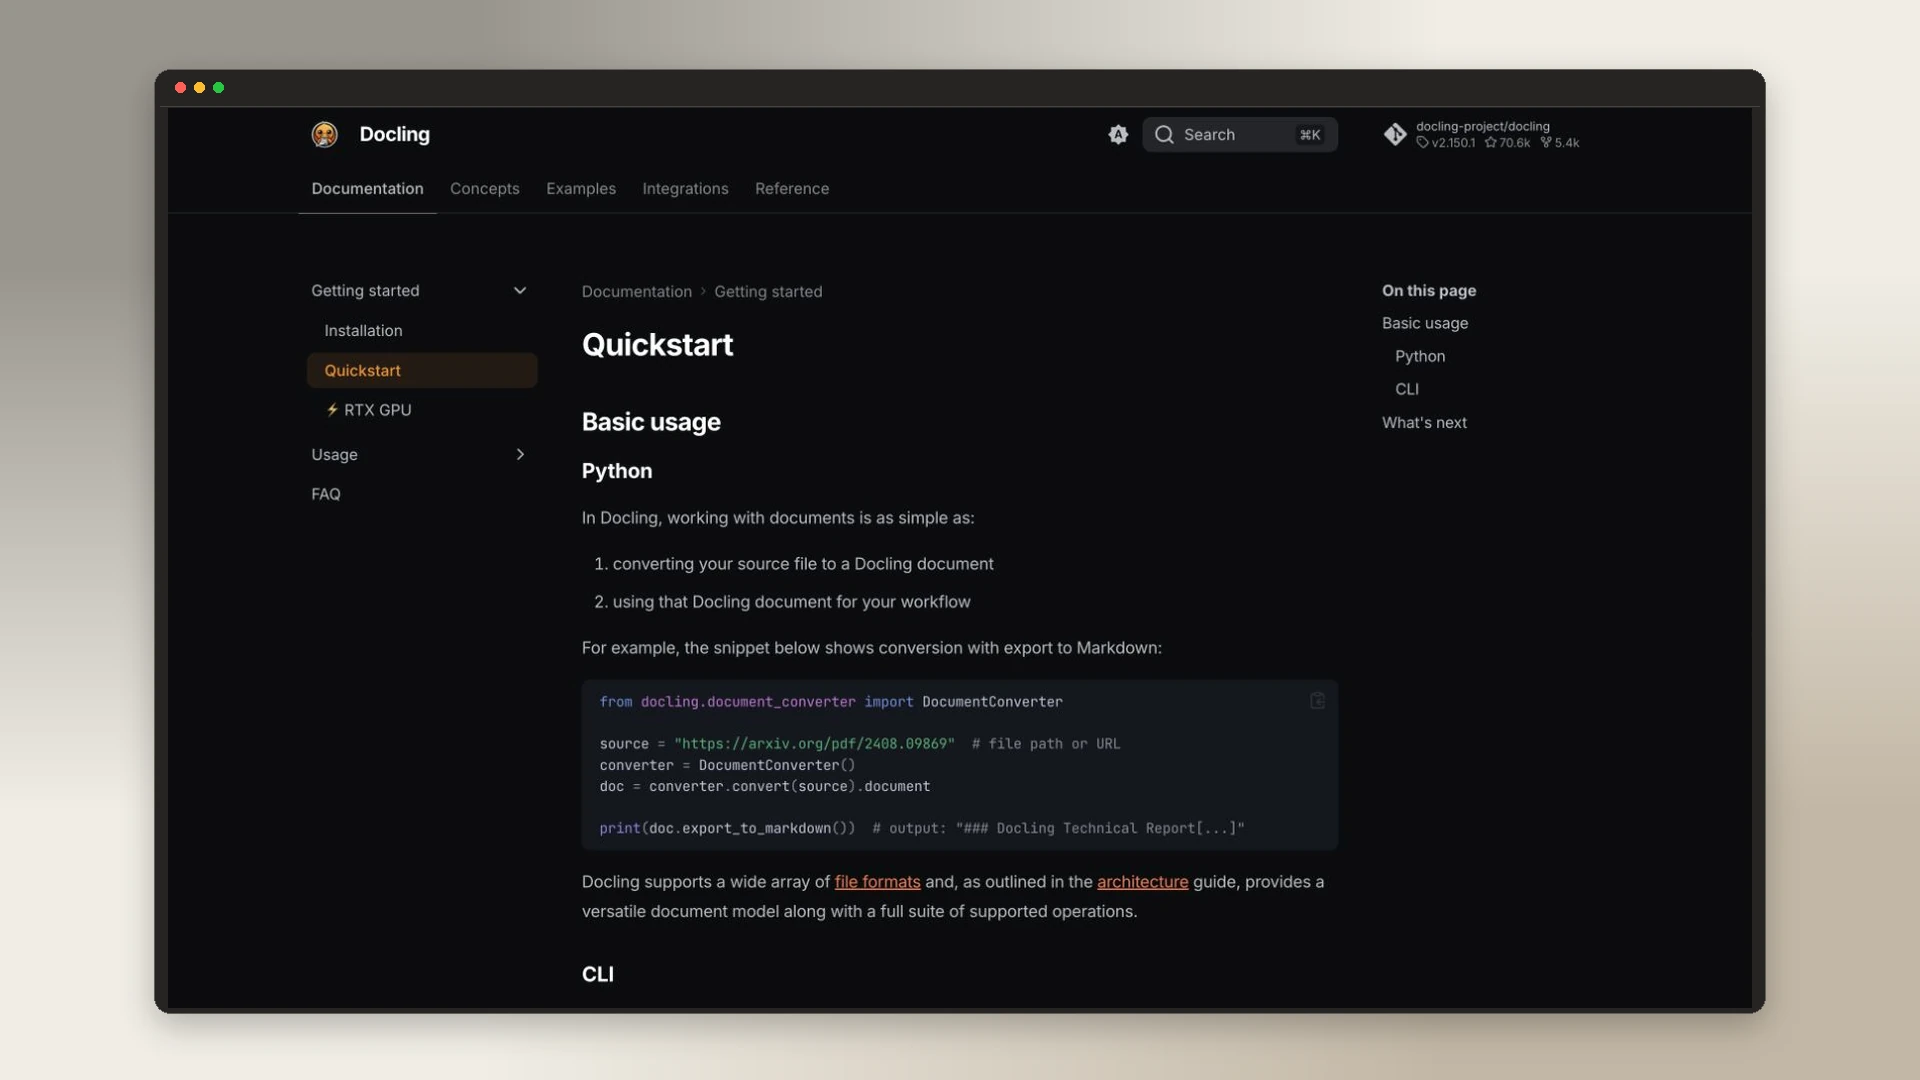
Начнём с локального запуска. Для установки библиотеки откройте терминал и выполните:
pip install doclingСледующий пример преобразует PDF в Markdown и отдельно сохраняет структурированные данные в JSON. Замените report.pdf на путь к своему файлу.
import json
from docling.document_converter import DocumentConverter

converter = DocumentConverter()
document = converter.convert("report.pdf").document

# Текст с заголовками и таблицами в Markdown
print(document.export_to_markdown())

# Структура документа в JSON
with open("report.json", "w", encoding="utf-8") as file:
    json.dump(document.export_to_dict(), file, ensure_ascii=False, indent=2)
Метод export_to_dict() возвращает словарь Python. В примере он дополнительно сериализуется в JSON и записывается в файл. При первом запуске Docling может загрузить необходимые модели, поэтому обработка займёт больше времени.
Если PDF состоит из сканов, можно явно выбрать Tesseract и указать языки распознавания. Для этого Tesseract и соответствующие языковые данные должны быть установлены в системе.
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions, TesseractOcrOptions
from docling.document_converter import DocumentConverter, PdfFormatOption

options = PdfPipelineOptions()
options.do_ocr = True
options.ocr_options = TesseractOcrOptions(lang=["rus", "eng"])

converter = DocumentConverter(
    format_options={
        InputFormat.PDF: PdfFormatOption(pipeline_options=options)
    }
)

document = converter.convert("scan.pdf").document
print(document.export_to_markdown())
Если Docling нужен нескольким приложениям, вместо локального запуска можно поднять docling-serve:
pip install "docling-serve[ui]"
docling-serve run --enable-ui
После запуска API обычно доступен по адресу http://localhost:5001, документация — по пути /docs, веб-интерфейс — по /ui. Альтернативный вариант — контейнер:
podman run -p 5001:5001 -e DOCLING_SERVE_ENABLE_UI=1 quay.io/docling-project/docling-serveПроверить обработку документа через HTTP API можно запросом:
curl -X POST http://localhost:5001/v1/convert/source \
  -H "Content-Type: application/json" \
  -d '{"sources":[{"kind":"http","url":"https://arxiv.org/pdf/2408.09869"}],"options":{"to_formats":["md"]}}'
Для больших объёмов задач docling-serve можно подключить к Redis и запускать отдельные процессы обработки через RQ. Параметры сервиса задаются переменными окружения DOCLING_SERVE_*. Если используются дополнительные модели, их нужно подготовить и сделать доступными сервису; они не обязательно входят в базовый образ контейнера.
Docling можно подключить и к Open WebUI. В настройках обработки документов выберите Docling и укажите адрес доступного HTTP-сервиса. Если Open WebUI работает в контейнере, localhost внутри этого контейнера не будет указывать на другой контейнер или на хост. Адрес host.docker.internal подходит для некоторых конфигураций Docker, но в других окружениях сеть нужно настроить отдельно.
Для первой проверки достаточно нескольких реальных документов: обычного PDF, скана и файла с таблицами. Сравните извлечённый текст с оригиналом, особенно в числах, таблицах и порядке абзацев. После этого станет понятно, достаточно ли локальной библиотеки или есть смысл развёртывать отдельный сервис.
Ссылки
- Документация: Docling Documentation
- Документация: Каталог моделей Docling
- Репозиторий: docling-project/docling
- Репозиторий: docling-project/docling-serve